最难的地方:不能先读出答案,再判断错没错
普通数字信息出错,可以多存几份,再按多数票判断。但要保护一个未知量子态,我们通常既不知道它是什么,也不能先把它完整测出来。直接读出存储比特的0或1,会破坏原先需要保留的叠加关系。
量子纠错的办法,是把这个未知态编码到多个物理比特共同构成的一个小子空间里。我们反复检查它是否偏离了这个子空间,并追踪偏离的线索。合适的检查可以告诉我们发生了什么类型的偏离,同时不告诉我们原先存的是哪个逻辑态。 这需要具体的编码结构和可纠正错误条件,不是任意测量都具有的性质。1
这里“局部”首先指量子操作和校验只连接附近少数元件。后面的经典解码,可以处理一大片区域和多轮历史,不一定是每个元件只凭邻居信息自行修好。把这两层分开,才能看清整体可靠性从哪里来。
我们以存储一个逻辑量子比特为对象,从一个容易算的重复码出发,进入能同时处理比特与相位错误的表面码,再看近年实验中真正改变保护效果的条件。
先用三比特例子,看懂“只问关系,不问内容”
把未知态编码为:
这不是三份各自完整的未知态。原来的振幅与相位,保存在一个联合态中。
我们检查第1与第2个比特是否相同,再检查第2与第3个是否相同。对两个组成分量000和111,这两个问题的答案都一样:相同、相同。因此在理想条件下,获得这两个关系的答案,不会分辨出 $\alpha$ 与 $\beta$。
如果第2个比特翻转,状态变成:
此时两个校验都报告“不相同”,但仍没有分辨出两项的振幅。根据这组结果,把第2个比特再翻转一次,就能恢复原态。1
| 假设最多发生一个比特翻转 | 校验1—2 | 校验2—3 |
|---|---|---|
| 没有翻转 | 相同 | 相同 |
| 第1个翻转 | 不同 | 相同 |
| 第2个翻转 | 不同 | 不同 |
| 第3个翻转 | 相同 | 不同 |
用算符说,这两个检查是 $Z_1Z_2$ 和 $Z_2Z_3$ 的联合测量。它们的本征值记录叫作错误综合征。物理实现可以让一个辅助比特依次与两个数据比特相互作用,把奇偶关系写入辅助比特,再读出辅助比特;并不要求直接读出每个数据比特。
但这个例子有一个决定性限制:它只保护比特翻转。若第1个比特受到相位翻转,状态变为 $\alpha|000\rangle-\beta|111\rangle$,两个校验完全看不见,逻辑相位却可能已经变了。把所有比特一起翻转,校验也看不见,而逻辑0和逻辑1已经互换。
所以,只展示重复码在一个方向上越做越好,还不能说明任意量子态都能越存越稳。
九个数据比特:两类局部校验共同保护一个量子态
要同时处理比特翻转 $X$ 和相位翻转 $Z$,需要两类相互兼容的校验。它们不能一类刚测完,另一类就把前一类需要保留的信息打乱。
表面码的一种安排,是让一组校验测若干邻近比特的 $Z$ 乘积,另一组测 $X$ 乘积。相交的两类校验以合适方式重叠,保证整体算符对易。所有这些约束共同留下一个逻辑子空间;局部错误可能改变附近校验的符号,逻辑信息却由跨越更大尺度的自由度承载。15
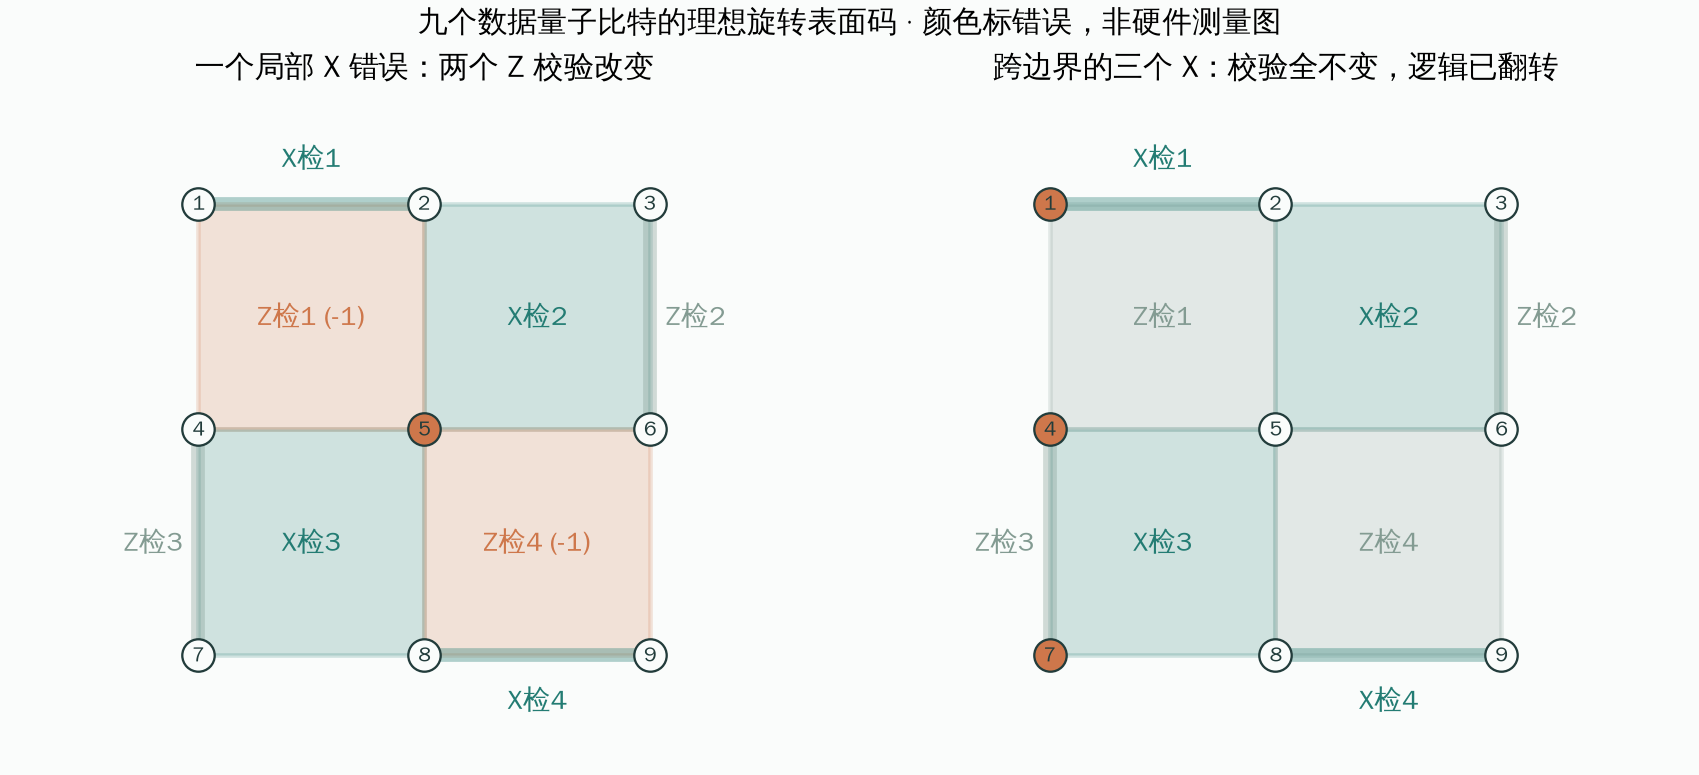
这个小码有八个独立校验。九个数据比特原有512维联合空间,八个独立的二值约束把目标子空间缩到二维,正好容纳一个逻辑量子比特。
本库对图中的具体校验进行了实际计算:先核所有校验相互对易,再核编码后的两个逻辑基态及其相位关系;随后枚举全部 $4^9=262\,144$ 种 Pauli 组合,确认最短的非平凡、又不触发综合征的逻辑操作重量为3。这个最小重量就是该码的码距。
我们还逐项验证了27种单数据比特错误——九个位置各自的 $X$、$Y$、$Z$——恢复后都保住了同一个任意振幅例子,并且对两个逻辑基态的恢复只相差共同整体相位。后一点很重要:只把逻辑0与1各自“存对”,却把两者的相对相位改掉,仍然不能算保护好了量子态。
码距3不等于可以可靠纠正三个未知错误。它保证理想条件下纠正任意一个数据比特错误;两处错误就可能与另一处单错误产生相同综合征,让解码选错。图中第一列的前两个比特同时发生 $X$ 错误,就可能被当作第三个位置出错,补上一次“修复”后反而完成了整列的逻辑翻转。
还有一种常见误会:真实误差是连续的小旋转,为什么只列离散的 $X,Y,Z$?以单比特 $X$ 轴小旋转为例:
理想综合征测量把无错分量和可辨别的错误分量分开,再分别恢复;需要保留的 $\alpha,\beta$ 可以随之保住。本库对 $\theta=0.2$ 的例子实际构造了测量分支和恢复后的密度矩阵,与初始编码态的最大元素差约为 $7\times10^{-18}$。这是理想有限例子的核验,不表示多轮相干误差在真实器件中都能当作独立随机翻转。
为什么还要一轮一轮地测:检查本身也会出错
上述校验被当成完美。但实际辅助比特、量子门、读出与复位都会出错。如果一次校验显示异常,就立刻认定附近数据比特坏了,可能把“读错一次”误当成“数据真的改变”,再引入新的错误。
因此,纠错通常比较多轮记录,关注综合征怎样变化。一个持久的数据错误与一个短暂的读出错误,会留下不同的时空线索。15
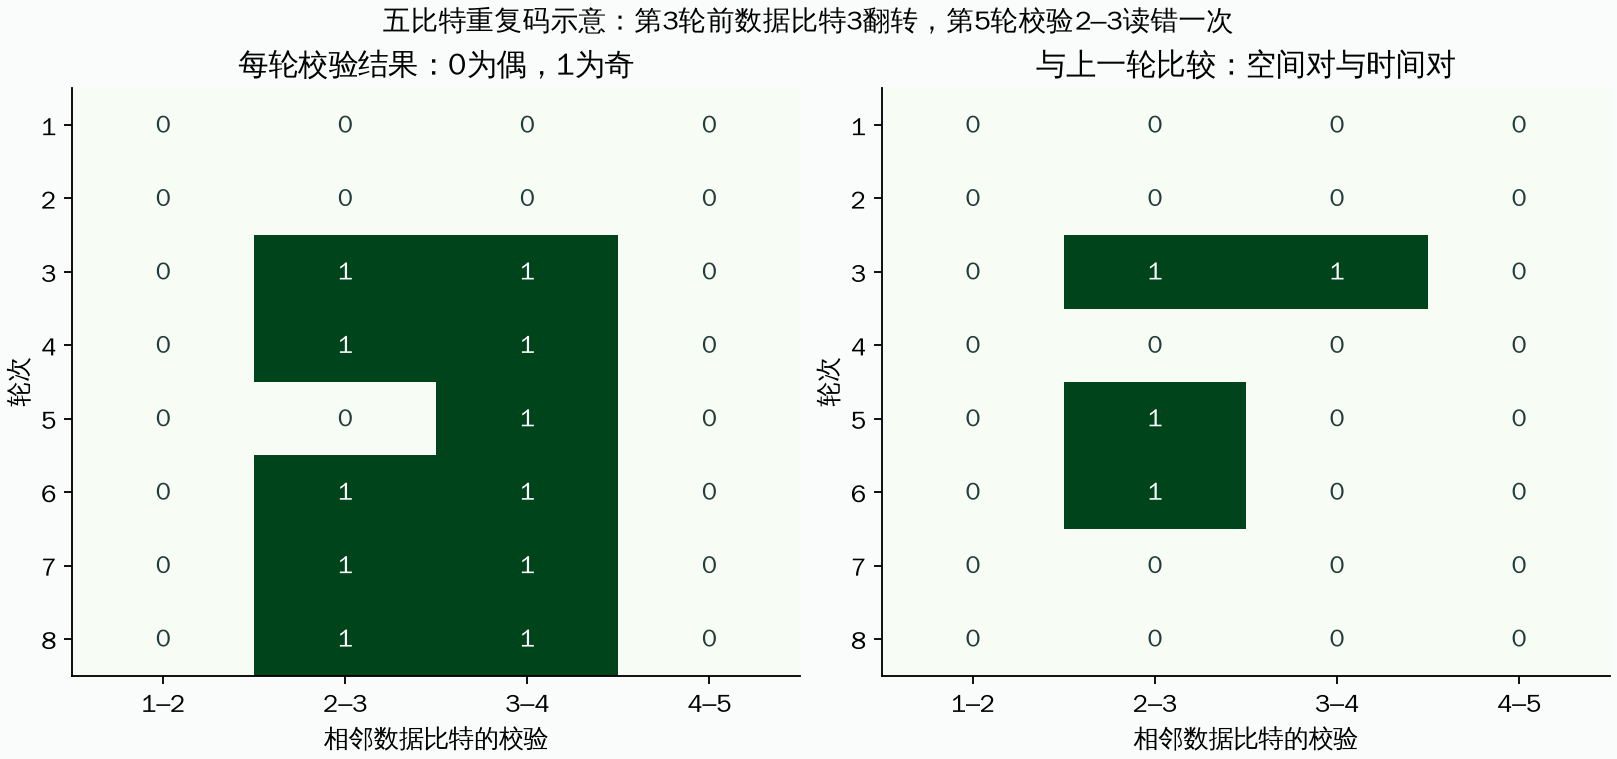
图中第3轮的一对变化,位于同一时刻、相邻位置;第5和第6轮的另一对变化,则在同一位置、相邻时刻。真实表面码把这类关系扩展到二维空间加时间。解码器根据电路传播规律、噪声先验和观测记录,寻找可能造成这些变化的错误过程。
它不必每次都还原出唯一的微观错误。如果两种错误只相差一个在逻辑空间中不起作用的校验操作,纠正其中任一种都可以成功。真正危险的是:所选恢复与真实错误合在一起,构成了一个改变逻辑信息的操作。
这也说明,解码质量不只看算法跑得多复杂。它依赖送进来的信息是否准确:哪些门容易错、读出偏差是否不对称、一个故障会传播到哪些位置、哪些相关事件经常一起出现。错误模型失配,会让同样的综合征被赋予不合适的解释。
平均每个元件都只有1%错误,为什么结果还能差很多
先回到只处理比特翻转的奇数重复码。假设每个数据比特独立以概率 $p$ 翻转,而且校验与解码理想,超过一半比特翻转才会让多数判断失败:
在 $p=0.01$、九个数据比特时,本库算得错误概率约为 $1.22\times10^{-8}$。冗余能起效,是因为少量局部错误常见,而大部分比特一起错十分少见。
现在只改变噪声结构:每轮以0.1%的概率发生一次全体翻转;没有这种事件时,各比特再独立以约0.9009%的概率翻转。这样,每个比特单独统计出来的错误率,仍恰好是1%:
但全体翻转不会改变重复码的任何奇偶关系。在没有额外告警信息的情况下,它直接互换逻辑0和1。九比特的总错误概率变成约0.001000007,也就是约千分之一,远高于独立错误例子。
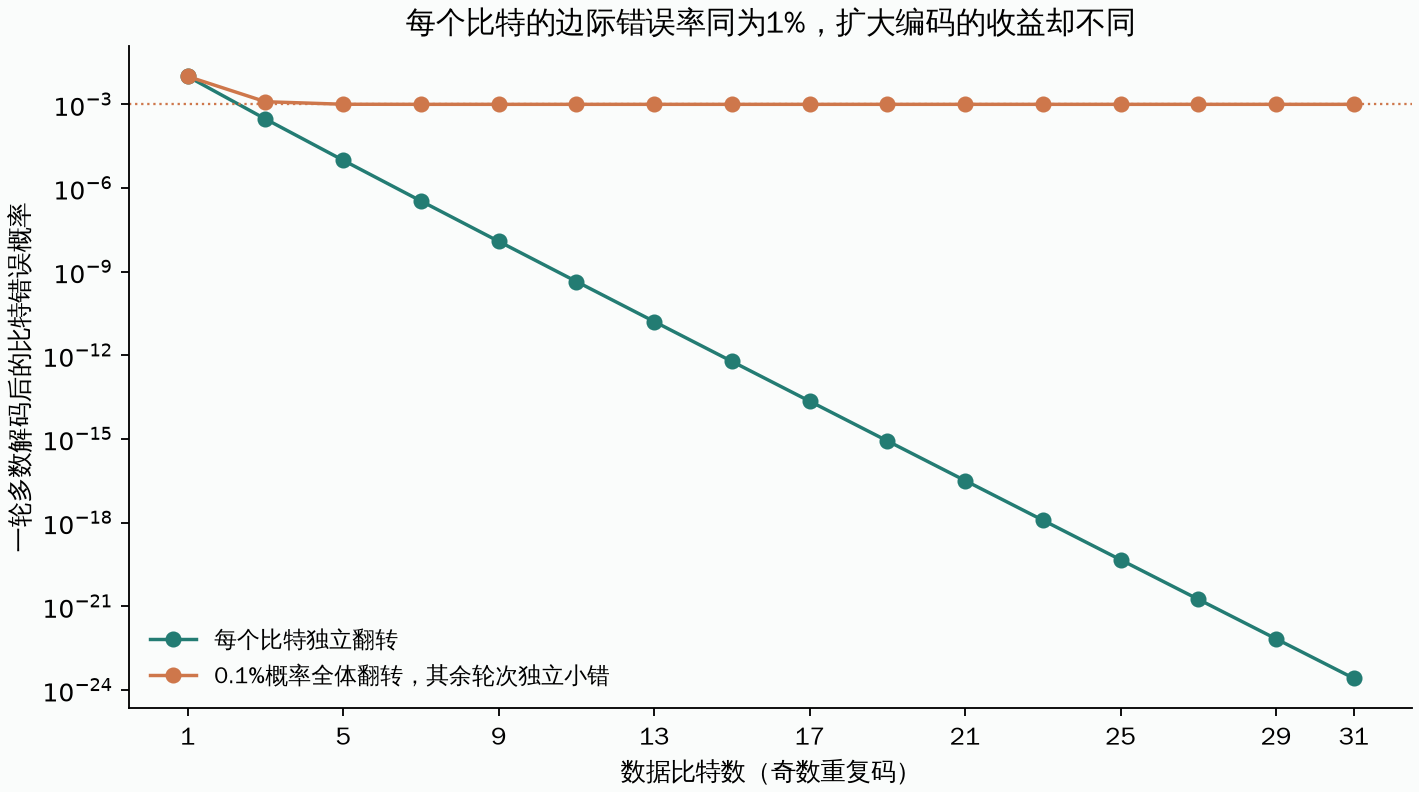
这不是说“只要有相关错误,纠错就无效”。已知形状、范围有限或有额外位置标志的相关错误,可能通过适合的编码和解码处理;足够弱、满足局域条件的相关噪声也可以处在容错理论允许的范围。上例强调的是:只报单个元件的平均错误率,丢掉了决定大规模联合错误概率的信息。
真实系统中还有一个区别:泄漏到量子比特的0/1计算子空间之外,不只是多发生了一个普通Pauli翻转。泄漏可能在后续相互作用中影响邻居,并持续多轮。让这种状态尽快回到可处理的范围,属于纠错循环能否工作的具体组成部分。
实验已经证明了什么:要连同码型、基底和解码条件一起读
Google团队2024年底在线发表、2025年进入卷期的Willow研究,展示了随表面码码距3、5、7增加而降低的逻辑存储错误。距离7的方案使用49个数据比特、48个测量比特和4个额外泄漏移除比特;不是用一个裸元件存住逻辑信息。2
研究反复准备逻辑 $X$ 或 $Z$ 基底态,运行不同轮数的校验,再结合解码判断最终逻辑测量是否正确。用离线神经网络解码器时,作者报告码距每增加2,拟合的每周期错误约降低2.14倍;距离7的平均每周期错误约为0.143%。这些是指定实验、基底汇总与拟合口径下的结果,不能直接拿来与本篇“九个数据比特、完美测量”的枚举数比较。
对机制更有帮助的,是移除数据比特泄漏的开关对照:它对较大码的收益更明显,逻辑错误抑制因子改善约35%,而校验异常概率只减少约12%。两个变化并不同步,提示异常的相关结构也在影响逻辑层表现。校验异常概率因此不能在任意噪声改变下,都当作唯一的硬件错误标尺。
同一论文还用很长的重复码追踪极低错误率下的稀有事件,发现空间相关的突发异常。它们的原因当时仍未确定,对表面码会造成多大影响也不能直接照搬。2026年作者更正明确把图3a误写的“表面码距离”改成“重复码距离”,并修正了图例。3
这项更正改变的是图的标注,不是宣布整个表面码结果失效;但它确实提醒读者,不能把重复码上的极低错误率或突发限制,直接当成同规模、同时保护两种基底的表面码实测结果。
2026年的另一项研究在IBM重六边形连接的处理器上,嵌入表面码。由于邻接方式并非表面码最直接的方格布局,校验需要适配路由和门序列。增加编码范围的同时,电路也可能变宽、变深,产生更多待机与出错机会。4
作者比较 $(d_x,d_z)=(3,3),(3,5),(5,3)$ 的方案。扩大一个方向,能够改善相应基底的保护,但另一方向未同步增强,额外电路负担仍可能伤害它。再加入针对待机窗口优化的动态解耦——用受控脉冲削弱某些缓慢变化或相干的扰动——不同规模的收益也不一样。
这给出了一个很具体的教训:比较大码和小码时,不能让大码得到适合的噪声抑制,却给小码留下可避免的劣势;也不能只看被加长方向上的那一种状态。该研究总体没有展示贯穿各轮次、明确独立于输入态的缩放收益,但保留了一个正向例外:ibm_marrakesh在较晚轮次出现整体收益的起始迹象,最后一轮达到作者所用的95%置信条件。它不应被抹去,也不等于已经有跨全部轮次和更大尺度的稳定结果。
这两项实验共同表明,整体信息保护来自编码、噪声处理、校验电路与解码的配合。不同硬件上的局部检查即使逻辑上相同,实际噪声和时间安排也可以使最终效果不同。
两种基底都测了,是否就完全知道量子态保护得怎样
保护任意态,还要关心不同方向上的错误是否一起发生。一个简短反例就能说明为什么缺失的测量需要模型补足。
考虑两种自选的单逻辑比特Pauli通道:
| 通道 | 无操作 $I$ | 仅 $X$ | 仅 $Z$ | $Y$ |
|---|---|---|---|---|
| 独立的X、Z翻转,各10% | 81% | 9% | 9% | 1% |
| 以10%概率只发生Y | 90% | 0 | 0 | 10% |
对逻辑 $|0\rangle,|1\rangle,|+\rangle,|-\rangle$ 四种输入,沿原基底读出的错误率,两组都是10%。但对 $Y$ 基底态,前者错误率为18%,后者为零;后者的 $Y$ 操作只给这些本征态一个整体相位。
本库把两个通道实际作用到Bell态的一半,并计算纠缠保真度,分别得到0.81和0.90。这里用Bell态作为完整量子信息的探针:存储过程不仅要让某几个已知状态看起来正确,也要尽量保留与另一个系统的量子关系。
因此,四个输入态表现一样,并不能无条件唯一确定任意通道的完整保真度。2026年重六边形研究确实讨论了这一缺口:由 $X/Z$ 数据推到纠缠保真度,需要逻辑错误通道的结构假设,并对不能直接确定的量给出相应界限。其补充材料明确使用独立逻辑 $X/Z$ 错误、振幅阻尼和循环可组合等条件。4
我们的反例说明这些条件为什么必要,并不反驳在这些条件下成立的推导。它也提醒:不需要拟合一条指数曲线,不等于完全不需要物理模型。
解码慢于一次校验,并不自动表示系统已经来不及
假设量子处理器每1.1微秒产生一轮结果,而解码要63微秒才返回。这看起来像是永远赶不上,但要分清两件事:持续处理新数据的吞吐速度,与一批数据进入后到答案出来的延迟。
流水线可以同时处理多批数据,因此延迟长于一个周期,仍可能不让积压持续增长。Google在距离5方案中展示的平均63微秒解码延迟,就属于这种情况;该实验不是把距离7的最高精度结果与实时反馈混成同一次演示。2
对存储实验,纠正也不一定要在每一轮立即施加一个物理翻转。可以在经典端记录应当怎样解释量子态或最终测量,这通常称为Pauli框架。后续操作允许追踪时,保留这个记录就能避免额外的物理纠正门。
但需要根据逻辑测量结果选择后续操作时,答案最终仍必须及时到达。长期吞吐不足会积压,过长延迟则拖慢依赖反馈的操作。上述实验当时尚未实现把解码结果反馈进逻辑电路;实时解码是必要环节的进展,不能省略反馈这一环。
可靠性来自什么,边界又在哪里
这条机制链可以连起来了:编码让目标信息处在有约束的联合空间;局部测量产生关于偏离的线索;反复测量帮助区分数据与读出故障;解码把时空记录解释成恢复或框架更新;硬件控制和泄漏处理让残余噪声保持在这套方法能够应付的范围。
扩大编码之所以可能有用,是因为改变逻辑信息需要跨越更大的错误组合,而局部小错可以持续被辨认。但这一收益并不只由元件数量决定:相关突发、相干积累、测量电路传播、路由开销、未测基底以及解码失配,都可能改变关键概率。
本篇的有限例子完成了理想编码和信息推断环节的实际核验,没有运行带全部门故障的表面码电路,也没有重分析Willow原始综合征或重跑IBM实验。相应器件研究提供的是在特定编码、控制和解码条件下的实证,不能由此填满所有未来噪声情形。
对“不断出错的局部元件能否保住整体信息”,已有条件明确的理论与实验支持。下一步最有判别力的证据,是在同一任务和时间口径下,改变噪声结构、编码方向、校验质量和解码条件,检查保护收益是否仍然存在。整体可靠性是一种持续实现的过程,而非给某块器件贴上的永久属性。
可回查:全部计算结果、九比特码Pauli枚举、完美校验下的选定噪声结果、同平均错误率对照、逐轮校验记录、四状态信息缺口。