约束与权衡14 分钟

分子机器怎样排除错误,又付出多少时间和能量?

分子校对靠结合、构象变化和反应速率之间的竞争,让错误更容易退出。它会增加重做和化学资源开销,但整段任务是否变慢,还取决于未清除的错误会造成多长停顿。本文结合人类聚合酶结构与动力学、2026年的速度选择研究,复算公开测量和带误删的重做模型,区分局部速率、整体活性、最终错误率与耗能,并核对实验代理和共同分母的限制。

多检查一步,整个过程就一定更慢吗?

复制一条分子链时,机器不是只做一次选择。它要不断接入原料、形成连接、移动到下一位置,还可能停下、退回、切掉一部分再重做。

因此,“检查花了时间”和“整个任务变慢了”是两句话。如果接错一个位置,会让后面的工作停很久,那么花一点时间拆掉错误,可能反而更快到达终点。

2026年Ravasio等人的研究把这个问题与校对的演化联系起来:在一些包含错配后停顿的模型中,仅仅让复制更快,就能使校对机制受到选择,同时降低错误率。作者也将预测与既有聚合酶数据比较。1

这是一条值得理解的形成路线,但需要分开三件事:分子怎样排错、排错是否节省总时间,以及自然演化是否实际走过这条路线。 前两件可以通过结构、动力学和模型逐段检查,第三件不能只靠当前机器工作得好就倒推出历史。

分子并不先知道答案,再决定纠错

聚合酶没有一个在反应之外观看答案的检查员。正确和错误的原料,都可能碰到机器、短暂结合,甚至形成连接。它们的差别体现在物理过程里:停留多久、构象能否闭合、是否容易进入下一反应、已经接上的末端是否适合继续延伸。

想象两个原料都到达一个岔口。一个方向是继续反应,另一个方向是离开。如果错误原料更容易离开,它进入产物的机会就更小。再增加一个可以拒绝或回退的阶段,有机会继续放大这种差别。

这不是把“检查次数”机械地乘起来。第一次结合与后续反应之间,要有合适的速率配合,还需要维持化学驱动,避免反向路径把排除掉的错误重新补回来。正确原料也可能被拒绝;检查太慢或太频繁,会让它同样陷入循环。2

所谓动力学校对,重点就在这种不同原料经历同一反应网络,却有不同的通过、退出和重来概率。结合能差只是可能的识别来源之一,整个网络怎样使用差别同样重要。

2012年的研究已经指出:可以存在一种工作范围,让正确底物比较顺利地完成,错误底物更多地回退;没有必要让两者都反复兜圈。2017年的研究进一步允许每一步的正确、错误速率分别不同,发现速度与准确率的冲突只出现在部分参数范围。23

所以,2026年工作的价值,不在于首次发现两者有时可以一起改善,而在于把错配后的停顿、全程速度与校对形成的选择压力联系得更直接。

已经接错以后,机器怎样把末端送去修剪

人类主要参与前导链合成的Pol ε,同时具有聚合和外切校对功能。两个活性位置并不重合,相距接近4纳米;已经接错的链末端需要从一个位置转移到另一个位置。4

2024年的冷冻电镜研究在含错配末端的复合物中分出了四类构象。把它们与结构关系和功能证据放在一起,可以理解这样一条候选过程:

  1. 错配位于刚刚接入的位置,机器不容易保持适于下一次合成的闭合状态。
  2. 链末端从聚合位置撤开,进入不适于继续延伸的状态。
  3. 新合成链的末端与模板局部解开,露出可被修剪的一端。
  4. 进一步回退和位置调整,把末端送入外切酶活性位置。

这说明,“停下来”可以与“准备修剪”在同一套运动中相联系。错配改变了后续道路的可达性,校对通路有机会在继续延伸之前接管。

但这四类冷冻结构不是对同一台机器拍出的连续电影。它们支持转移路径的结构解释,并不直接给出每一步等待多久、多少机器按这一顺序经过,或剪切后怎样返回合成的完整时间分布。原文使用的复合物和捕获条件,也需要与正常工作的复制装置区分。

此外,不是所有聚合酶都有这套修剪能力。下面的人类Pol α实例,本身缺少内在校对,却同样会在接错后受到延伸障碍;它适合用来检查“错误怎样拖慢后续反应”,不能把Pol ε的修剪过程直接移植给它。

“慢了多少倍”,必须先说清测的是哪一步

2022年对人类Pol α的研究,同时检查了末端错配的结构、底物结合与下一步延伸。对于一种T-C错配,原文表中给出的饱和催化速率约为每秒0.492,相同口径的匹配末端约为每秒18.7;两者相差约38倍。5

但若比较低浓度下的催化效率,差别接近249倍。原因是错配不只改变催化本身,还改变对接下来所需原料的有效亲和性。原料是否充足,会改变哪一环更限制总体速度。
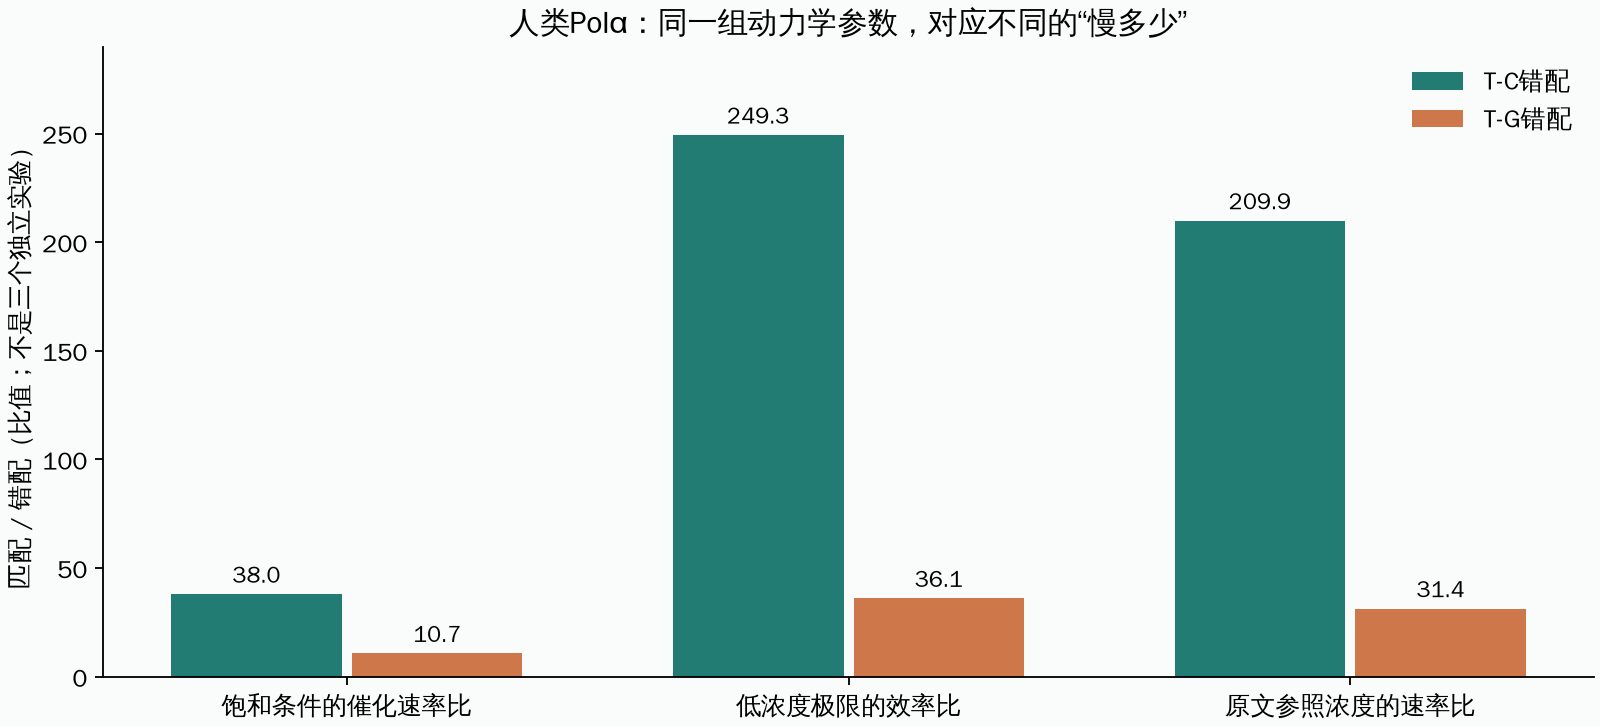
按2022年原表显示的参数重算。三类比值分别是饱和催化速率、低浓度效率及原文参照浓度下的速率比,来自同一组参数,不是三个独立实验。T-C与T-G是两类末端错配;本图没有拟合新的动力学数据。

原文用饱和曲线描述观测速率:

$$ k_{\mathrm{obs}} =\frac{k_{\mathrm{pol}}[S]}{K_D+[S]}. $$

这里的$[S]$是下一步所需底物浓度,$K_D$是该拟合口径中的表观常数。它不能与聚合酶和整段DNA之间的结合常数混成同一个量。

用公开表的显示值,在原文参照浓度下,本库得到T-C错配约210倍的延伸速率差;正文采用舍入后的两个速率相除,写成206倍。两种口径均保留,不能宣称本库精确重现了未公开的未舍入拟合。

这个例子还揭示一个不那么直观的事实:错误结合得更牢,也可能更难继续工作。 在没有下一步底物的一组条件下,Pol α对错配DNA的结合反而更强;加入相应底物后,匹配与错配复合物的稳定性又发生不同变化。5

因此,“黏得牢”“催化快”“容易被修剪”和“最终准确”并不是同一条刻度。要理解一台分子机器,必须知道每个读数属于哪个状态和哪条通路。

全程时间怎样算:错误的代价也要进入账本

一个简化的时间预算可以写成:

$$ \langle T\rangle \approx L\,t_{\mathrm{process}} +L\,\mu_{\mathrm{out}}\,\tau_{\mathrm{stall}}. $$

第一项表示处理$L$个位置所需的时间,包括检查与重做;第二项表示仍被保留的错误所造成的额外停顿。在这种简化里,停顿发生在校对完成之后,不再反过来影响是否修剪。

若一种变化降低了最终错误率,它是否节省时间,取决于增加的处理时间,能不能被减少的停顿抵消。只报“检查每次多用了几毫秒”,还不能回答整条链是否复制得更快。1

这里还有一个更重要的条件:真实机器可能在停顿期间回退、修剪。此时,最终产物中的错误很少,不代表机器途中很少接错。很多错误曾经造成停顿,随后又被清除了。

因此,至少要区分最初接错的概率和最后留下错误的概率。测序或终点突变率主要约束后者,不能独自还原中途花了多少时间。2026年接受稿和可取得的较早预印本,都讨论了允许停顿后修剪的扩展;两版的完整推导与表述并不完全相同,本篇不把早期附录直接冒充最终发表版附录。11a

一个完整走完的例子:允许修剪,也允许误删正确结果

下面用本库自选的四状态模型,把一次尝试到一次完成算到底。它保留四件事:接入原料、等待前进、转去修剪、修剪后重新尝试。

每次接入有5%的概率出错。这是便于看清差异的示意值,不是人类复制错误率。正确末端的前进速率设为1;慢停顿情形下,错误末端的前进速率设为0.001。错误可以以速率$h$进入修剪,正确末端也会以$0.01h$被误送去修剪。接入和修剪都需要时间。

在错误末端,前进与修剪同时竞争。因此,修剪先发生的概率是:

$$ P(\text{先修剪}\mid\text{错误}) =\frac{h}{h+k_W}, \qquad \langle t_{\text{岔口}}\rangle =\frac{1}{h+k_W}. $$

两条通路竞争时,等待时间由速率之和决定。不能把最终走修剪路的对象,全都当成先单独等待$1/h$,再把另一条路另算一遍。

若一次尝试完成的概率为$p$,一次尝试平均花费$d$,失败后回到相同起点,那么:

$$ \langle T\rangle=d+(1-p)\langle T\rangle =\frac{d}{p}. $$

这把重复接错、修剪后重新接入、以及误删正确结果都纳入了同一个过程。本库还独立建立吸收马尔可夫模型,核对完成时间、分支概率、修剪次数与有限时间内完成的比例。

示意条件 平均完成时间 最后保留错误的概率 每完成一步消耗的活化单体数
错误会慢停顿;不修剪 51.95 5% 1
错误会慢停顿;$h=0.1$ 2.68 约0.0521% 约1.053
错误会慢停顿;$h=1$ 2.24 约0.00531% 约1.063
错误会慢停顿;$h=100$ 5.32 约0.000105% 约2.105

增加适量修剪,确实多消耗了物料,却省下大量停顿时间。继续加强修剪,错误还可以更少,但正确末端也越来越容易被拆掉,完成时间重新增加。
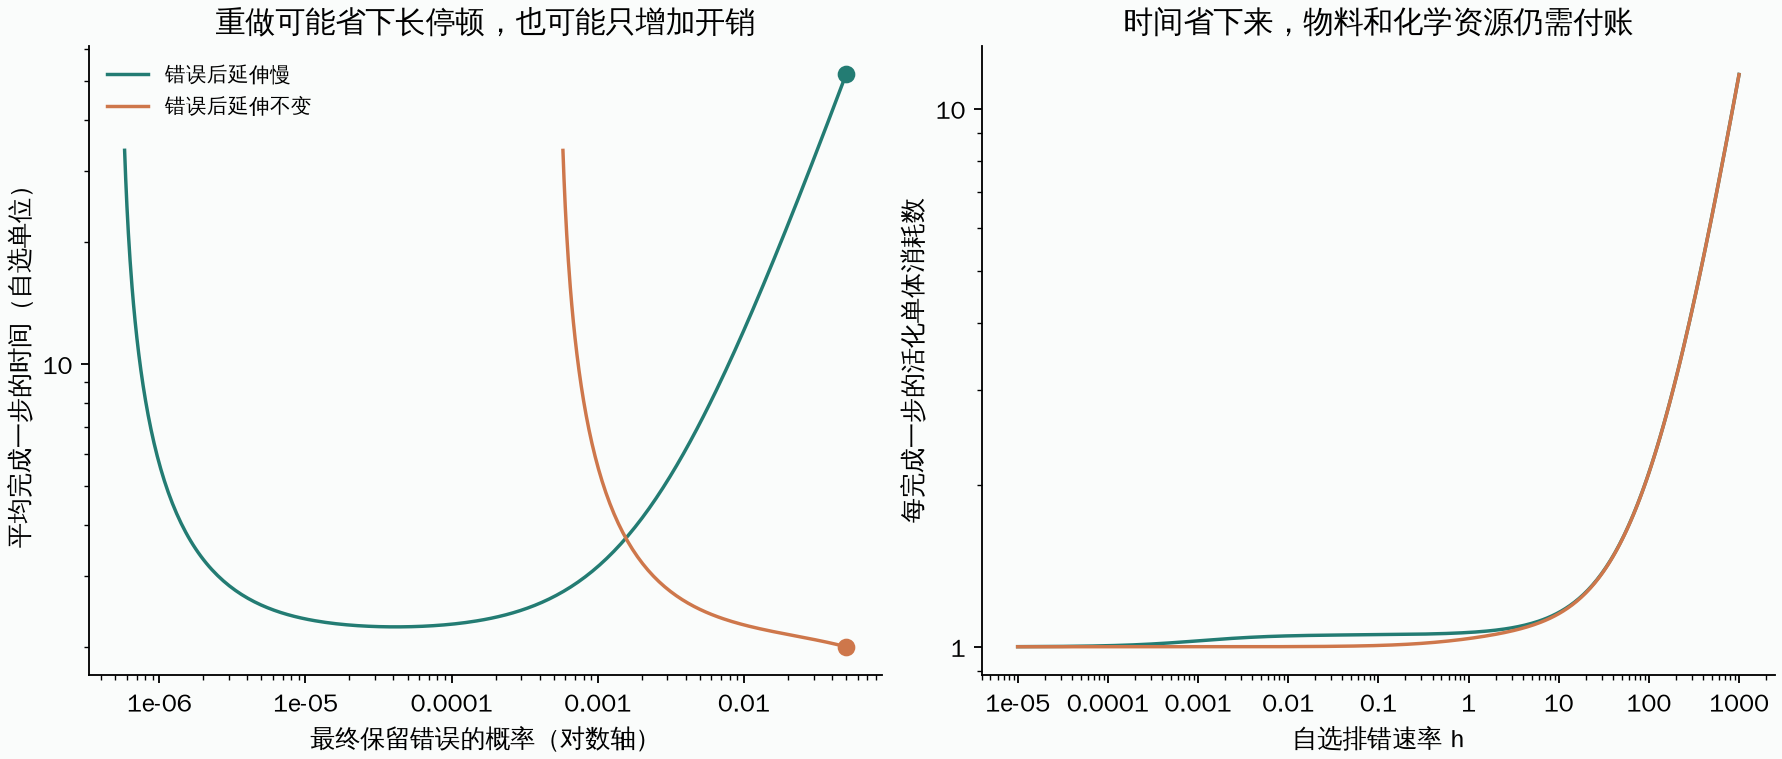
本库自选模型,全部参数与计算可回查。左:最终错误率与平均完成时间,圆点表示不修剪。右:每次完成所需的活化单体数。两条曲线只改变错误末端前进是否变慢,其余假设相同;时间单位和参数均不是实验标定值。

作为对照,如果错误末端与正确末端一样容易继续前进,不修剪时平均时间为2;同样增加修剪,就不能从“避免长停顿”中收回时间开销。

这也说明,决定收益的不只是检查有多认真,而是错误落在哪个环节、能否被移走、修剪本身是否缓慢,以及正确结果会不会被一起拆掉。

省时间,仍然可能多耗化学资源

上述模型每次重新接入都消耗一个活化单体。若平均每完成一步要丢弃$C$个已经接入的单体,消耗数就是$1+C$。这只是清楚定义过的物料账,不是直接量到的发热量。

真实校对的化学代价,要沿实际反应来算。DNA聚合、外切修剪和重新合成,与翻译中的GTP水解不是同一种账目;不能统一写成“每检查一下都消耗一个ATP”。2017年的模型用净修剪通量相对于产物通量来定义额外循环成本,并保留逆向速率,使每圈的化学驱动力有限。3

若要从循环次数进一步算化学自由能消耗,还需要各反应的化学势差和净通量;若要算热量或熵产生,还需要说明系统边界、产品中储存的自由能和稳态条件。耗能速率、每个完成产物的耗能,也不能混用。

2026年的“只选择速度”模型,在允许非平衡驱动发展的参数范围内,可以出现更高准确率与更大耗散。作者还考察了给耗散加代价的情形:代价足够大时,速度优势未必支持那样的校对水平。1

所以,这条路线不承诺免费获得准确性。它说明的是:花费额外资源所换来的好处,除了少出错,也可能包括少等很久。

那213种聚合酶,实验究竟支持了什么?

2026年论文复用了2018年研究中的聚合酶变体数据。本库取得2018年出版表和后续作者整理表,逐项核对相关单元格,保留317条配对测量;它们对应213种变体,不能把317当成317种独立机器。66a

图中的纵轴是质粒拷贝数的倒数。拷贝数高,可以反映整体复制活性较高,但它还涉及连续合成能力、细胞状态和系统稳态;倒数并没有自动变成以秒计的整条链复制时间。
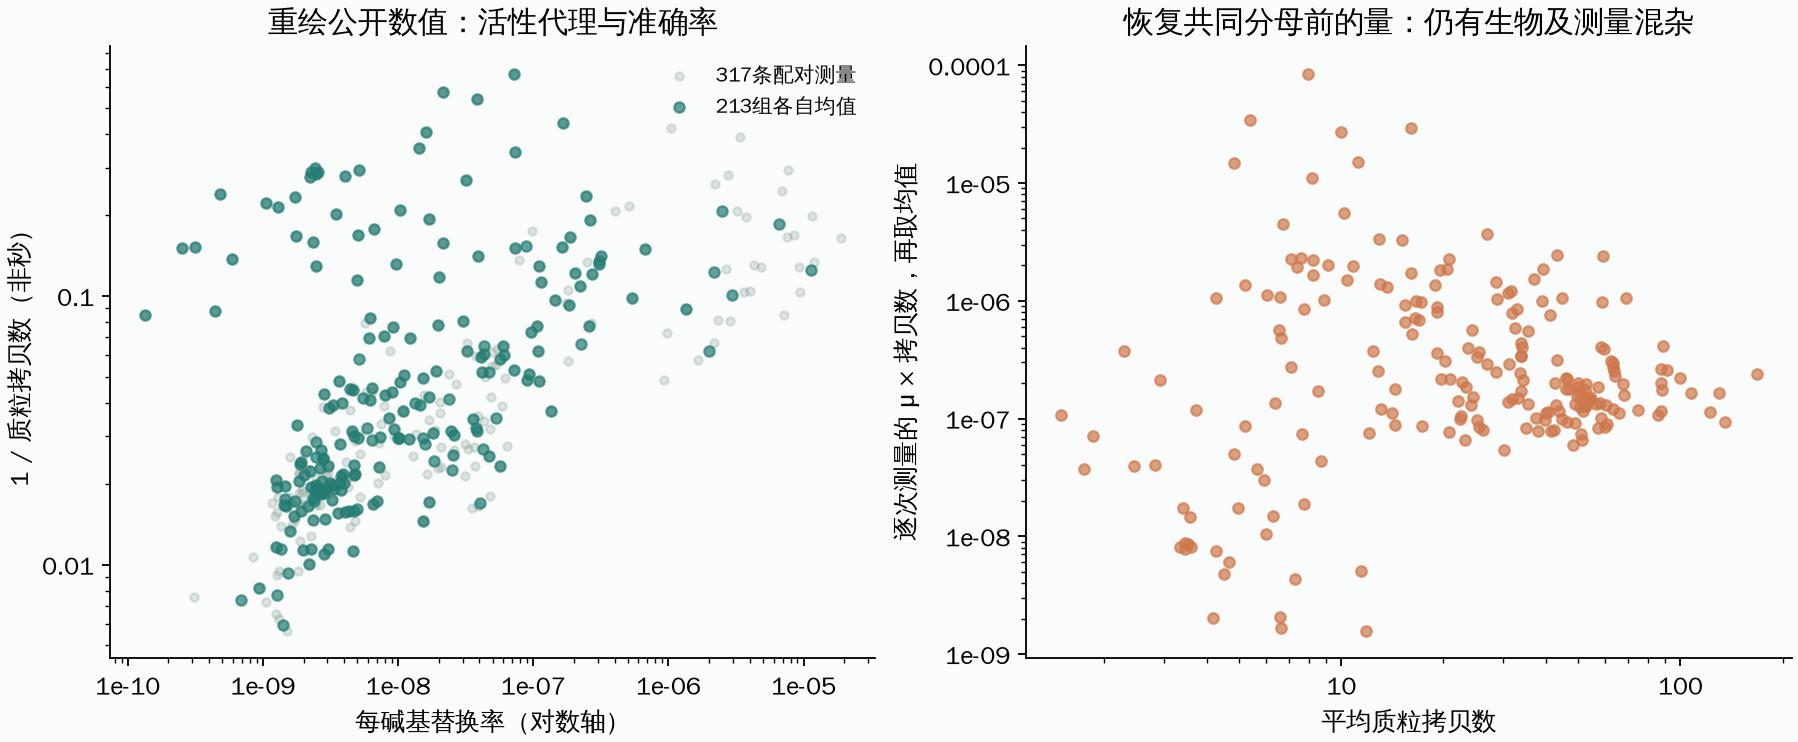
重绘公开数据,浅点为317条测量,深点为每种变体的描述性算术均值。右图恢复逐次μ×拷贝数后的量,再按变体取均值,用于查看指标关系;它改变了所问的量,并非已经排除混杂。原表有部分区间不包含点估计,原值及标记保留,图中未将其作为有效置信区间使用。

这组数据可以作为“较高活性与较低错误率在一些变体中可以并存”的支持。它还不能唯一确定这种关系就是由减少停顿造成。2026年作者也明确区分了同向变化与停顿机制的直接确认。1

核对原始测量方法时,还需要注意共同分母。2018年研究先估计表型回复突变率,再除以测得的质粒拷贝数等因子,换算为每碱基替换率。6

把其余换算后的分子记为$N$,拷贝数记为$C$,就有$\mu=N/C$。如果把$\mu$与$1/C$画在一起,两轴都包含$C$。这不是说按拷贝数归一化做错了;正确的暴露量校正本来就需要这样做。问题在于,随后解释两个派生指标之间的相关性时,不能忽略这种联系。
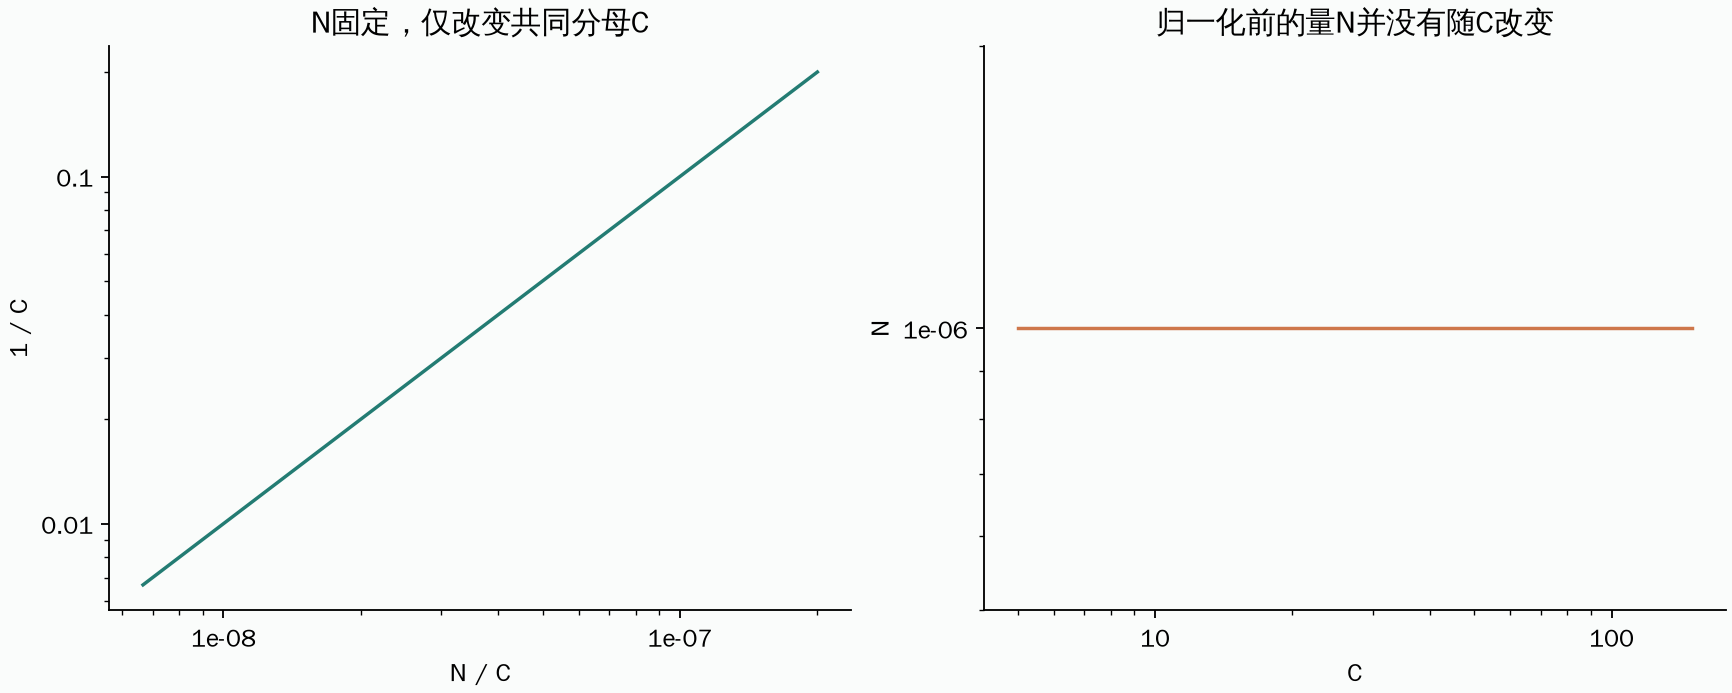
纯代数示例,全部数字自选:N固定、C改变时,N/C与1/C也会同向变化。它说明共同分母可以贡献相关性,不表示真实实验全部由这个原因造成,也不是对实际测量误差的拟合。

此外,这些变体来自不同筛选阶段,部分重复测量跨越不同时间;它们不是从所有可能的聚合酶中随机抽出的样本。图上没有出现某类点,不能独自证明所有允许的分子变化都无法达到那个区域。

更强的机制检验,需要把活性、错配后的等待、进入修剪的概率和最终错误放在兼容的测量条件下比较;还应检查表达量、持续结合能力、底物可用性等变化是否解释同一组结果。仅把终点相关性画得更漂亮,并不会补上这些环节。

从当前机制,到形成历史,还差哪一步

本篇较稳的物理理解是:正确与错误底物会进入不同的动力学竞争,错配能妨碍后续反应,校对可以移走这类障碍;付出的时间、资源和最后获得的准确率,需要按全过程计算。

模型支持的进一步判断是:当避免停顿的收益足够大、误删和重做的开销适当,校对可以同时提高准确率和完成速度。若速度影响复制者的增殖,这就提供了一种选择校对的可能原因。

尚不能由此确定的是,具体自然体系最初就是为了速度形成校对,准确性后来才获得功能。2026年作者也把“只选择速度”作为揭示机制的理论设置,并不要求把它当成自然演化唯一的真实情境。1

如果停顿本身容易被其他变化解除,修剪耗时很长,资源很紧张,或更快复制带来别的功能损失,结果都可能改变。停顿在多大程度上是结构约束、在多大程度上可以演化,也是原研究明确留下的问题。

这使“分子机器为什么愿意多走回头路”成为一个有条件、可检验的问题:回头路付出的代价,与它绕开的障碍有多大,必须放在同一段过程里比较。

可回查:全部计算结果、原测量配对表、各变体描述性均值、人类Polα动力学参数与比值、自选重做模型、共同分母示例。

来源与依据

  1. S1 原始动力学/模型演化及既有实验数据比较

    Evolution of error correction through a need for speed

    Riccardo Ravasio, Kabir Husain, Constantine G. Evans, Rob Phillips, Marco Ribezzi-Crivellari, Jack W. Szostak, Arvind Murugan · 2026

    Science391,818–824,2026-02-19;UCL公开接受稿18页 · 相关全文已核

    主文模板复制/Experimental evidence、Fig1/2/4、Discussion;Methods S1–S3及扩展图S2/S7相关说明

    实际核校对时间/停顿、单纯速度选择、活动代理、化学资源及耗散代价。接受稿不含全部Supplementary Text;发表附录403后另取较早s1pre,未冒充最终附录。Fig2a图注写延伸错配/匹配速率,但大于1的减慢倍数应按匹配/错配解释,本篇量化直接回s5。未重跑随机网络演化、原数据也非新采实验;主文明确速度选择为理论设置而非唯一历史。

  2. S1PRE s1较早预印本及长附录,非独立证据

    A minimal scenario for the origin of non-equilibrium order

    Riccardo Ravasio, Kabir Husain, Constantine G. Evans, Rob Phillips, Marco Ribezzi, Jack W. Szostak, Arvind Murugan · 2025

    v3,2025-01-05;标题/附录与2026接受稿不同 · 相关全文已核

    附录1.1.2停顿近似、1.2.3替代机制、1.3拷贝数代理、1.4参数扰动/既有文献

    扩展条件、可变停顿和校对开销均有不同结果;低错率/等条件首达时间等近似不当一般恒等。未采用其竞争通路时间加权公式作本库数值:本库另从等待1/(各出口速率和)建立可反复重来的CTMC与更新方程。早版全部附录取得但未全部逐段读,不继承为最终发表推导。

  3. S2 原始校对网络理论及领域机制入口

    Speed, dissipation, and error in kinetic proofreading

    Arvind Murugan, David A. Huse, Stanislas Leibler · 2012

    PNAS109,12034–12039;PMC3409783 · 相关全文已核

    Introduction、Hopfield scheme、广义网络、梯形模型与三工作区的Results相关段

    驱动循环放大识别差,正确/错误可处不同回退区间;不将两步总能达到平方差当普遍定理。附录PDF未取得,未复算完整梯形渐近式,本文只使用主文机制与工作范围结论。

  4. S3 原始有限速率校对及首达时间理论

    Elucidating interplay of speed and accuracy in biological error correction

    Kinshuk Banerjee, Anatoly B. Kolomeisky, Oleg A. Igoshin · 2017

    PNAS114,5183–5188;PMC5441828全文和内嵌SI · 相关全文已核

    网络Fig1、Eq1–4、T7参数TableS1与Results/Discussion;SI S2–10和Cost of proofreading S20–21/Pareto入口

    误率定义PiW/PiR不同于错误在全部产物中的概率,条件首达时间tauR不同于本库无条件完成时间。有限逆速率维持有限化学驱动;实际T7不同末端延伸速率已含障碍,2026非首次理论允许速度准确同向。本篇没有重跑该完整网络或全Pareto优化,不使用其结果断言真实生物必然只优化速度。

  5. S4 原始人类聚合酶复合物冷冻电镜与功能研究

    Structural basis for processive daughter-strand synthesis and proofreading by the human leading-strand DNA polymerase Pol ε

    Johann J. Roske, Joseph T. P. Yeeles · 2024

    Nature Structural & Molecular Biology,2024;PMC11638069全文 · 相关全文已核

    引言13–15、Results四构象44–76及Discussion84–86相关段,Fig3/4/6图注

    聚合/外切位点近40Å,四构象支持末端撤出、解开和回退的候选路径;不是同分子连续时间轨迹,不能由构象比例直接求真实速度。捕获复合物及核苷酸条件不同于完整活体复制装置;未重分析cryoEM原数据或读取全部Methods。

  6. S5 原始人类Polalpha错配结构/结合/动力学测量

    Structural and functional insight into mismatch extension by human DNA polymerase α

    Andrey G. Baranovskiy, Nigar D. Babayeva, Alisa E. Lisova, Lucia M. Morstadt, Tahir H. Tahirov · 2022

    PNAS119,e2111744119;PMC9169922全文 · 相关全文已核

    Results结合Table1及段30–55,Table2全参数和饱和式;Discussion57–65相关段

    Polalpha无内在校对,不与s4拼成同一实测酶。KD区分DNA结合和入站底物的表观值,Table2单位mM;38倍kpol/249倍效率/参照浓度209.896倍不同口径。原文3.5/.017约206,按显示参数复算约210,保留而不编未舍入差别原因。参数SD保留,未得协方差不造比值CI;未重跑拟合或原实验。

  7. S6 原始测量来源,本文限定复制活性与突变率读数

    Scalable, Continuous Evolution of Genes at Mutation Rates above Genomic Error Thresholds

    Arjun Ravikumar, Garri A. Arzumanyan, Muaeen K. A. Obadi, Alex A. Javanpour, Chang C. Liu · 2018

    Cell175,1946–1957.e13;PMC6343851作者稿 · 相关全文已核

    拷贝数测量/标定107/110/111段;Quantification140/142;TableS2说明169–170及不同阶段资料说明

    mu由表型回复率除以细胞数、p1拷贝数及靶标换算因子,与1/copy共用分母。暴露校正本身必要,不自动证明伪相关。copy代理整体活性和持续复制等,非直接秒数。本文不分析该文药物耐受应用或提供分子改造设计;不是全篇实验独立复核。

  8. S6DATA s6原始汇总观测表,s1重用,非两组独立实验

    Supplementary Table S2 for Ravikumar et al. 2018

    Arjun Ravikumar et al. · 2018

    Cell出版TableS2;与2026作者整理版本逐格核 · 相关全文已核

    TableS2行2–318配对测量;合并单元格按原组补全,仅为理解表格;317×7原字段对整理表2219格

    317记录对应213变体,脚本按同一行配对,逐项均值不假装独立重复合并CI。75原区间不含点估计,含上下限相同或倒置,原值/行号保留,不交换补造。µ文本317值与整理数值一致。关联整理表ravikumar-reformatted.xlsx/提取notebook来自作者Git快照ccd9efe;匿名ID代替序列标签公开。共同分母示例为自选反例,不判真实趋势完全伪造。

最后更新 2026-09-10

来源