平均看起来没动,内部仍然可能在付账
一台分子机器被外力顶住,平均位置不变,内部仍可能不断消耗化学燃料;一个粒子的分布长期保持相同形状,内部也可能存在不断转动的概率流。
因此,“状态分布没有继续改变”和“没有持续耗散”是两个问题。处于非平衡稳态的系统,可以一边保持可见统计特征稳定,一边持续向环境输出熵。
但观察到一段不可逆变化,也不自动说明有持续驱动:它可能只是初始储存的自由能正在松弛。本篇先用稳态模型把对象限定清楚,再讨论部分观测会留下什么、漏掉什么。
这里最有用的区分是:数据可以证明至少发生了多少,借助模型可以推断总共发生了多少,以及现有观测还无法分辨哪些不同内部过程。
熵产生与能量消耗也需要区分。只有说明环境温度、稳态条件、工作输出等能量通道,才能把相应熵产生率换算为耗散功率。一个从轨迹计算出来的无量纲数,并不会自动成为瓦数或每秒消耗的燃料分子数。1
怎样从轨迹里寻找时间方向
假设我们能反复记录一段过程,并把每段记录倒放。如果正放记录中的某些模式经常出现,而倒放后的对应模式很少出现,统计上就存在可区分的时间方向。
这种可区分性可以用Kullback–Leibler散度来表达。大白话说,它衡量:一批记录更像来自正向过程,还是来自相应的反向过程。数值为零,表示这项比较没能区分两者。
在适用的随机热力学框架中,完整轨迹的正反不对称与总熵产生联系起来。只保留一部分信息后,通常只能得到下界。这里的“完整”,不仅包括看到多少状态,也包括时间信息、环境条件和正确的反向操作。12
本篇的有限状态例子把状态视为倒放时不改变符号的标签。若记录包含速度等具有不同时间反演性质的变量,还需要相应的符号变换和反向条件,不能只把数组顺序倒过来。
对稳态、双向转移都允许的有限状态网络,可以写出一个具体的熵产生率:
这里$k_{ij}$是从$i$到$j$的转移速率,$p_i$是随机时刻处于$i$的概率;本篇计算取$k_B=1$。每条边的正反通量差,与正反通量比例共同进入账本。
只看到平均位置,就漏掉了这些通量;即使能记录几个状态之间的跳动,仍可能把多条内部通路合并到一起。
一个看不见净流,却能从等待时间看出循环的例子
设一个系统有四个内部状态,按一圈排列:
本库自选一组速率,让系统更容易沿一个方向走。两个隐藏状态的等待快慢不同:经过$H_1$通常较快,经过$H_2$通常较慢。
现在把观察能力限制为三种标签:A、B和H。观察者每一瞬间都能知道系统处于这三类中的哪一类,却分不清H内部究竟是$H_1$还是$H_2$。
可见的图只剩:
在稳态下,这条线上的每条边都没有净流。进入A的平均次数必须与离开A平衡,B也一样。但底层四状态仍可以不断绕圈。
只数次数,会漏掉这件事。若进一步区分“从A进入H、下一步到B”和“从B进入H、下一步到A”,就可能看见不同的等待时间分布。
这组参数下,前一种经过H的平均时间约为0.052,后一种约为0.198。它们不是两条单独的纯指数曲线,而是两条隐藏通路贡献的混合。方向偏好改变了走哪条通路的概率,两条通路的快慢差又把这个偏好变成可见的时长差。
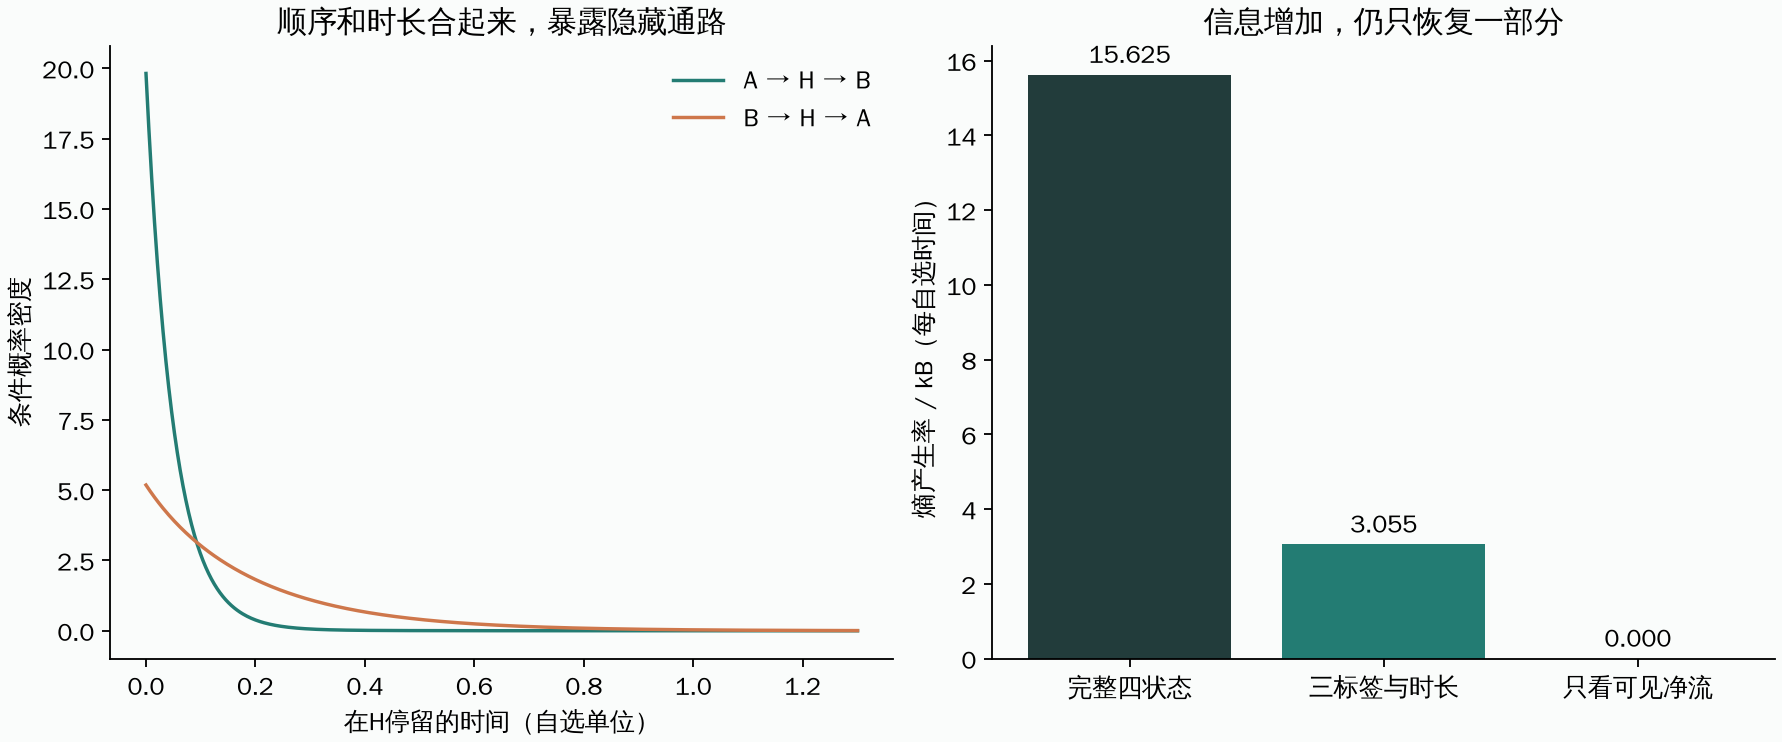
完整模型的熵产生率约为15.625。保留三种标签和时长后,可见路径的不对称率约为3.055;只看可见净流则得到零。
本库还实际生成了12条相互独立的长轨迹,用隐藏状态滤波分别计算整段观测正放、倒放的概率。得到的平均不对称率约3.042,跨重复的标准误约0.036,与前面的理论值相容。这个检查保留了轨迹两端的等待信息,没有只比较几个片段的曲线形状。
在这个例子里,H的下一步不仅取决于“现在是H”,还与刚从A还是B进来有关。底层过程可以没有额外记忆,合并状态后的过程却需要保留前一个可见状态。这正是二阶半马尔可夫描述在这里有用的原因;“底层是Markov过程”不能直接传给粗化后的记录。12
连等待时间也相同,内部就一定不耗散了吗?
把两个隐藏通路的等待快慢调成一样,前后方向的等待分布差就消失了。在本库另一个明确参数组中,完整系统的熵产生率约为17.578,而三标签轨迹的时间反演不对称率为零。
这证明,某项观测统计没有检出不可逆性,不能反推完整系统平衡。它也不意味着所有更强的、附带模型条件的方法都无法利用剩余相关性;需要说清“没检出”是针对哪项统计和哪类假设。
还有一种更彻底的不可辨识性。设可见系统按固定规律跳动,同时存在一个与它独立的隐藏循环。只要不改变耦合,隐藏循环可以运转得更快,而所有可见轨迹统计保持完全相同。
本库构造的三个版本,可见过程完全一样,总熵产生率却约为1.758、17.578和175.778。用完整转移矩阵求传播概率后,投影回可见部分的结果逐项一致。
如果允许这种额外隐藏过程,仅凭现有轨迹就不能给总耗散一个无条件上界。已知的能量供给、装置结构、速率范围或额外测量,当然可能限制它;那是加入了新的物理信息。
等待时间也会骗人:关键在于怎样整理记录
2019年的研究指出,等待时间有机会暴露净流无法看见的不可逆性。2024年的评论与作者回复进一步明确了它的适用条件:不能把任何经过处理的记录,与它简单倒放后的差异,都解释成物理熵产生。123
先看一个很具体的操作。假设仪器看不见中间状态H,于是软件在空白时段一直沿用“上次见到的状态”。从A离开后经过H,软件仍显示A,直到终于看见B,才改成B。
这样,停在H里的时间,被算到了刚离开的A头上。把原始过程倒放,再执行相同规则,这段时间又可能被算到B头上。
于是,“先处理再倒放”与“先倒放再处理”不再相同。
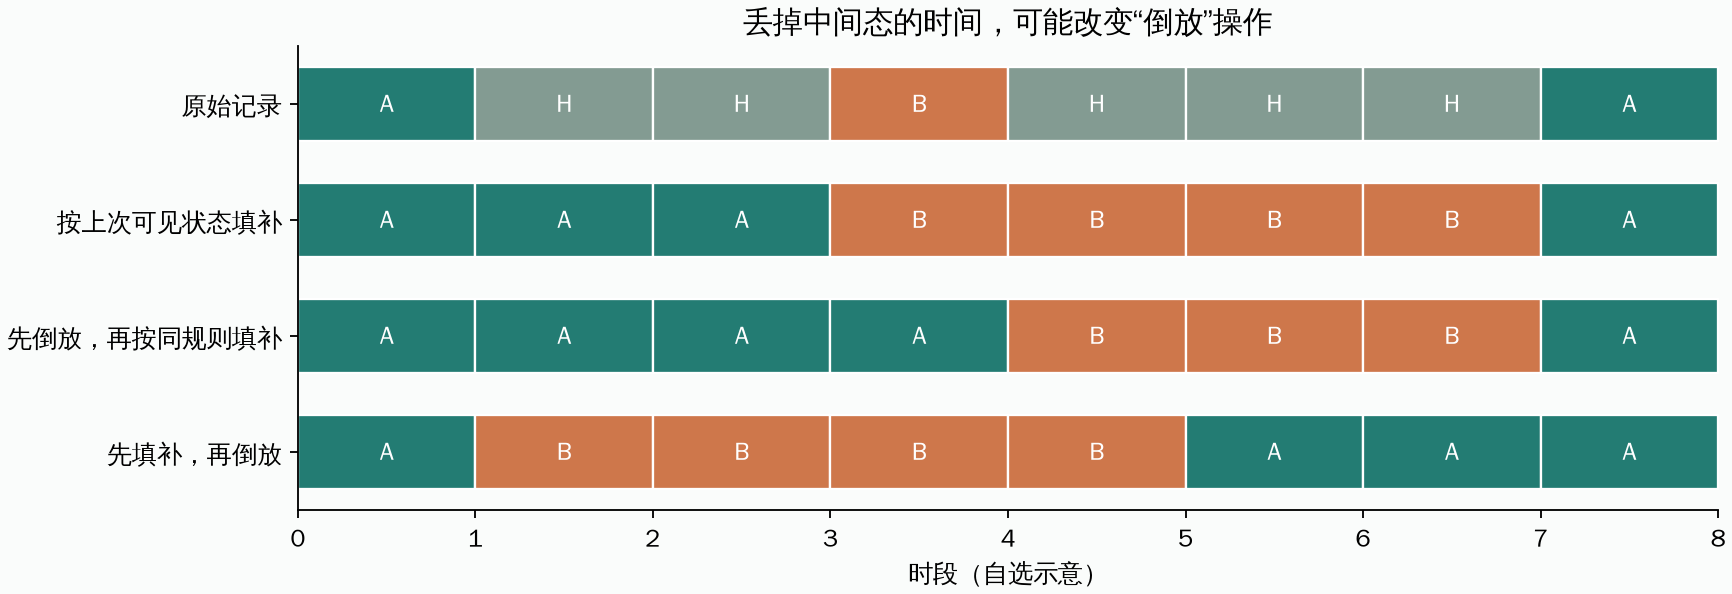
这里并不是说不能使用历史信息或不能填补缺测。问题是,处理过的记录如何与物理反向过程对应,必须重新定义和检查。
2024年评论给出了一个底层满足详细平衡的例子:沿x方向离开需要经过隐藏中间态,沿y方向可以直接离开;记录只保留最后见到的位置。两类条件等待时间分布不同,却不能据此说系统在持续耗散。3
本库按原模型公式复算了两份等待分布,并用独立的首达转移矩阵相核。两方向散度约为0.282和0.473,确实都大于零。有限周期网络的完整转移满足详细平衡,物理熵产生率为零。
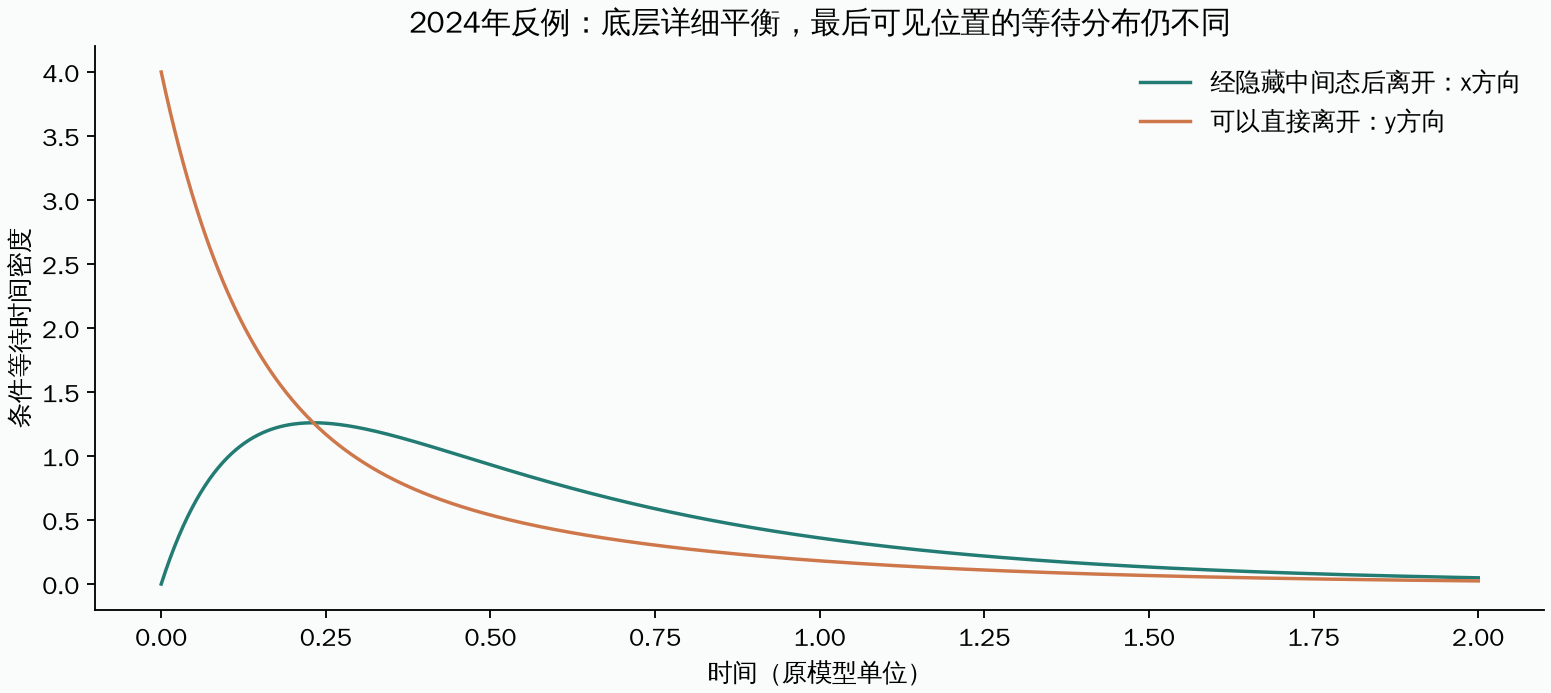
回复文章并没有因此否定所有等待时间推断。它强调了两个分界:处理记录的操作应与时间反演相容;在相关的局部粗化情形下,零净流时还能提供新信息的例子,需要有二阶半马尔可夫结构。2
前面的四状态例子正是按这些条件构造的:每一瞬间都把$H_1$和$H_2$固定映射为H,保留进入、离开的时刻,不把中间时间交给上次可见状态。
2026年的新方法:从轨迹中学习耗散发生在哪里
Das和Manikandan在2026年的工作,把短时间热力学不确定关系与神经网络结合起来,尝试从轨迹中学习一个热力学力场,用它定位不可逆贡献出现的位置和时段。4
可以把它的工作方式理解成:先给每个位置放一个可调整的“位移权重”,让沿某些方向的移动加分,沿另一些方向减分。这样,每个短位移都被转换成一个广义流$J$。
然后寻找一组权重,让下面这个目标尽量大:
在相应的过阻尼扩散、足够短的时间步和充分优化等条件下,这个变分问题与熵产生率及热力学力场联系起来。神经网络提供灵活的函数表示,使复杂空间里的权重也有机会被学习出来。
但目标对整体倍乘权重不敏感,因此还需要额外的短时关系确定力场的比例尺。不能只看优化得到了一个大目标,就认为场的每个分量都已完成物理标定。
这套方法不要求先知道每一项精确受力方程,却仍然有动力学类别、采样和统计条件。有限时间采样会改变结果,隐藏变量也会改变得到的有效描述。
原文的一个受控检验,把三维线性模型投影到二维,并降低时间采样频率,再与相应的粗化理论比较。作者明确说,得到的场应理解为该分辨率下的有效场;这个受控的解析基准主要限于线性模型。4
因此,较好的相关性不能解释成“恢复了相同比例的全部真实耗散”,更不能说明丢掉的自由度已经被神经网络无条件找回。
一个可精确求解的布朗运动例子:采样慢了会怎样
为了把这些条件算清,本库选择一个二维模型。粒子受中心回复作用,同时存在旋转驱动和热噪声:
$R\mathbf x$表示把向量旋转90度,$\lambda$控制回复,$\Omega$控制转动。这属于多维Ornstein–Uhlenbeck(OU)过程:漂移对位置是线性的,噪声是高斯白噪声。参数全部为本库自选;在这里的单位下,稳态完整熵产生率为:
取$\lambda=1$、$\Omega=3$,得到18。这个模型的稳态位置分布,仍可以是形状不变的圆对称高斯分布;推动它转动的概率流,需要从动态关系中寻找。
本库按精确的高斯转移生成轨迹,使用四个线性位移特征实现变分估计,再用另一条独立生成的轨迹检验。它展示的是推断原理,没有重跑2026论文的神经网络。
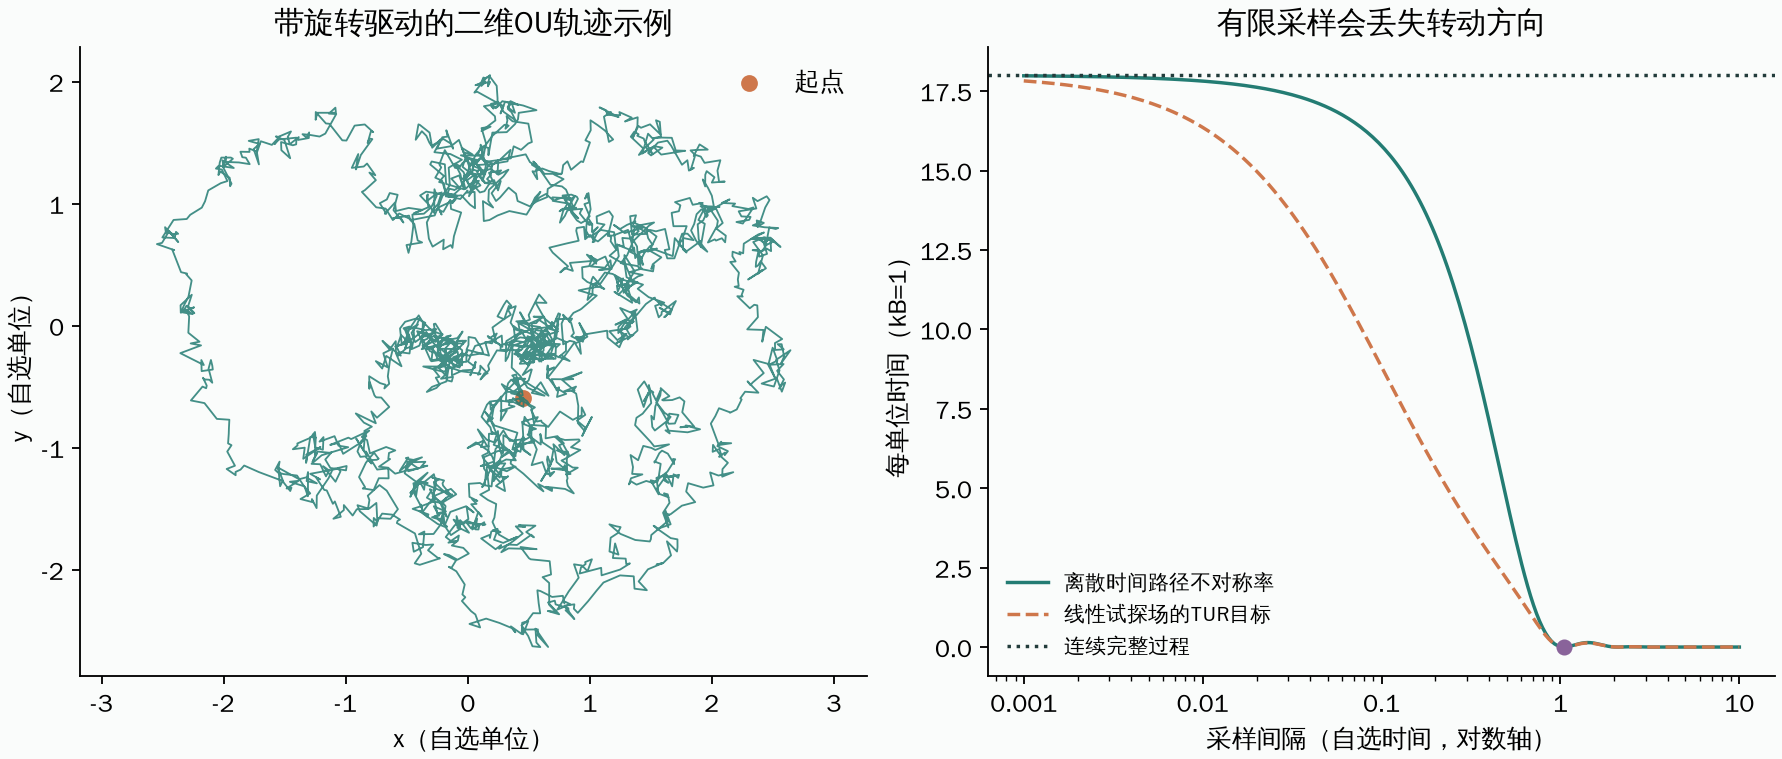
在采样间隔0.002时,各项结果如下:
| 所比较的量 | 数值 | 含义 |
|---|---|---|
| 连续完整过程的熵产生率 | 18 | 已知模型的理论总量 |
| 该采样间隔的离散路径不对称率 | 约17.964 | 时间采样后保留的信息 |
| 线性试探场的理论变分目标 | 约17.647 | 这一函数类别与有限步长下的目标 |
| 独立测试轨迹给出的变分估计 | 约18.061 | 本次有限样本的输出 |
最后一个数略高于18,不是理论下界被推翻,而是提醒我们:总体分布上的下界,与一次有限样本输出的数值不是同一个保证。 有限样本误差、优化选择和离散步长都需要检查,不能把任何估计程序的输出直接当成严格置信下界。
模型还有一个很清楚的采样反例。若间隔恰好为半个旋转周期,约1.047,正转与反转会产生相同的离散转移关系,采样路径的不对称率降至零,而连续过程仍然耗散。
这解释了为什么“采了很多点”还不够。点之间隔多久、有没有漏过关键运动,决定了信息是否还在;相邻点高度相关时,点数也不能直接当成独立样本数。对于任意两种采样间隔,曲线不必逐点单调,因为对应网格不一定互相包含;只有适当的嵌套粗化,才能直接使用信息不能增加的比较。
如果只观察这个模型的x坐标,得到的是一个稳态的标量高斯过程,它的路径在时间反演下对称:这种过程的联合统计由均值和协方差决定,而倒放不会改变这两项。若先假定完整系统必定属于这里的旋转OU模型,x的相关函数又可以提供旋转频率等信息;据此推断总耗散,已经加入了模型约束。两种做法回答的是不同的问题。
局部颜色图,也需要说明画的是什么
熵产生定位图的优势,是能指出哪类运动、哪些区域更值得进一步检查。但它仍是一种根据轨迹、估计场和选定理论得到的结果。
在稳态过阻尼框架中,原文的局部力场与短位移结合,可以对应随机总熵产生。时变情况下,还需要区别概率密度显式变化带来的项;这个项在适当系综平均下为零,不等于在每条轨迹上都为零。4
因此,图中某个短片段为负,不等于整套系统持续违反热力学规律;某个区域颜色很深,也不能脱离变量选择、采样间隔和模型条件,直接当作那里每秒烧掉了多少能量。
更有价值的使用方式,是让这张图帮助选择下一步测量:哪里需要更高时间分辨率,哪个隐藏坐标最可能补回信息,哪些状态转换需要保留完整进入和离开过程。
应当增加什么观测,取决于缺口在哪里
如果问题来自不同内部通路被混成一个状态,分辨更多状态,或至少保留前后状态和等待时长,可能有用。
如果问题来自关键运动被跳过,增加总记录时长与提高采样速度不能互相替代。记录很长的慢采样,也可能一直漏掉每个间隔内部的循环。
如果问题来自软件处理改变了时间反演,先修正记录与反向过程的对应关系,比继续增加同样处理后的数据更重要。
如果问题来自与可见运动无关的隐藏耗散,再精确分析原来的轨迹也无法补足总账,需要新的物理测量或结构约束。
本篇得到的有条件答案是:部分运动确实可以提供非平衡线索和耗散下界,有些等待时间能看见平均净流漏掉的过程;这些能力依赖正确的观测映射、反向定义和动力学条件。数据没有识别到的部分,可以明确留下,而不必被包装成“系统一定平衡”或一个虚假的精确总量。
可回查:计算结果、隐藏状态条件等待分布、独立轨迹概率核验、平衡反例等待分布、OU采样理论值、独立测试分段结果、示例轨迹、不可见独立循环。