一种呼吸道感染安静了一段时间,随后突然增多,甚至在往年不常流行的季节出现。直觉会说:前面少感染,后面就要补回来。这句话抓到一个可能存在的机制,却把几道不同的问题挤在了一起。
是从未感染过的孩子变多了,还是同龄人的保护发生了变化?是恢复接触后病例暂时集中,还是从干预开始算起,累计感染真的更多?如果首次感染推迟到更大的年龄,临床后果会与原来相同吗?
这些区别决定了“免疫债”究竟是在指一个可测量的人群状态,还是在替尚未完成的归因下结论。本篇以RSV为主、流感为比较,把出生、免疫、接触和季节放进同一条因果链;用一个实际执行的小模型说明哪些结果可以并存,再看原始研究如何用观察约束模型。这里不估计中国防控造成了多少额外感染,也不根据模型给出个人健康建议。
安静期间,变化的是什么
设想两个社区在某一时刻具有相同的人口结构和感染经历。此后,一个社区保持原来的接触条件,另一个社区有一段时间大幅减少传播。即便病毒本身完全不变,两个社区后来也会走到不同的状态。
首先,孩子继续出生。持续流行的社区里,一部分新生儿随后经历初次感染;传播很少的社区里,更多孩子尚未经历它。于是同样叫“两岁儿童”,两组人的感染历史可能不同。
其次,过去感染过的人也在变化。某些能降低再次感染机会的保护可能随时间减弱,近期感染带来的抗体提升也不再经常出现。但保护的变化不能简单理解成“整个免疫系统闲坏了”:不同抗体、位置和细胞记忆承担不同作用,抗体读数与感染风险的关系需要另外验证。这是前篇《抗体变少,意味着更容易感染吗?》讨论的边界。
第三,年龄照常增长。身体发育、气道结构、行为与接触对象会改变,即使孩子没有经历目标病原体的感染。因此,“更大年龄”与“更多次感染”平时经常一起出现,在传播中断期间却能部分分开。Koltai等的RSV研究正是利用这个区别,比较年龄相关变化和既往感染分别能解释什么。2
一个简化例子足以把队列变化讲清楚。假设每个尚未感染的人,每年的初次感染风险率恒为0.8;这只是自选示意值。在持续暴露的世界,年龄为两岁时仍未感染的比例是 $e^{-0.8\times2}$,约20%。如果最近两年完全没有该病原体的传播,那么这两年出生、至今不超过两岁的孩子,在这个例子里都没有经历过它。
两边孩子的实际年龄一样,感染经历却很不一样。这个差别无须先假定孩子的免疫器官受到了损伤就能出现。反过来,它也没有证明既往感染是年龄相关保护的全部来源。这个例子只计算“到这个年龄为止有没有感染过”,没有模拟母体抗体、再次感染和人与人的传播反馈。
所谓群体的历史状态,至少包括:各年龄有多少人、各自经历过什么、当前保护如何,以及这些人接下来怎样互相接触。 一个全国平均抗体数或一个易感总比例,会丢掉其中不少信息。
易感人数有收支,但“感染债务”没有固定账单
最小的传播模型把人分成易感者 $S$、当前感染者 $I$ 和暂时受到保护者 $R$。如果保护会减弱,使一部分人重新容易感染,就有 $S\to I\to R\to S$ 的循环,通常称为SIRS模型。
模型里的“易感”是针对某种感染结局的近似分组,不代表一个人的全部免疫能力归零。真实保护通常是分程度的,年龄、感染次数和病原体变异也会影响它。为了把一条机制单独看清,本节暂时把这些细节压缩成几个收支项。
把总人口标准化为1,出生与死亡率都记为 $\mu$,保护状态的退出率为 $\omega$,单位时间的新感染事件记为 $J(t)$,易感比例的变化就是:
右侧依次是新生人口进入、保护减弱后回流、因感染离开,以及易感者死亡离开。模型忽略新生儿被动保护,把出生者直接放入易感组;这一简化不能用于解释生命最初几个月的具体风险。
在同样的人群状态下,降低传播系数会压低“因感染离开”这一项。只要补充和回流仍在继续,易感人群就可能比持续流行的对照更多;随着人群状态分化,两边每个时点的感染率仍须重新计算。这是后续反弹的一条明确机制,2020年Baker等对RSV和流感的研究已用类似的人群收支解释过它。1
然而,把上述式子从开始积到某个终点 $T$,得到的是:
这说明累计感染并不是预先定好的常数。改变传播后,保护状态的人数及其回流会变,易感者的人时会变,终点的人群状态也会变。人口不断出生、老去和退出,预防方式与病原体还可能继续改变。
因此,“当时少感染了一些人”不能单凭人口收支就变成“以后必须多感染同样多的人”。在允许再次感染的模型里,左边累计的是感染事件,同一个人可以计入不止一次;它也不是这群人的终身感染人数。
同一条历史,可以有更高的峰值,也可以有更低的累计值
本库实际计算了两个具有相同初始状态的假想世界:对照持续保持原接触条件;另一个世界把传播系数降低75%,持续1.5年后恢复。两边采用相同的季节变化和极小外来输入,后者让低流行期之后仍有感染引入。
这些参数用于讲清机制,未拟合RSV、流感或任何中国地区。模型不描述疾病严重程度。季节变化下的对照也不必每年出现完全相同的波形,所以比较必须使用对应的日历窗口,不能随手挑一个较小的历史峰作分母。
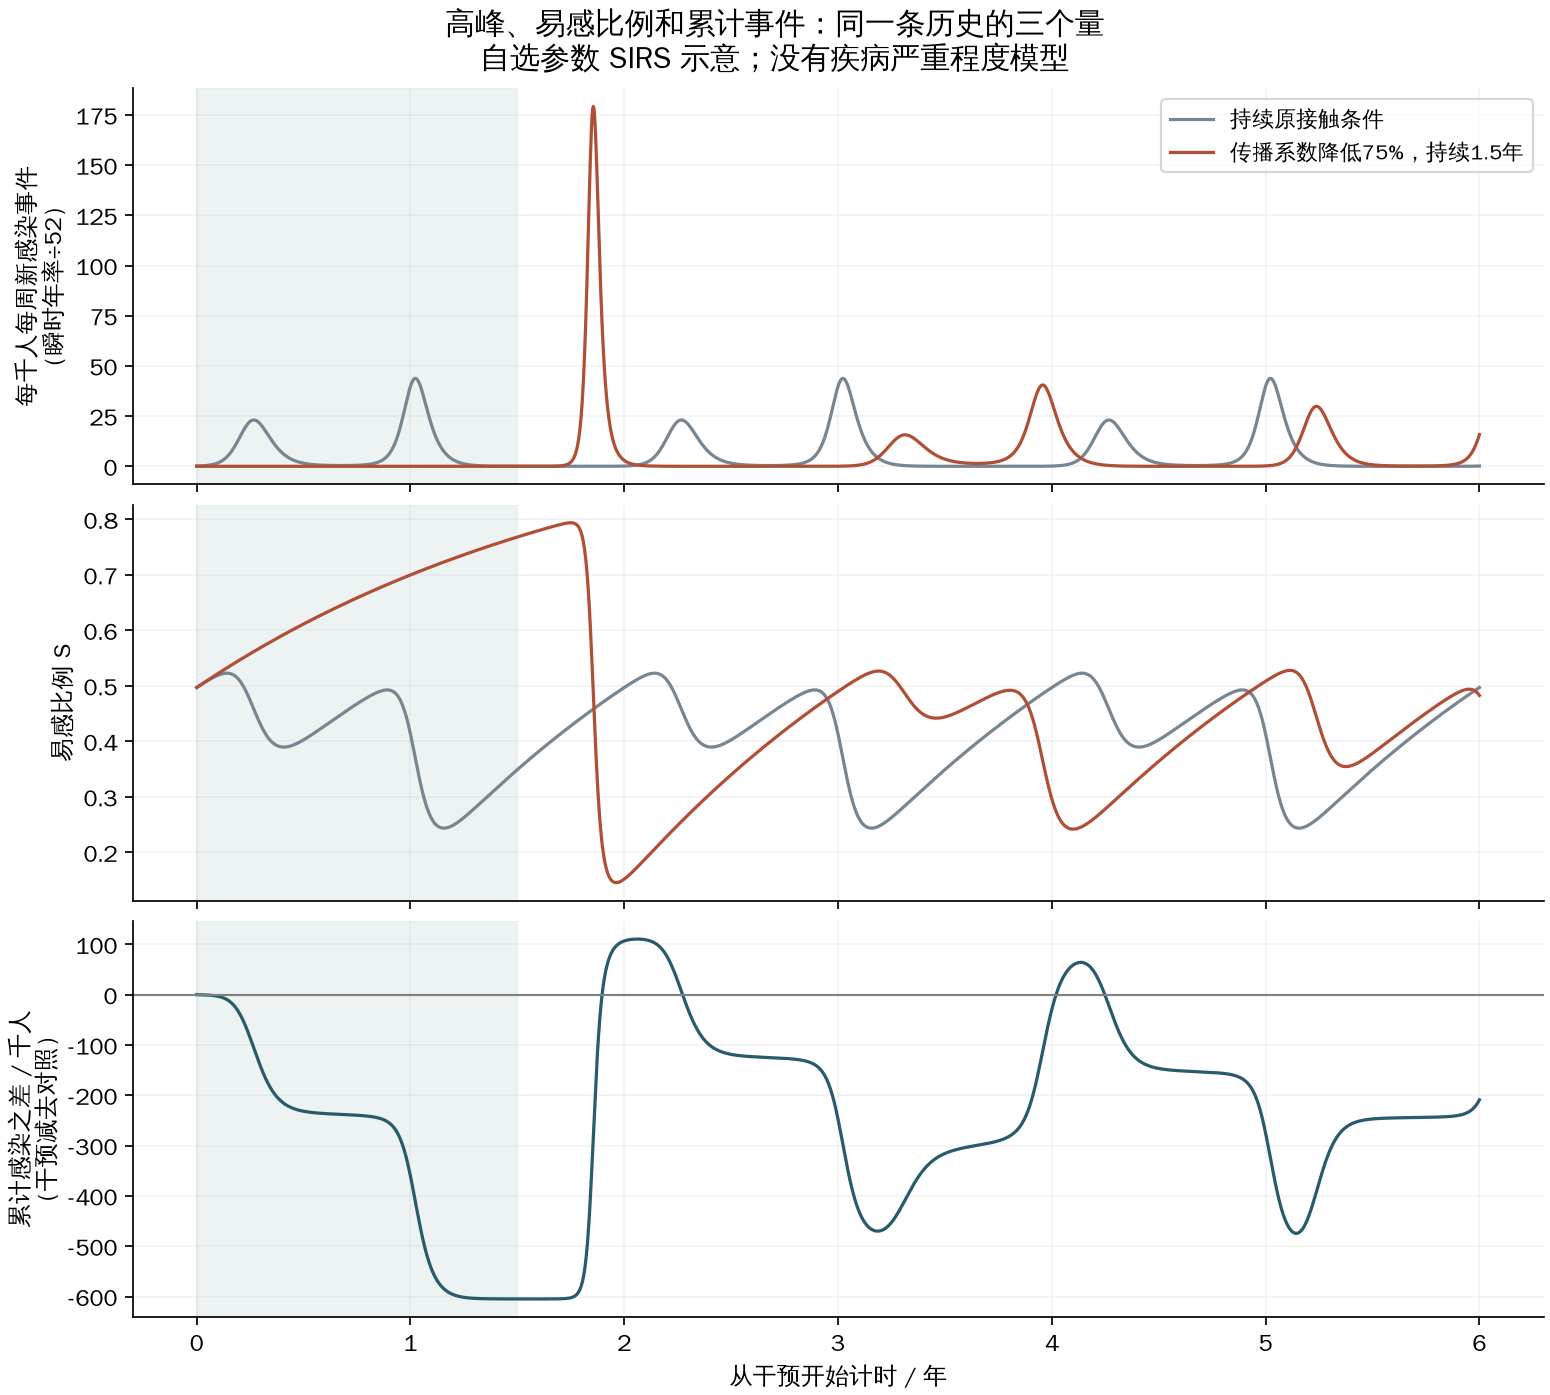
图中阴影是传播系数降低的1.5年。上图纵轴把瞬时年感染率除以52,便于按周阅读;它不是对每个自然周逐周积分的病例数。中图显示易感状态,下图显示“干预世界减去对照世界”的累计事件差。全部曲线由本库计算,非论文原图。
恢复时,两边易感比例约为77%与35%。前者随后出现一个集中的高峰;在恢复后同一个一年窗口内,它的最高新感染率约为对照的7.8倍。这个倍数属于本例、这个分母和这个窗口,不能当成现实预测。
再看累计值,会得到另一幅图景:
| 从干预开始计时的截止点 | 干预世界相对对照的累计感染事件差,每千人 |
|---|---|
| 1.5年,刚恢复 | 约少605次 |
| 2年,集中高峰之后 | 约多107次 |
| 2.5年 | 约少119次 |
| 3.5年 | 约少316次 |
| 6年 | 约少209次 |
同一个模型,同一组参数,没有更换比较对象,只是把结算日期往后移动,差值就会改变正负。原因是两条流行历史已经错开:一边刚经历大波峰,另一边下一轮尚未来到;随着各自的感染与保护收支继续变化,差距又会改变。
这既不能证明现实中的干预一定降低六年累计感染,也不能证明真实人口一定要经历这个反弹。它证明的是更有限、但有用的一点:看到后来的高峰,尚不足以回答累计发生了多少;选择哪段时间比较,是问题定义的一部分。 本例六年结束时也不能宣告系统已经达到唯一长期结局。
同理,“医院更忙”还多隔着几步。住院量取决于各年龄的感染量、感染后的疾病风险、就医与收治方式,以及病例在时间上是否集中。峰值压力、整个季节的住院总量和多年累计负担需要分别计量;只算感染曲线的模型无法替它们作答。
为什么恢复接触之后,不一定立刻出现同一种反弹
易感人群是历史留下的状态,接触与季节是当下的条件。两者要相遇,才能形成具体的流行。
恢复发生时,可能仍处于不利于传播的季节;也可能接触只逐步恢复,或者不同年龄恢复得不同。外来输入何时出现、本地是否还有感染延续,也影响起点。因此“政策某日调整”与“实际接触某日全部恢复”不能互换,行政日期更不直接等于感染曲线的起涨日期。
2020年的Baker模型比较过季节节律不同的美国地区。它支持传播减少可能使后续流行推迟、增大或偏离原来的季节,但这些是以既有资料拟合并外推的条件结果。其早期监测还受到检测变化影响,不是一场预先随机安排的对照试验。1
本库把同样持续1.5年的干预分别放在12个不同的开始季节,其他基准参数不变。恢复后一年内的峰值比出现明显差异。这里开始和结束季节一起移动,且各情景都有对应的未干预对照;它没有将季节与人群历史完全拆成彼此独立的效应。
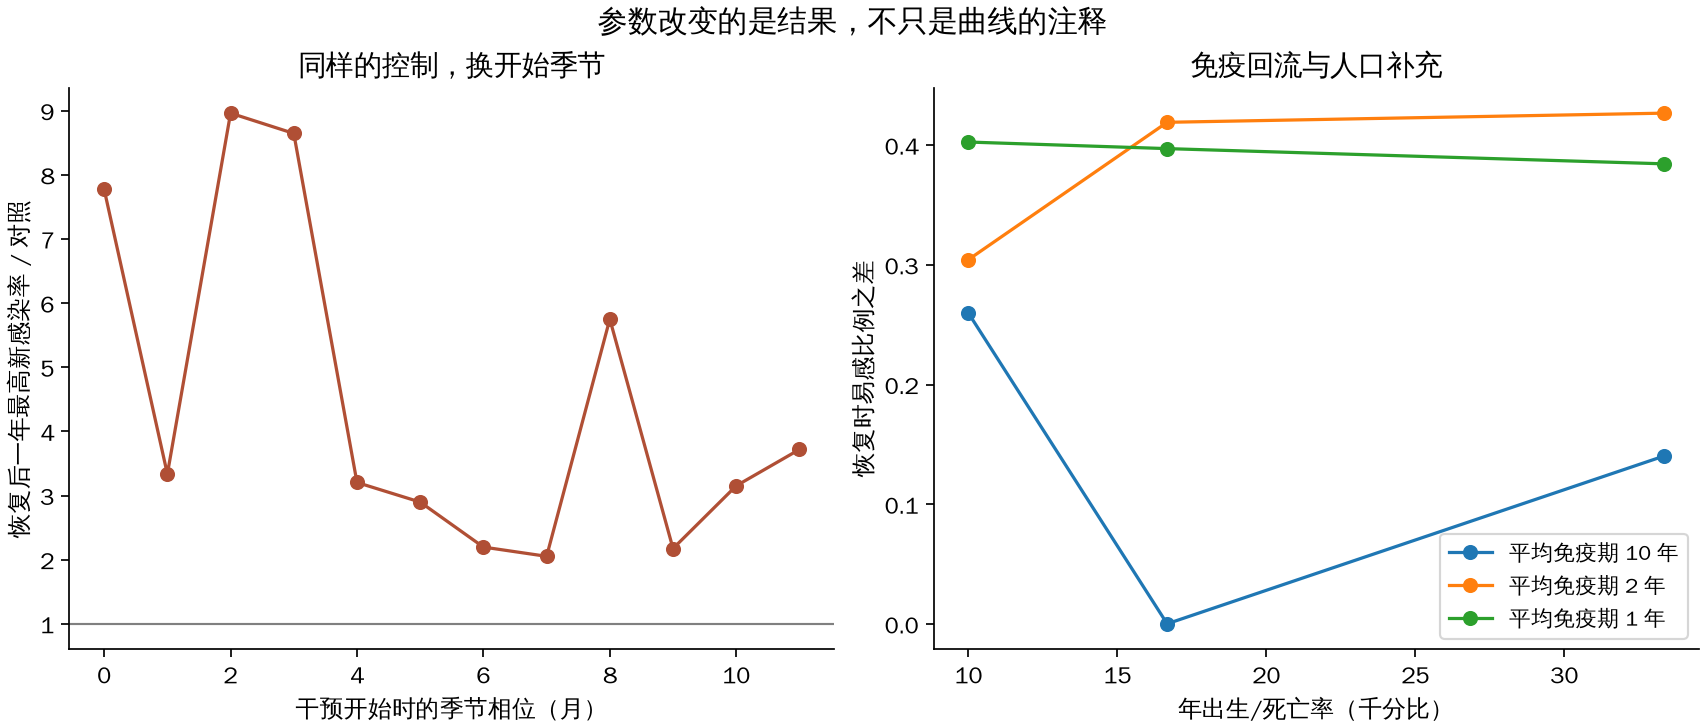
右图另外比较三种保护退出时间尺度与三种人口更新率,显示恢复时两世界易感比例的差。每组都先生成自己的长期基准轨迹,再作配对比较。曲线并不处处单调:参数既改变人群补充,也改变原来的流行节律。不能把“出生率更高”直接翻译成“反弹一定按比例更大”。图中的免疫期是简化保护状态的平均停留时间,不是抗体的实测寿命。
有现实约束的例子来自Koltai等2022年的RSV研究。作者把年龄与既往感染历史分开,在多个年龄组中比较不同机制。仅凭疫情前的常规季节模式,不少不同参数组合都能过关;它们对传播恢复后的年龄构成和病例量却给出不同结果。2
更有信息量的是模型没有解释好的地方。最初假定接触在2021年5月一步恢复,即使疫情前拟合较好的模型,也不能很好重现英国从6月开始的回升。改成从3月起逐渐恢复接触后,部分轨迹才更接近观察到的起点。这些轨迹同时更偏向较弱的季节作用及较强的年龄相关效应。
这不等于“年龄机制已经被唯一证实”:接触、季节和免疫参数仍有互相补偿的空间,模型也没有完整重现后续峰值。它说明,恢复的实际过程是承重条件,不能只给模型填上一个解除限制的日期,就把余下差异全部算到免疫头上。
血清证据能让模型走多远
2025年Bents等把美国King County的呼吸道病原体抗体资料与流感就医监测接起来,尝试让不同年龄的免疫变化成为模型约束。儿童部分主要是不同时间采到的横断面样本,成年人另有配对样本;不能把全部资料讲成“跟踪同一批儿童看着抗体下降”。4
研究比较了两种结构:所有年龄用相同的保护退出速率,或允许小龄儿童与较大年龄不同。后者更好解释了疫情后流感就医中较大儿童占比的变化,这是年龄结构提供额外信息的例子。
但它没有在所有指标上胜出。两种模型对2022—2023年回升时间都偏晚;年龄统一模型的时间估计还略近一些。方法部分给出的总体拟合误差也没有显示分层模型全面更优。并且这些比较使用了2017—2023年的拟合资料,不能称为对全新后续年份的独立预测检验。
观测层还有一道限制:医院急诊与住院记录不等于全部感染。报告机构数量随时间增加,研究只能用机构数作近似调整;年龄间检测与报告方式的差异仍可能影响构成。模型也没有显式模拟疫苗和流感抗原演化。因此,这项研究使“年龄不同,保护变化可能不同”更值得检验,却没有给某地区的反弹分配出一个唯一的免疫原因比例。
从血清走到群体归因,至少要过三道关:读数怎样对应保护,保护怎样对应实际感染,感染怎样对应监测里被看见的事件。把第一关的发现直接拿来回答第三关,会高估证据已经走过的距离。
长期持续降低传播,是另一道问题
前面的例子研究“减少一段时间,然后恢复”。另一种常见说法谈的却是“长期维持某种措施后,最后能少多少感染”。这两个问题的比较条件不同。
在没有季节、没有外来输入的经典SIRS模型里,如果干预始终只把传播系数乘以一个固定比例 $p$,其他参数不变,那么存在地方性流行时:
这里 $R_0$ 是无干预的基本再生数,$\gamma$ 是感染者恢复率;在本节的常系数模型中,$R_0=\beta/(\gamma+\mu)$,$\beta$ 是传播系数。星号代表平衡状态;若 $pR_0\le1$,不能继续套用正的地方性流行公式。这段解析比较也不适用于前面带外来输入和季节起伏的模型。
这个式子有一个反直觉的结果:相同幅度的持续传播降低,在不同基准条件下,对长期平均感染的影响可能差很多。本库代入持续降低20%:在 $R_0=1.8$ 的示例中,平衡感染比例变为原来的约69%;在 $R_0=8$ 时,约为96%。由于恢复率和死亡率固定,平衡时新感染率的比值也相同。
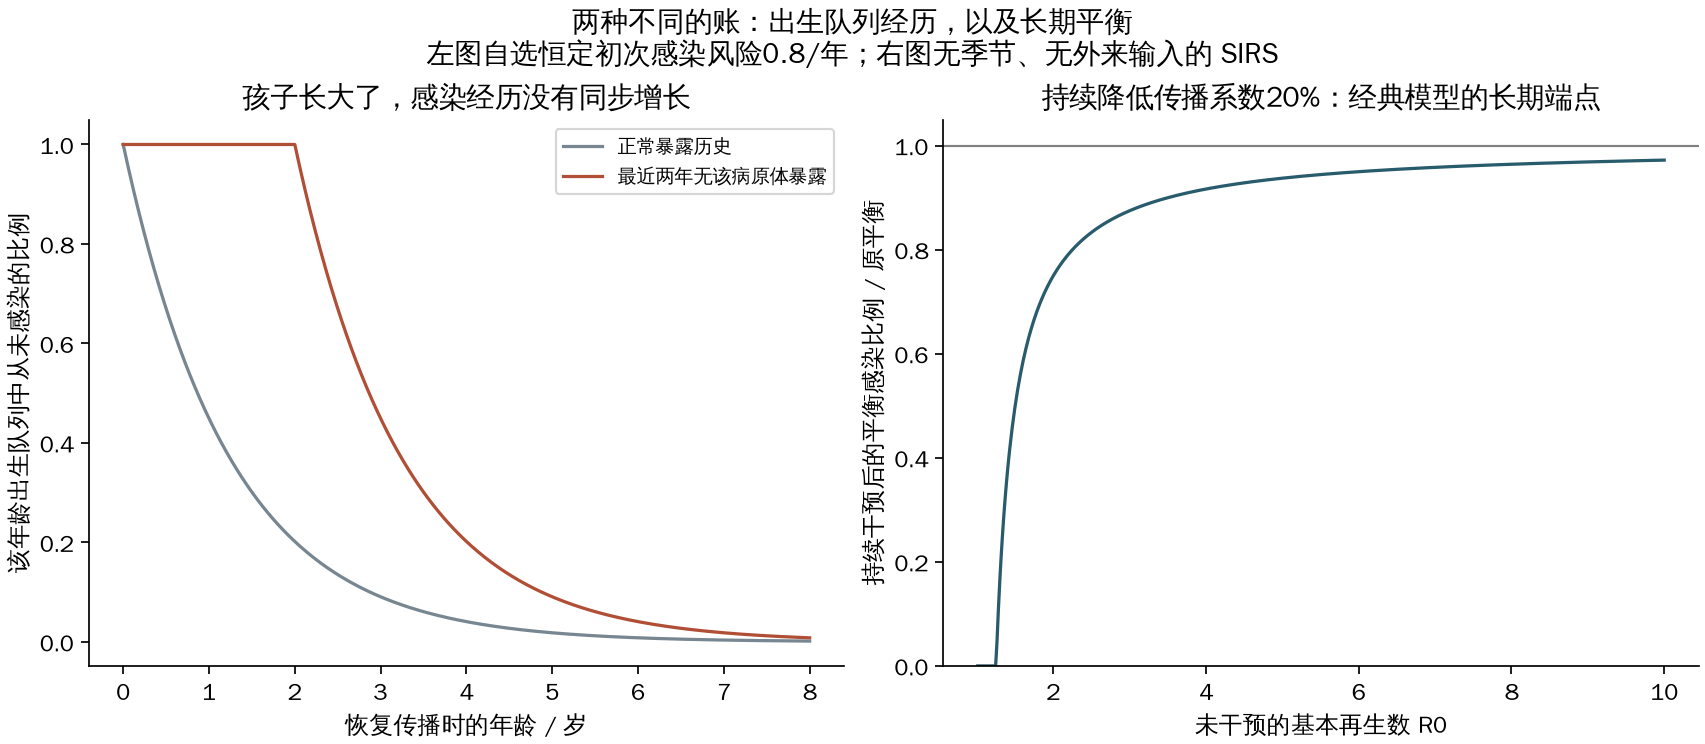
左图是前文“孩子长大、感染经历未同步增长”的队列例子,右图是本节的长期平衡;两幅图属于两个不同的简化问题。它们共同提醒我们:感染历史可以累积出差别,但这个差别没有一个通用的偿还规则。
上述长期差异是Baker等2022年研究强调的机制之一:在特定模型和较高基础传播水平下,较小的持续传播降低可能被易感状态的调整部分抵消。3 这不能升格为“任何措施最终都没用”。更强的干预、不同的免疫结构、疫苗、年龄相关重症风险,乃至干预期间已经减少的负担,都超出那句口号。
2026年Saad-Roy等进一步改变了一个结构假设:已有部分保护的人,面对不同程度的暴露,保护的实际表现未必保持同一固定比例。把这种依赖关系加入模型后,持续减少传播的长期收益可以不同于经典模型的结果。5
这是一项理论扩展。研究没有提供新的经验数据来确定关系的定量形状;减少接触次数,也不能自动等同于改变每次接触的暴露程度。它的贡献是指出原先结论依赖哪些可改动假设,尚不能作为现实中某项措施长期效果的直接估计。2020、2022与2026这条模型研究线还有共同作者,不能计成三份相互独立的历史验证。
什么证据最能区分这些解释
更大的反弹,往往同时符合多种解释。需要寻找的不是更多形状相似的曲线,而是让竞争解释出现不同预期的观察。
| 要区分的机制 | 更有用的证据 | 单靠什么仍然不够 |
|---|---|---|
| 年龄本身的变化与过去感染形成的保护 | 按出生队列随访,记录既往感染,在相近年龄和接触条件下比较后续风险 | “较大儿童病例占比上升”;占比变化也可能来自其他年龄病例减少 |
| 保护变化与接触恢复 | 同期接触资料、学校与家庭信息,配合感染前的保护指标和主动监测 | 把政策日期当作所有人的实际接触曲线 |
| 季节条件与人群历史 | 多地区、多季节的对照,允许不同地区具有不同既往流行状态 | 把一个地区的错季高峰外推到全国 |
| 真实感染增加与监测变化 | 稳定采样规则、检测分母、人口分母,以及就医和收治口径 | 阳性样本数、阳性率和住院数互相替代 |
| 感染量变化与疾病负担变化 | 年龄分层的感染、临床严重性和完整季节/多年累计记录 | 用最高一天或最高一周的压力代替多年累计负担 |
这里有一个容易忽略的比较条件:如果只从恢复传播那天开始计数,就已经舍去了前面被减少的感染;如果仅与一个特别低的年份相比,则分母本身会放大“增长”。两种比较都可以回答局部问题,但不能无说明地回答整个历史过程的得失。
对本篇主问题,能够收口的判断是:减少传播可以改变随后的人群状态,出生队列和保护回流是具体可研究的机制;状态如何变成下一轮流行,取决于接触、季节、输入与保护结构。RSV和流感研究提供了相应线索,也显示仅靠病例曲线常难以唯一识别机制。
因此,面对“现在是否还在还免疫债”,更可回答的问法是:哪一种病原体、哪个年龄队列、相对哪段基线,当前还有什么保护或感染经历差异,这个差异能解释多少新增风险?回答到这一步,才有机会区分真实的人群历史效应与一个方便但过于整齐的比喻。
计算与可回查边界
本篇自选SIRS参数以年为单位:$\mu=1/60$、$\omega=0.5$、$\gamma=52$,基准 $R_0=2.4$,季节振幅0.25,外来感染力为每年 $10^{-5}$;传播系数降低75%并维持1.5年。先在原条件下演化100年生成共同起点,再进行两世界的配对比较。长期平衡解析例子移除了季节和外来输入,另行代入两种 $R_0$。出生队列例子则只使用恒定初次感染风险率,不与SIRS联立。
代码位于仓库 research/calculations/epidemics_after_interruption.py;可下载结果与参数、基准完整轨迹及出生队列数值。计算核对人口守恒和易感收支;基准情景收紧数值容差后,峰值比差异小于百万分之一。这个检查只验证该数值例子的稳定性,不是对全部参数、唯一长期状态或真实流行的验证。
原论文的读取范围与未取得附件见来源记录。本篇没有重跑作者完整的年龄分层模型或血清推断,没有估计中国归因份额;新数据若推翻某项保护假设,模型解释也需要相应改写。