从体表读数到脑内图像,中间多了一次推断
头皮EEG首先记录电位差。脑内许多电流源的贡献经过组织叠加,再由电极、放大器与后续处理形成曲线。源定位的任务,则是根据这些曲线及头部模型,推断哪些脑内电流分布可能产生它们。
这两个步骤值得分别理解。一台设备可以稳定检出某种频段变化,但未必有足够空间信息定位其全部来源;一种定位方法也可以在特定验证中表现很好,同时仍依赖源的方向、分布和时间结构等假设。
本篇沿着“神经电流—组织—电极—参考—重建”这条链,解释信息怎样进入记录,又有哪些条件帮助我们把它读出来。
组织把许多电流源混合到每个测点
上一文介绍了神经元的跨膜电流和返回电流。对较远处的测点,一小片有组织的电流常可近似成电流偶极子:它同时具有强度和方向。多个源的电位贡献在通常采用的线性、准静态模型中相加。1 2
因此,一个测点的信号并不专属于它正下方的一块皮层。来源的方向、距离、皮层折叠、组织导电率及其他源,都影响它最后接收到的电位。头部模型常区分脑组织、颅骨、脑脊液与头皮,采用边界元或有限元等方法计算传播后的读数。2
这些方法解决的是正向问题:先给定一组脑内源,计算电极应看到什么。它们需要电极位置与头部几何配准,也需要导电率和边界条件。MRI提供很多结构信息,但不直接告诉我们每一时刻的神经电流。
将许多时刻的关系写成一条式子:
$\mathbf j(t)$表示候选源的强度,$G$表示从这些源到指定参考下电极读数的映射,$\mathbf y(t)$是实际记录,$\boldsymbol\varepsilon(t)$汇总噪声和模型没有描述的部分。更换源方向、头部模型或电极位置,都会改变$G$。
如果预先固定源的位置与方向,只求每个源的强度,这通常是线性问题;若还要搜索源的位置和数目,问题会更加复杂。测量数大于参数数,也不能单独保证一个非线性定位问题处处具有唯一解。2
参考电极也参与决定你看到了什么
EEG测量需要比较电位。最简单的记录是某一测点减去一个参考;常见的平均参考则是每个测点减去所选测点的平均值:
如果所有测点同时增加同样的电位,这个共同部分会被平均参考相消。$M$个平均参考通道之和为零,因此最多有$M-1$项独立电位差信息。这个关系说的是读数的线性结构,不能直接翻译成“大脑只有这么多个活动变量”。
参考还会影响特定源的可见性。假设两耳附近收到相似的某个源成分,相减后它可能被削弱;如果两个位置收到的成分不同,差异便可能保留。相消可以同时作用于干扰和真正的神经信号,是否有利取决于想观察什么。
所以,比较两台设备时,除了电极材料,还需要比较实际测点与参考。将头顶对平均参考的记录改成右侧颞部对左侧颞部,已经同时改变观察位置和比较方式,不能把差异全部归给电极质量。
干电极的关键,是稳定接触与完整测量链
干电极减少了对导电膏或凝胶的依赖,但仍然需要穿过头发建立稳定接触。接触压力、接触面积、头部运动、皮肤状态和电极材料共同影响界面阻抗与噪声。放大器的输入阻抗和自身噪声,又决定这类接口能否提供可用记录。3
单看接触阻抗的大小并不够。用一个只有电阻的简化接口作例子:放大器输入电阻为10亿欧姆,两路接触分别为1万与100万欧姆,单路幅度衰减都很小。然而,如果两路共同接收到1毫伏干扰,由于衰减比例不完全相同,相减后仍留下约0.989微伏的差异。
这只是本库按分压关系计算的示例,不是某款设备的实测规格。它说明为何接触不平衡和不稳定值得关注,也说明更高ADC位数不能自动补回已经被接触与空间相消改变的信息。
一个有实证依据的改进方向是机械结构。2023年的Flower电极研究比较了两种干电极帽:弯曲的接触针在受压时增加接触面积,与传统多针结构相比,参与者报告的佩戴舒适度更好。研究包含20名健康、直发参与者,两种帽在不同日期按随机顺序使用,并比较坐姿和仰卧条件。3
与此同时,平均通道可用比例约在七成上下,部分电极连接在使用中损坏;两种帽的许多群体信号特征接近,也不等于每个通道始终等效。它说明机械舒适、接触稳定和信号可用性需要一起改进,而“干电极”本身不是统一性能等级。该研究直接比较的是两种干电极设计,不能将它改写成全部干、湿设备的对决。
2026年的耳内研究:一种信号成功,不代表每种信号都一样
一项2026年研究比较了19名参与者的同步头皮与耳内脑电。头皮系统有32通道;耳内装置用右耳信号减去左耳参考,另有接地电极,实际只有一个EEG通道。采集板支持8通道,不代表本实验真的记录了8个脑电空间通道。4
较清楚的正向结果来自静息睁眼与闭眼比较。耳内静息记录因缺失片段或噪声排除部分数据后,实际纳入14人,头皮记录纳入19人。两种记录中,闭眼时α功率都增加。
| 记录方式 | 静息纳入人数 | 8—10 Hz闭眼减睁眼(dB) | 10—13 Hz闭眼减睁眼(dB) |
|---|---|---|---|
| 头皮平均参考,多通道功率汇总 | 19 | 2.89 | 2.79 |
| 右耳减左耳 | 14 | 0.89 | 0.96 |
数值转录自原表1,是各记录方式内部的条件差值;它们不是同一组完整配对下的设备误差,也不是“准确率”。
这支持该配置检出较明显的静息频谱变化,但还不足以证明两台设备等效,或耳内记录能定位α来自哪里。论文没有直接进行设备间差异检验;某种记录显著、另一种不显著,本身也不等于两种记录的差异已经显著。4
听觉事件相关电位ERP部分则有一个实质缺口:正文和表2给出的均值、检验结果不一致,连适配头皮配置的N1是否达到显著标准也不同。本文因此不据这些数字给ERP性能作精确排序。噪声中言语任务的α变化,同样只能按该研究各配置内部的基线比较来理解。
还有一些因素没有被拆开:两系统采样率不同,多通道头皮数据可以做独立成分去伪迹,单通道耳内数据没有同等分解能力;耳内接触阻抗也未量化。因此,研究展示的是这套实际组合的表现,不能单独裁定所有耳内电极、所有干接触或某一种参考方式的能力。
为什么同一组读数可以对应不同脑内源
可以把这个问题算出来。本库在无限、均匀、各向同性导体中放置96个径向点偶极源,并在更外侧安排32个测点。源的位置分布在半径60毫米的球面,测点在半径90毫米的球面;这些球面只规定位置,没有充当导电介质的边界。模型没有颅骨、脑脊液或真实皮层折叠。
单个偶极在测点的电位由其方向和相对位置计算,再对所有源求和。这个简单设置足以展示逆问题的核心,同时不冒充真实个体头部。
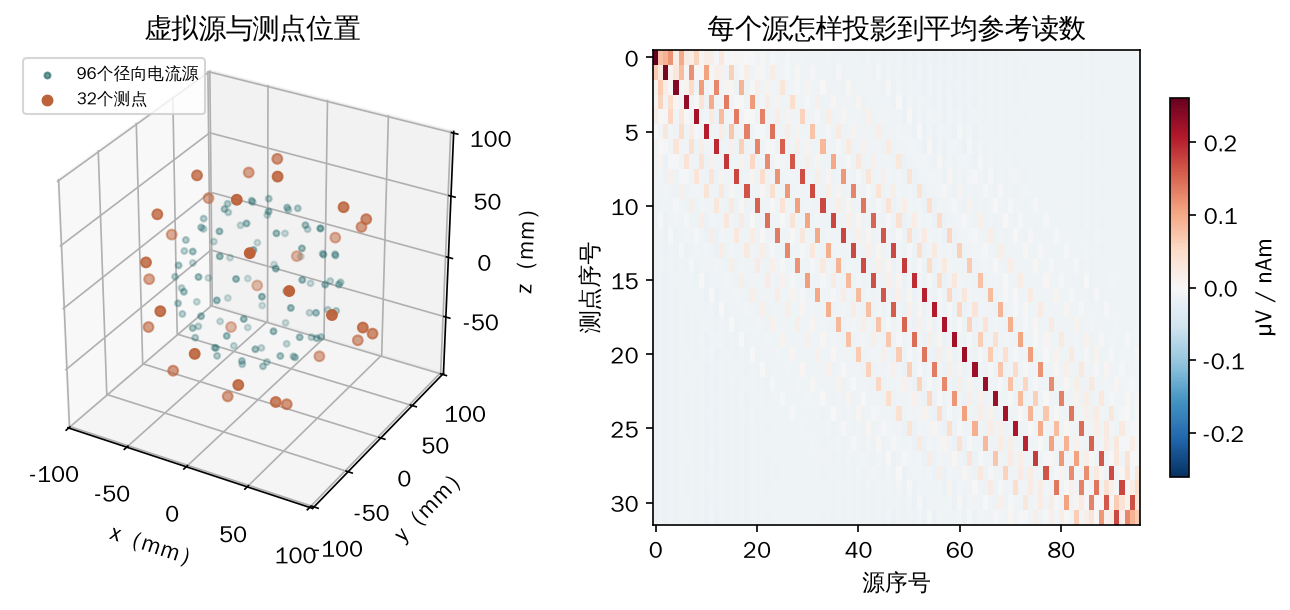
模型导电率为自选的0.33 S/m。源系数以nAm表示,读数以微伏表示;这些参数是示例输入,不是人体测量或空间分辨率标准。
计算得到,32测点的平均参考映射秩为31。对于96个自由源系数,便存在65维的变化方向可以不改变这组读数。把其中一项记为$\mathbf z$,有:
也就是说,源分布A和源分布B可以明显不同,电极读数却完全一样。这里的不可见性针对这组测点、参考和源模型,不能扩大成这个分量在任何仪器下都不可观察。
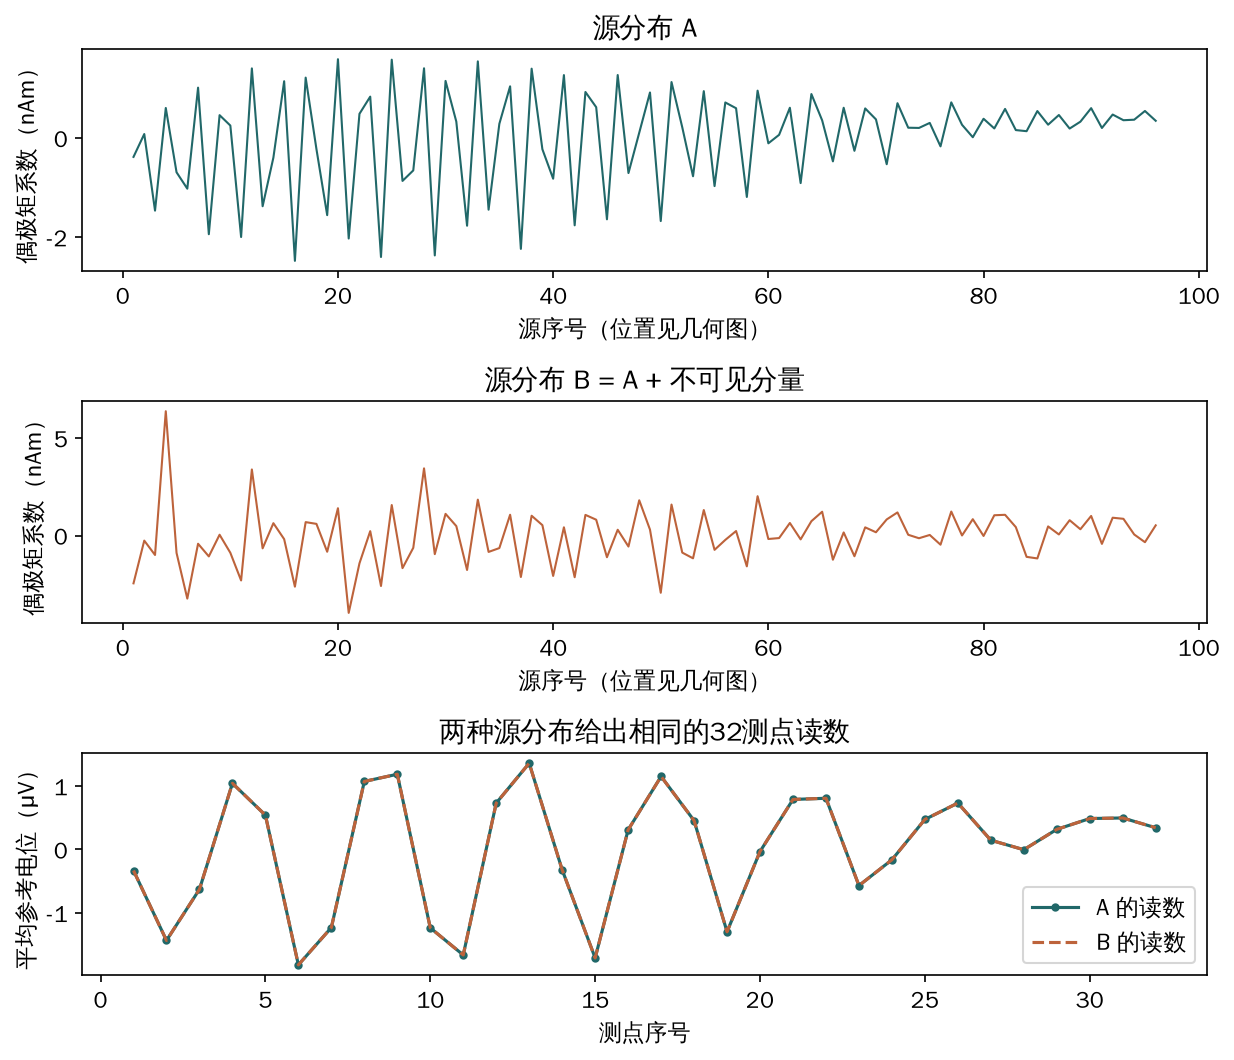
上两图的源序号只是球面采样点的编号,不代表时间,也不是相邻空间位置的排序。两组源在32个读数上的相对差异约为$4.7\times10^{-16}$,处于数值舍入精度。
把测点扩展为包含原布局的64个,映射秩升为63,前面选出的不可见分量也能在新增测量中留下差异。但96个源系数仍有33维不可见方向。更多空间测量提供了新约束,没有自动变成全部脑内活动的完整录像。
若允许每一时刻的源自由变化,多记录一些时间点也不会自动消去这种空间歧义。已知动力学、跨时刻连续性或其他模态可以提供额外约束,但那需要另行说明加入了什么信息。
先验怎样帮助重建,为什么它不是无价值的“猜测”
如果完全不限制96个源系数,会有很多解。最小范数方法从能解释读数的解中,选择系数平方和较小的一个。它提供了确定的选择规则,但这个平方和并不等于真实大脑的能耗。2
另一种办法是先限制可能的空间形状:假设源由少数平滑模式组合而成。本库用8个低阶球谐模式构造一个源,再加入1000组随机噪声作比较。
当真实源确实属于这8个模式时,受限重建的源误差中位数约为2.68%,96源最小范数约为28.80%。这说明合适的结构知识能够显著帮助推断。
但如果实际源还包含前面那项32测点看不见的分量,传感器收到的数据不变,两种方法的源误差中位数就分别变为约69.76%和74.44%。没有观测依据时,算法无法凭空认出那项分量。
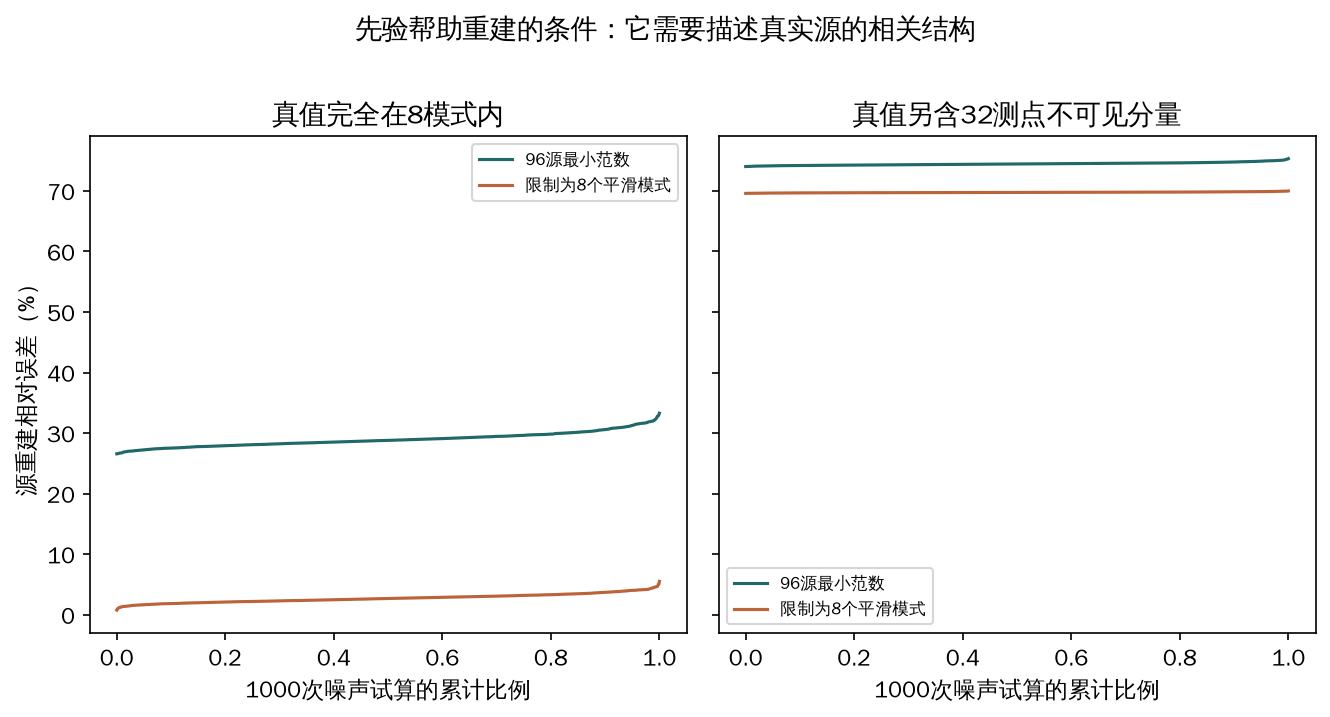
1000次自选噪声试算的误差分布,不是1000名参与者或设备验证。第一种真值就是按所选模式生成,因而它展示先验匹配时的作用,不是公平评选所有算法。源误差定义为重建与真值差向量的长度,除以真值向量长度。
还有一个容易忽视的现象:96源最小范数在这个例子里可以把含噪测点数据拟合到数值精度,源分布仍然有明显误差。8模式重建留下了一些测点残差,却在匹配条件下更接近真值。因此,“把头皮曲线拟合得更像”与“把脑内活动找得更准”不是同一项评价。
先验的价值来自它与研究对象的对应。几何、稀疏性、平滑性或已知通路都可能提供有用约束;它们需要接受外部数据和适用条件的检验,而不应仅凭有假设就被判无效。2
2026年的几何基函数方法,增加了哪一层信息
Wang等2026年的GBF方法,把每个人MRI提取出的皮层表面分解成几何模式。较低阶模式变化较平缓,较高阶模式包含更细的空间起伏;源活动用这些模式的组合来表示,再通过先验权重抑制不稳定的重建。5
用$A$表示模式矩阵,$\boldsymbol\theta$表示模式系数,便将原问题写成:
在经过噪声白化的坐标中,可以把求解理解为同时压低两部分:一部分是测量残差,另一部分是先验规定的系数惩罚。
这条路线把个体几何引入源的空间形状,区别于只使用几何计算导电路径。本文前面的球谐例子展示相关逻辑,但没有复现GBF的个体皮层网格、具体正则化和完整算法。
作者的模拟基准包含200幅由fMRI元分析空间图生成的源图,经过正向模型再添加噪声。方法在所测条件下表现出重建优势。这里的“真实噪声”主要指按真实EEG估计的空间协方差生成的噪声,不是完整重放全部自然脑电的时间结构。已知模拟源是重要验证,但fMRI统计图构造的源也不是实际逐时刻电流真值。5
其他验证进一步增加了依据,也有不同层级。任务反应与已知解剖分布相符,是有用的外部一致性;不同人群的MEG重建网络与颅内记录的群体网络对应,不等于同一人的每个源时间序列都被直接核验。研究中的皮层下扩展仍属初步,主要结论集中于皮层表面。当前框架逐时刻独立求解,动态先验是后续方向。
刺激定位和术后切除范围也提供临床相关参照,但刺激点、随后活跃的神经网络、切除腔和真正必需的致痫组织并非同一对象。该研究的术后比较选用了24名结局较好的患者,不能直接读作面向所有患者的术前预测能力。其刺激定位的时间窗口在作者稿与公开示例代码之间还有差异,本文未复现全批流程,因而不把展示的传播路径当作已逐段验证的实际神经传导。5
这些边界保留了方法的研究价值:个体几何是可检验的约束,已有若干有利验证;其作用是改善特定条件下的重建,不是让所有可能源在数学上都变得唯一可辨。
验证“真值”时,要问它究竟真在哪里
一种很直接的验证思路,是在已知位置放入电流源,再看头皮反推能否找回来。Mikulan等2020年的Localize-MI数据采用了已知位置的颅内刺激电流,对其在头皮留下的电信号做定位验证。作者明确说明,使用的是刺激伪迹,优点是发生位置清楚;把结果外推到生理信号时则需要额外判断。6
另一类数据记录刺激之后的神经反应。2022年的同步SEEG与高密度头皮EEG研究提供了这类CCEP记录,包含多个脑区对刺激的响应。它们可以帮助研究网络如何被招募,但其全部活跃源不会简单等于刺激电极的位置。7
因此,校准电流、模拟源、颅内神经活动、任务反应和临床结局,各自回答不同的验证问题。它们互相补充;一种参照上的成功,需要经过合理桥梁才能扩展到另一种用途。
怎样理解一台设备或一张重建脑图
可以先确认它实际记录哪些电位差、哪些记录可用,再看目标是检出频谱变化、测量事件波形、定位一个局部峰,还是恢复分布式动态。随后检查空间模型、参考、伪迹处理和先验,最后比较相应任务的外部验证。
目前较稳的认识是,EEG具有明确的电磁测量基础,能够保留有用的时间信息;增加可靠的空间采样、改善接触并加入适当结构约束,可以提高特定任务的表现。但电极数量、ADC位数、重建图的清晰程度和拟合优度,都不能独自充当“还原了多少真实脑活动”的答案。
本篇的整合判断是,源重建值得使用和继续研究,关键是把读数提供的信息与额外约束共同摆在明处。剩余不确定性应落到具体源、场景和参照上,而不是给所有EEG设备统一贴上“读脑成功”或“完全无用”的标签。
计算结果、源分布和测点读数可回查。模型未包含真实分层头部,原临床与硬件数据未重新采集,本篇不提供个人诊断或设备治疗建议。