一块已经学会的电路,还需要考什么
训练结束,误差接近零。把未参与训练的输入接上去,电路也做对了,这当然是有用的结果。但这些新输入可能仍沿着原来那条关系变化,也可能只是在已记住图样附近翻了几位;它们分别检验了不同能力。
判断泛化,首先需要固定三个对象:训练后保存的参数、测试输入怎样生成,以及测试答案怎样规定。本篇把测试中的导度或自旋耦合冻结,仍允许电压、位移或自旋等快速状态随新输入松弛。这样,新成绩来自已有结构的响应;它与继续训练后学会新任务可以分开比较。
两个值得区分的机制是:结构恰好保留了目标所需的关系,因而在新输入上仍正确;训练只覆盖了一部分方向,许多不同结构都能拟合,测试时才显出差异。还有两类测量问题:受扰输入是否仍含足够类别信息,多个网络的平均分数能否代表其中一个网络。本库计算与原始理论分别核这几条因果链。12
两个网络都学对,却记住了不同的输入关系
沿用前篇透明的正导度电路:每个输出通过三条边接两个输入及接地,输出为
接地导度固定为1,四条输入边可调,范围$[0.2,5]$。真实答案规定为
训练输入是200个实际生成的样本$u=(t,t)$,$t$来自标准正态分布;两输出答案由上式生成。两个网络从不同导度初态出发,用相同数值梯度规则、步长1和10000次更新。训练后冻结参数,分别得到
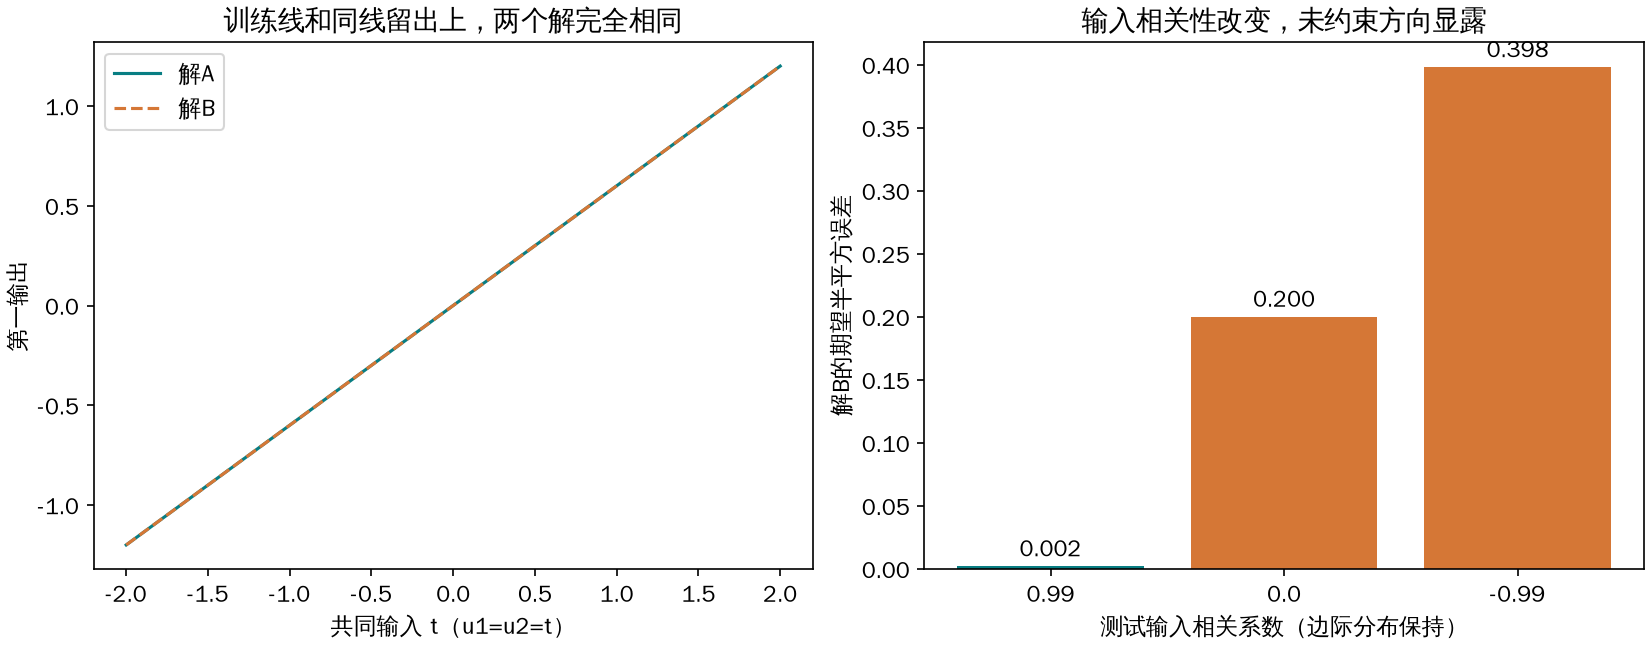
两者的训练误差都达到浮点精度,在另一批5000个同线留出样本上也一样。它们的第一输出都是$0.6t$,第二输出都是$0.5t$。即使留出样本从未出现过,测试仍只核了这两个和,不能区分各输入分别起了多少作用。
这种差异有具体的训练机制。在线上,输出只依赖$a+b$;本例的原始导度梯度对$a,b$给相同调整,因此初态中的$a-b$被保留下来。两组初态在每个输出上的导度和相同、差相反,最后获得相同训练表现和不同的冻结映射。这里没有挑两条任意函数来代表材料:它们都是同一物理网络与范围内实际训练得到的解。4
现在保持两个输入各自都服从标准正态分布,只改变它们的相关系数$\rho$。答案规则$H_*$不变,网络参数也不变。B的输出误差满足
按每样本两输出平方误差和的一半定义损失,便有
| 测试相关系数 | 精确期望误差 | 10万独立输入的实际均值 |
|---|---|---|
| $0.99$ | 0.002 | 0.001997 |
| $0$ | 0.200 | 0.198593 |
| $-0.99$ | 0.398 | 0.398445 |
A在同样测试上的误差仍为浮点精度。B的坏表现来自训练没有约束的输入方向,输入的单变量分布和标签规则都没有改变。这是一个刻意隔离覆盖问题的无噪声、理想线性例子,不代表真实任务总是沿一条精确直线采样。
扩大覆盖有用,但需要提供新的任务信息
改用200个训练样本:一半沿$(t,t)$,一半沿$(t,-t)$,每个输入仍给正确答案。初态、更新次数和步长保持原协议。两网络最后都达到$H_*$,B原先保留下来的输入差异被新方向约束。
起作用的是方向覆盖,并非训练条数增加。相应地,这个干预需要提供另一类输入及其标签,不能称为免费改善。实际有噪声时还要比较估计精度与条件数;本例只证明两独立方向在这里足够确定两输入的线性映射。
它同时给出一个容易忽略的正面边界:如果已经确定系统和答案都是同一个线性关系,并通过独立基输入准确确定了整个映射,那么换输入幅度也不会自动导致失败。此时并没有新的响应自由度可任意改变。
为接回原始记录,本库另取前篇所核Guzman等发表研究的300节点、777边最佳导度记录,冻结它以后重新生成高斯电压探针。输入幅度乘以$0.1,1,10,100$,半平方误差约为$2.55\times10^{-10},2.55\times10^{-8},2.55\times10^{-6},2.55\times10^{-4}$;除以幅度平方后都为约$2.55\times10^{-8}$。四组使用同一批标准化输入作配对缩放;完整节点求解与线性叠加也在各幅度下核对。34
绝对误差随幅度增长,归一化误差保持,是同一冻结线性映射的结果。这不验证装置在100倍电压下仍线性,也不声称这些电压超出了作者原样本范围;原始训练CSV和硬件工作范围都不在本次核验范围内。现实材料一旦出现饱和、接触变化或不同工作点,原线性先验就需要重新检验。
原自旋模型中的学习,怎样进入测试阶段
Corberi等2026预印本研究一个快慢变量系统:自旋$\sigma_i$响应输入,慢耦合$j_{ij}$保存训练结果;训练时输入与输出受外场夹持,测试时冻结耦合、释放输出,只留下输入。原分析还规定了时间尺度分离、强夹持及温度极限的次序。准备输入、标签、热浴和冻结操作仍属于协议的一部分。1
本库取得v2全文、源码包中的四页补充材料,并对S2的“2输入—1隐藏—2输出”模型穷举全部$2^8=256$组耦合与测试自旋状态。两个训练图样为$(1,1)$与$(1,-1)$,标签等于输入。在先取输入热浴相应极限、再取低温且$\beta_j/\beta_\sigma=1$的条件下,找到原文所述48个最低训练能量配置,按式S6的简并权重重算,平均保真度矩阵为
这里$K$是输出与标签的平均重叠,不是分类正确率。有限温度精确求和逐渐接近$5/8$;另一极限次序在这个小模型中趋向$1/2$。独立消去隐藏自旋,再对输出求和,得到同样结果。24
附录一处更细的列举未能复现:按其图示边顺序、式S6和正文测试定义,本库找到12组完美记忆配置,总权重$1/4$,而S14称8组及$1/8$。直接微观态枚举和独立消元一致,原页图与逐项核验已留存;S14所列配置的输出也与“完美”条件未对上。这一差异限定在该列举及概率,48组与$5/8$复算仍一致。下文的对称性检验使用明确列出的本库重算子集,不把原附录概率当作依据。
物理对称性,能把已见输入连接到哪一些未见输入
在这个没有额外偏置场的自旋模型中,同时反转所有自旋不会改变相互作用能。输入从$S$换成$-S$时,平衡平均输出必然满足
因此,对两个已见图样都准确输出原标签的配置,也会对另外两个未见图样$(-1,-1)$与$(-1,1)$准确执行恒等关系。这个新输入表现由物理对称性与任务规则共同支撑。
现在考虑另一种可能的标签规则:输入第一位为正时仍输出$S$,第一位为负时输出$-S$。它在两个训练图样上给出完全相同的标签,但不满足上述奇对称。冻结的同一批完美记忆配置,在四个输入上对恒等规则的正确输出位比例为100%,对另一规则为50%;未见的两个输入上则分别为100%与0%。4
这是两个与训练信息相容的任务续延,不能由原训练标签判定哪一个才是现实规则。物理结构提供了明确的归纳偏置:它排除了非奇对称映射,使恒等任务的新输入更容易确定;如果目标确实不具备该对称性,同一偏置也会成为能力限制。改变偏置场或网络结构后,要重新核可实现集合与测试关系。
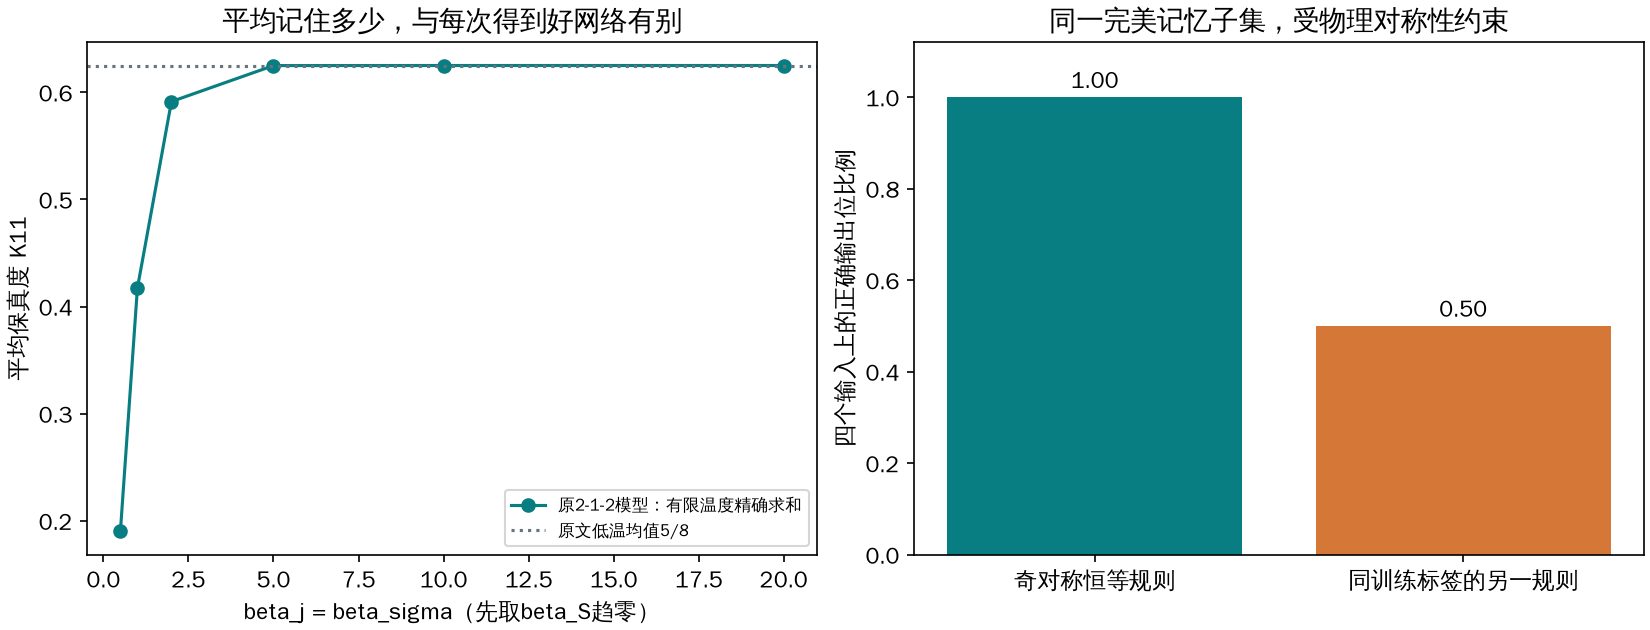
图左是原小模型的精确求和,图右是本库在零温完美记忆子集上增加的未见输入对照。这里没有把训练中改变温度,解释成测试时继续调整耦合。
翻转一位以后,输入可能已经无法唯一指向原图样
原文的泛化测试,是翻转训练图样的一部分输入位,检查输出是否仍识别原图样。这个任务要先问:受扰输入是否可能由不同原图样产生?1
本库用四行Hadamard图样作一个可穷举的对照,类别等概率,每次恰好翻转一个均匀选取的输入位。共有16种“原类别—翻转位置”组合,却只形成8个不同受扰输入:四个只能来自一个类别,另外四个各可来自三个类别。
只观察受扰输入、也完全知道这套生成规则的最优强制分类器,平均正确率上限为
在三个来源等可能的输入上,无论固定选一个还是等概率猜一个,只能选对其中一个来源。若要求后验分数有唯一最高项,歧义输入不计识别成功,比例为$1/4$。前者是允许打破平局的强制决策上限,后者是这套对称后验的唯一最大值比例,二者不能互换。
为接上物理响应,本库再从原架构去掉隐藏单元,构造“4输入—0隐藏—4输出”的双部自旋网络。完整枚举65536组正负耦合,4096组达到最低夹持训练能量;冻结后对全部输入和输出微观态求和。这个适配的平均输出恰为$\bar f(S)=3S/8$,干净图样按平均分数可以全识别,翻一位后严格识别比例为$1/4$。它展示了结构、图样几何和判别规则如何一起决定成绩;它不是原论文有隐藏单元的Table II复现。4
这也没有证明“泛化只能做到25%”:换编码、噪声模型、类别先验或平局处理,数字都会变。输入位翻转测试测的是指定噪声下的图样识别,不自动检验对任意新标签关系的学习。
先平均再判别,与先判别再平均不同
上面的4096个冻结网络还给出一个额外检查。先平均它们的输出分数,干净图样严格识别率为100%;逐个网络判别、再平均正确率,却只有40.625%。在受扰图样上,两种次序分别为25%与约23.05%。这个适配中,没有一个网络能严格识别全部四个干净图样,跨网络平均却可以。4
原因是判别有最大值和并列条件,是非线性操作。不同网络的偏差可以在分数平均时抵消,因而
没有一般相等关系,这里$s_j$是网络的分数,$\mathcal D$是判别操作。原预印本已把耦合平均解释为多次重复后冻结网络的统计量;本篇把平均次序另算出来,帮助区分平均响应、随机取得一个网络的成绩,以及实际部署多个网络共同读出的成绩。1
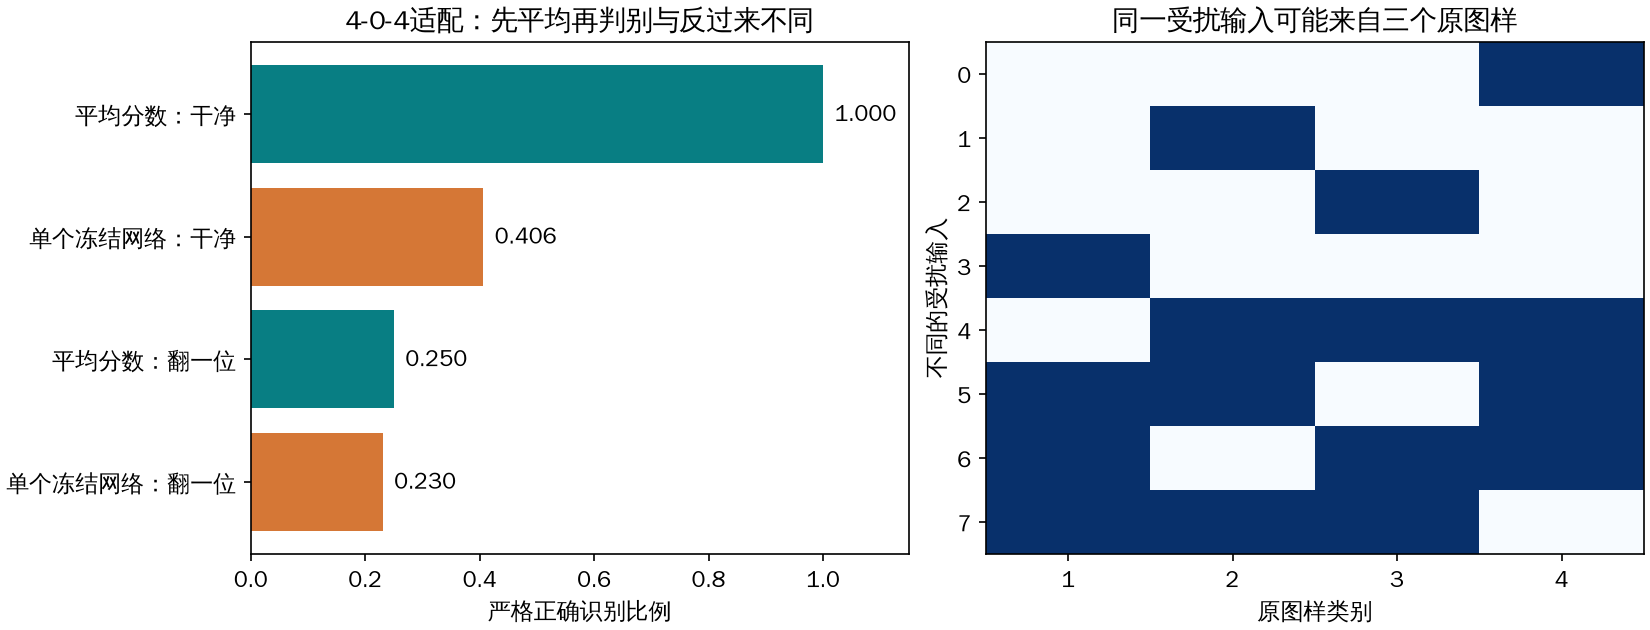
左图所有比例都来自本库4—0—4适配,并采用严格最大分数、平局不计正确的同一规则。右图显示8个受扰输入分别与哪些原类别相容。多个网络共同读出若要成为真实装置,还需要保存、重复训练与读出资源,本篇没有标定这些成本。
怎样把下一次泛化测试做得更有解释力
这篇结果没有给物理学习一个统一泛化分数,而是给出可以逐项验证的机制。冻结参数后,先确认新输入是否提供了不同方向;目标规则与物理对称性是否匹配;扰动是否保留了来源信息;统计成绩究竟属于单个网络还是跨网络平均。
| 想检验的能力 | 需要明确的测试 | 本篇的边界 |
|---|---|---|
| 同分布未见样本 | 样本分开,覆盖哪些关系也分清 | 同线留出不能检出未约束输入方向 |
| 输入相关性变化 | 保持标签规则,匹配单变量分布 | 本例可由冻结映射与协方差精确计算风险 |
| 幅度或范围外输入 | 核原模型在新幅度是否仍成立 | 理想线性叠加不等于硬件任意幅度有效 |
| 受扰图样恢复 | 规定噪声、类别及平局处理 | 重叠的来源可能使输入本身含歧义 |
| 未见输入的功能关系 | 说明结构先验及相容任务续延 | 对称性支持特定规则,也排除另一些规则 |
| 随机冻结一个材料的成绩 | 逐个评价,再按明确分布汇总 | 跨网络平均分数不能替代这一量 |
本库已核的是小系统中的确切机制、原小自旋模型及固定大网络的理想静态响应。更大热力学模型的完整配置分布、有限时间训练、真实器件的电压范围和多网络读出开销仍未核实。后续研究跨时学习和动态任务时,需要继续保留这里的冻结与独立测试标准:训练协议改变了材料,并不单凭训练误差就决定它在什么新条件下仍会做对。