前一个状态留下了什么
设一条连接在自由响应时测到信号$s_f$,施加目标约束后测到$s_c$。局部对比学习希望按$s_c-s_f$改变参数。同一个网络先后经历这两个状态,第二次测量到来时,第一次的影响必须仍以某种形式存在。
最直接的办法是保存读数,再相减;也可以使用两套网络同时比较。还有一种办法:让连接内部的反馈状态保留近期历史,使它对变化产生瞬态响应,再从响应里提取方向。Falk等的时间对比学习提出了这一机制,承重对象是理论模型和数值模拟,材料、分子及纳流体实现则是方案。1
这里需要比较三个解释:输出确实提取了自由与目标状态的差;输出只是未消退的历史或背景偏置;差的信息由外部协议组织好了,局部动力学负责读取。后两种并不互斥,也不因连接没有数字存储器便消失。本篇先把一条连接的因果过程算完,再接回任务误差和原始方法。
有记忆还不够,关键是消背景和选方向
若更新信号只是过去信号的正加权平均,恒定的$s$也会持续驱动参数。它保存了历史,却没有自动得到$s_c-s_f$。对比器需要先消除恒定部分。
写局部响应为
在信号相对记忆时标变化较慢时,展开$s(t-a)$可得
$I=0$消掉常数背景;取$M_1=-1$,响应近似信号的变化速率。后者只是增益归一化,实际装置可以使用其他增益并调整学习率。这个近似还要求记忆尾部相对信号变化足够短,不能仅凭核的正负面积抵消便套用。2
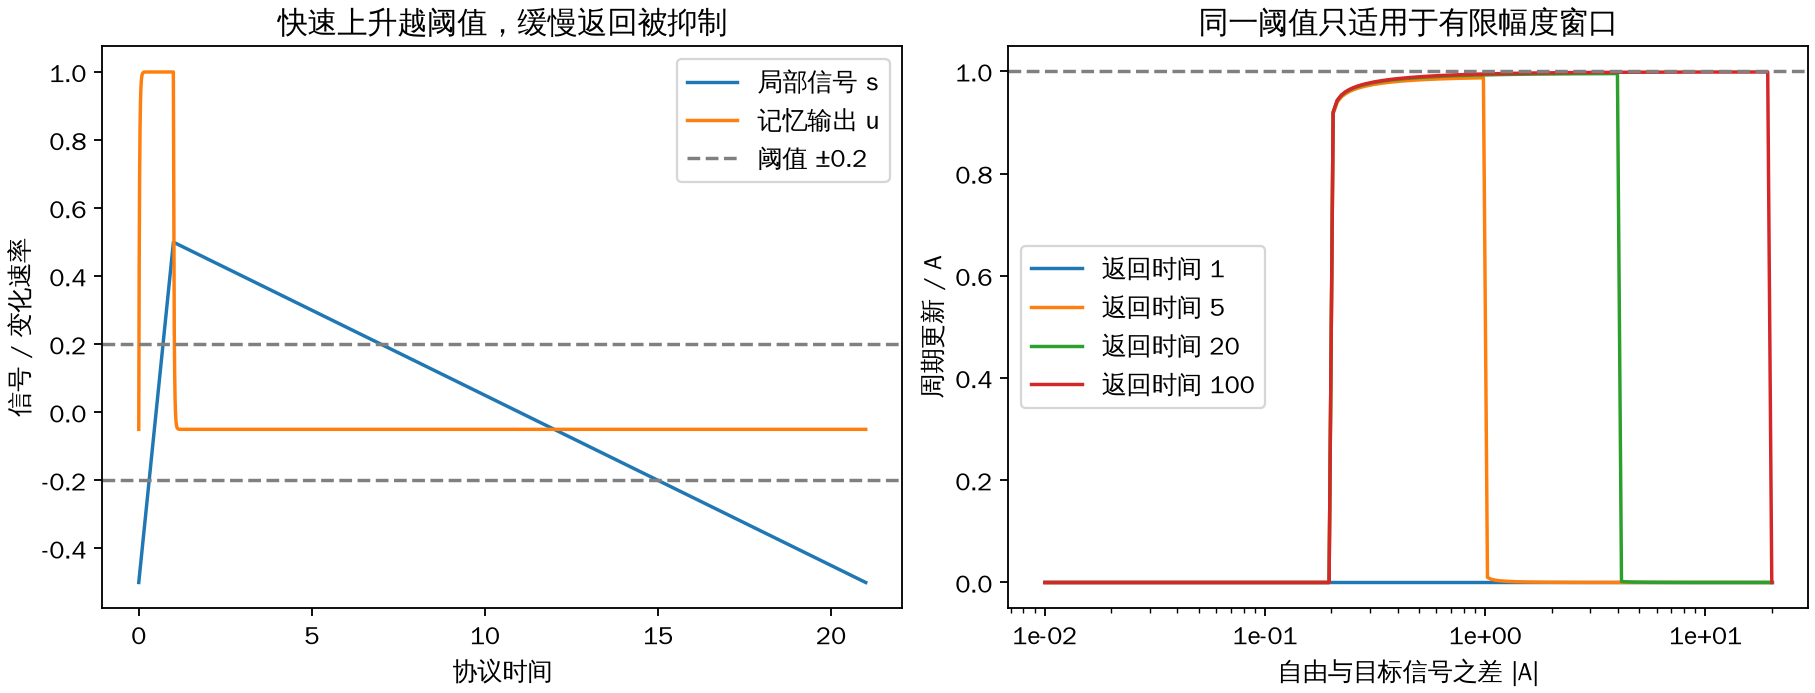
但变化速率本身仍不够:如果先从$s_f$到$s_c$,再返回$s_f$,一整周期的线性积分为零。要留下一个方向,必须让两段变化受到不同处理。 原方案让转向目标的过程快、返回自由状态的过程慢,使用固定的局部阈值
快速段越过阈值,缓慢返回被抑制,于是周期更新近似正比于$s_c-s_f$。规则在连接处始终一样;方向信息的一部分由外部呈现节奏提供。
一个能逐步算清的局部记忆
本库采用原研究讨论的Maxwell/RC型高通响应,作为明确的教学适配:
$m$是随信号缓慢改变的内部状态。恒定输入最终使$m=s$、$u=0$;刚改变输入时,$m$来不及跟上,因而产生瞬态。消去$m$即得$\tau\dot u+u=\dot s$。该模型的因果核包含瞬时项和指数尾:$K(a)=\delta(a)/\tau-e^{-a/\tau}/\tau^2$,面积为零、第一矩为$-1$。它与作者用于数值扫描的光滑多项式核不同,也没有给出一个实际制造完成的元件。
记忆在$m$里,学习结果在$w$里;两者承担不同角色。这里的“隐式”指没有把两个读数分别写进专门存储单元,并非内部没有承载过去的自由度。
让$s$从$-1/2$线性上升到$1/2$,再返回,取记忆时标$\tau=0.02$、上升时间$t_f=1$、返回时间$t_s=20$、阈值$\theta=0.2$。所有时间均为本例的任意单位,$\epsilon$暂取1。计算使用重复协议的周期稳态;在斜率$v$不变的一段上,
按越过$\pm\theta$的实际时刻分段积分,一周期更新为 0.993126,理想两状态差为1。上升段贡献0.978561,返回初期还留下0.014565;不能把有限记忆下的整个返回段说成严格零。5
保持其他条件,几种干预能够区分机制:
| 干预 | 周期更新 | 解释 |
|---|---|---|
| 上升1、返回20 | 0.993126 | 阈值大体区分快慢两段 |
| 上升1、返回1 | 0 | 对称协议抵消 |
| 上升20、返回1 | −0.993126 | 快速方向反转,更新随之反转 |
| 删除阈值,保留线性响应 | 0 | 周期变化率的积分为零 |
| 差值仅0.1 | 0 | 两段都不足以触发更新 |
| 差值增至10 | 0.000472 | 返回也越阈值,几乎相互抵消 |
| 记忆时标改为2 | 0.405932 | 有效响应不能及时追踪斜率 |
这些数来自精确段解;另一份计算用独立ODE积分及阈值过点核对,最大更新差小于$2\times10^{-13}$。它证明这组方程的行为,不证明任意材料只要有滞后就会学习。
有效窗口由误差信号和节奏一起决定
设差值幅度为$|A|$。忽略拐点附近的有限记忆瞬态后,上升和返回的响应幅度分别约为$|A|/t_f$与$|A|/t_s$。让前者通过、后者被抑制,需要
若同一个阈值要覆盖$A_{\min}$至$A_{\max}$的全部信号,就需要
这解释了为什么扩大幅度范围需要更强的时标分离,也解释了训练后期的困难:误差越小,对比差越可能掉进不更新区。原SI给出同类条件;本例还保留了有限记忆造成的偏差。2
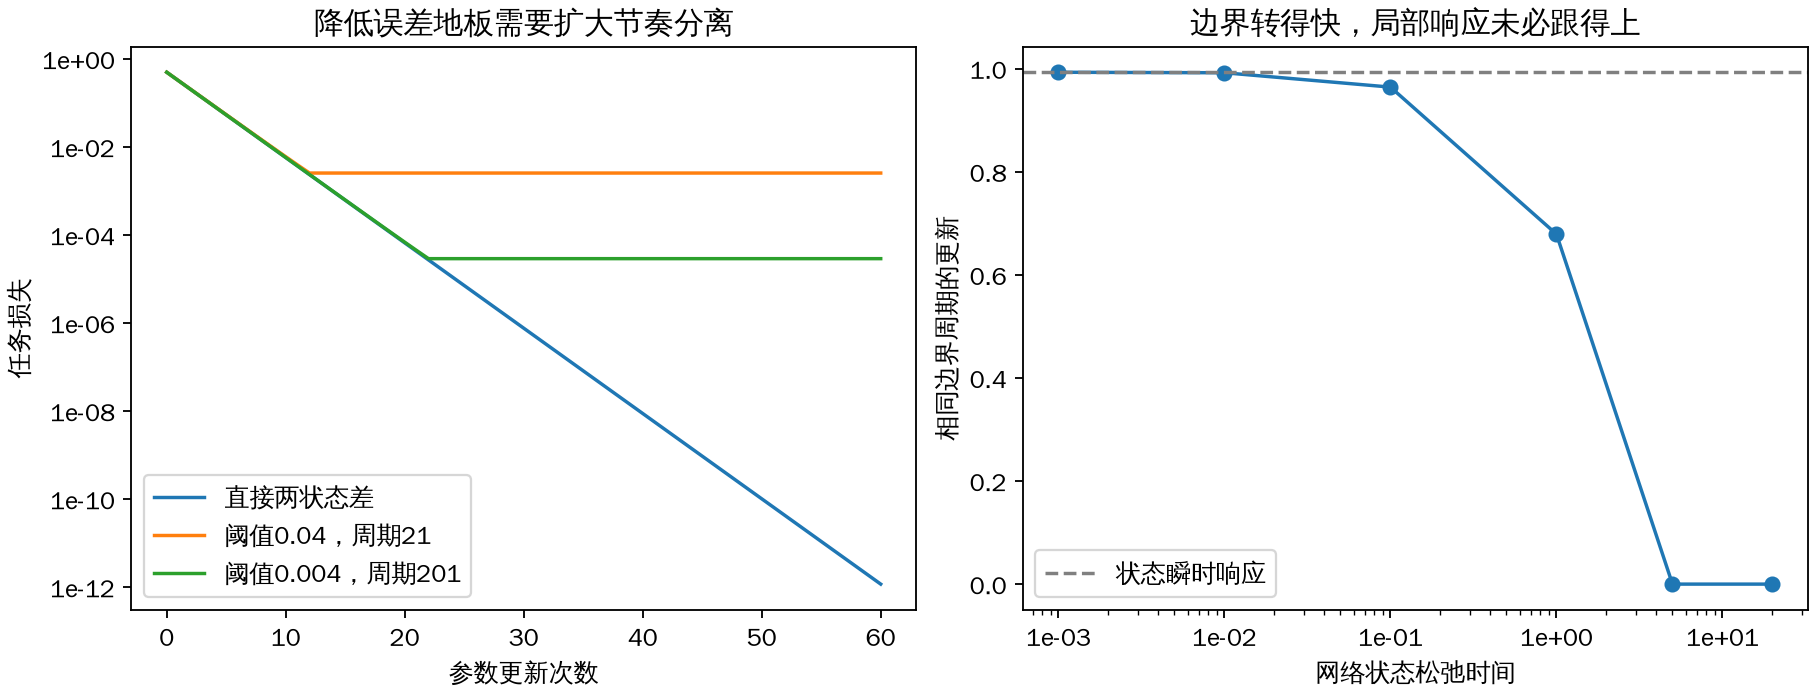
至少还要核两种松弛。网络的电压、位移或神经元状态得跟得上边界变化;局部比较器也得跟得上信号变化。可用的充分分离是$\tau_{\rm state},\tau_{\rm memory}\ll t_f\ll t_s$,同时学习参数在测量一个周期内改变足够小,或按明确协议暂停调参。并不要求前两个时标彼此有固定先后。
为隔离第一种问题,本库在边界锯齿与局部记忆之间加入$\lambda\dot x=s_{\rm boundary}-x$,比较器接收$x$。同样边界幅度、节奏与阈值下,$\lambda=0.1,1,5$时更新分别约0.9643、0.6790、0。独立两状态ODE与精确响应采样的差小于$4.7\times10^{-5}$。边界转得快,不保证远处连接收到同样快速的变化;需要核的是实际局部信号。
还有一个边界:真实网络里$\beta(t)$的线性变化未必使每条连接的$s(t)$线性变化。相变、饱和、迟滞或不同节点的时标,会改变阈值窗口。原单连接锯齿近似与整网训练效果之间,不能省掉这座桥。
更新接近两状态差,是否真的减少任务误差
用最小能量模型$E(y;w,x)=y^2/2-wxy$接回任务。输入$x=1$时,自由状态$y_f=w$;目标$y_*=1$。训练施加弱约束,将输出端移到$y_c=w+\beta(1-w)$,取$\beta=1/2$。连接测到的共轭信号是$s=-\partial E/\partial w=xy$,因此
直接两状态更新$w\leftarrow w+\eta A/\beta$就是这个任务的梯度下降。时间方案则把实际积分$d$代入$w\leftarrow w+\eta d/\beta$。本库从$w=0$出发,取$\eta=0.2$,执行60个周期:
| 更新方案 | 最后$w$ | 任务损失 | 呈现协议时间 |
|---|---|---|---|
| 直接两状态差 | 0.999998 | $1.17\times10^{-12}$ | 未为其装置标定时间 |
| 阈值0.04,$t_f=1,t_s=20$ | 0.928391 | 0.002564 | 1260 |
| 阈值0.004,$t_f=1,t_s=200$ | 0.992370 | 0.00002911 | 12060 |
| 第一种阈值,反转快慢方向 | −0.750760 | 1.532581 | 1260 |
正向方案逐次降低损失,最后因对比幅度不足而停止;降低阈值并拉长返回时间,能够继续接近目标。反转协议则从第一次更新起增加损失,直到信号再次落在其失效区。对一个二次任务,若令$r=d/A$,精确下降条件为$0<\eta r<2$;正确的符号还需要适当步长。5
这里每周期内固定$w$,周期末统一更新,并以当前重复协议的周期稳态初始化比较器。这是可检查的离散闭环计算,暂停、初始化与时序也算资源;它没有复现连续自主调参,未检验任意换样本历史。表内时间只累计本模型的呈现周期,不含复位或外部控制代价;不能据此宣称比数字训练节能或更快。
怎样排除“只是历史还没散掉”
周期稳态是一个重要条件。让本例的自由与约束信号完全相同、即$A=0$,但比较器带着前一过程留下的$u(0)=0.5$,仍会在衰减到阈值前产生更新0.006。它没有包含任何当前任务的对比差。等一个记忆时标后才开启更新,初值降到$0.5/e<0.2$,这个伪更新消失;等待期间若继续学习,则已经发生的更新不会自动撤销。
这个对照比“换一个顺序还能训练”更有判别力。可以在相同当前边界下改变前一试次、等待时长或是否冻结学习,检验更新是否仍指向相同任务梯度。还应分别测保持恒定信号时的响应是否回零、改变背景但保持两状态差时更新是否不变。
背景泄漏也会伪装成有用方向。在本例加入$u_I=u+Is$,取$I=0.001$、背景均值25,同样差值1的更新从0.993126变为1.019310;零面积模型单纯把背景平移25则完全不变。慢变化展开给出的额外快段贡献近似$I\bar s t_f=0.025$,余差来自阈值过点和有限记忆。这要求返回仍被抑制,不能把该近似用于背景项已让整段返回通过阈值的情形。
因此,等待更久有两面性:它可消除试次初值,也可能增加非零面积响应累积的偏置。判断实际装置,需要同时记录初值、恒定背景响应及学习开关。
接回原论文:哪些结果已经得到,哪些仍是方案
发表研究的MNIST网络有784输入、500隐藏、10输出节点,训练用10000样本、测试用2000样本。其SI记录:在若干离散约束强度上松弛,保存相应时间序列,插值为快升慢降协议,再卷积和更新;还使用跨样本的持久粒子加速状态松弛。12
这为算法提供了数值证据,也明确保留了数字存储与运算作为物理反馈的模拟代理。局部规则的模拟可行性、反馈元件的物理可制造性,以及整网无人代算的实际训练,是不同的证据层级。
本库取得原Figshare五个数组并逐个核验校验和。手写数字曲线包含51项;索引35的训练错误率为0、测试错误率为4.2%,末项测试为4.05%。它支持正文“约95%”的量级,本库没有重新训练MNIST。动态范围、背景偏移和耗散数组也取得,但后两者分别只有744/1000与4257/5000行全为有限数;未把存档中所有数值都当有效结果,亦未重做原随机扫描。4
为核对机制而不是只重画存档,本库执行固定版本作者单连接代码中的原核、锯齿、卷积和阈值方法。在显式采用的较粗步长0.0005、$t_f=2,t_s=10,\theta=3$下,原零面积参数核对幅度10、20、40给更新约9.426、19.322、0.123:中间有效、大幅度返回抵消的行为与本库简例一致。独立FFT循环卷积核对整周期离散和;作者梯形积分的端点差单列,未把它们混为完全相同的积分。3
作者卷积采用周期边界,这等效于重复当前协议的历史,不能直接代表第一次呈现或换样本后尚未复位的物理记忆。适配代码、原单连接数值和原整网成绩各自支持不同范围的判断。
耗散账单能算到哪里
原研究另用2×5状态的可逆马尔可夫梯形网络生成适应响应。在该模型里,双向通量$J_{ij}=Q_{ij}p_j$给出稳态熵产生率
这里$Q_{ij}$表示从$j$到$i$的跃迁率。SI的S62分母印成与分子相同,正文和原代码使用逆向通量;本库按后者核,而没有据印刷式把耗散算成零。123
本库实际执行原率矩阵和耗散方法,另独立构建相同跃迁矩阵、求稳态并核微小信号响应。固定垂直率尺度25、背景信号0,驱动参数$\gamma=1,0.1,10^{-4},10^{-8}$时,熵产生率约为$0,1.762,8.915,17.835$,单位为$k_B$/模型时间。矩阵与独立实现逐项一致,稳态灵敏度与另做的有限差分核对。
这个新增探针也给出一个有用限制:把小信号核归一化为第一矩$-1$,强驱动下的面积从$\gamma=0.1$时约0.254降到$10^{-8}$时约0.127,尚未逼近零。整个参数区间并不单调;固定有限状态范围、率尺度和背景的系统,不能只凭驱动增加便假定完美适应。这个结论限于本次线性响应探针,不替代原论文改变多个参数、使用有限阶跃及拟合偏移的扫描,也未单独确证残余的唯一成因。
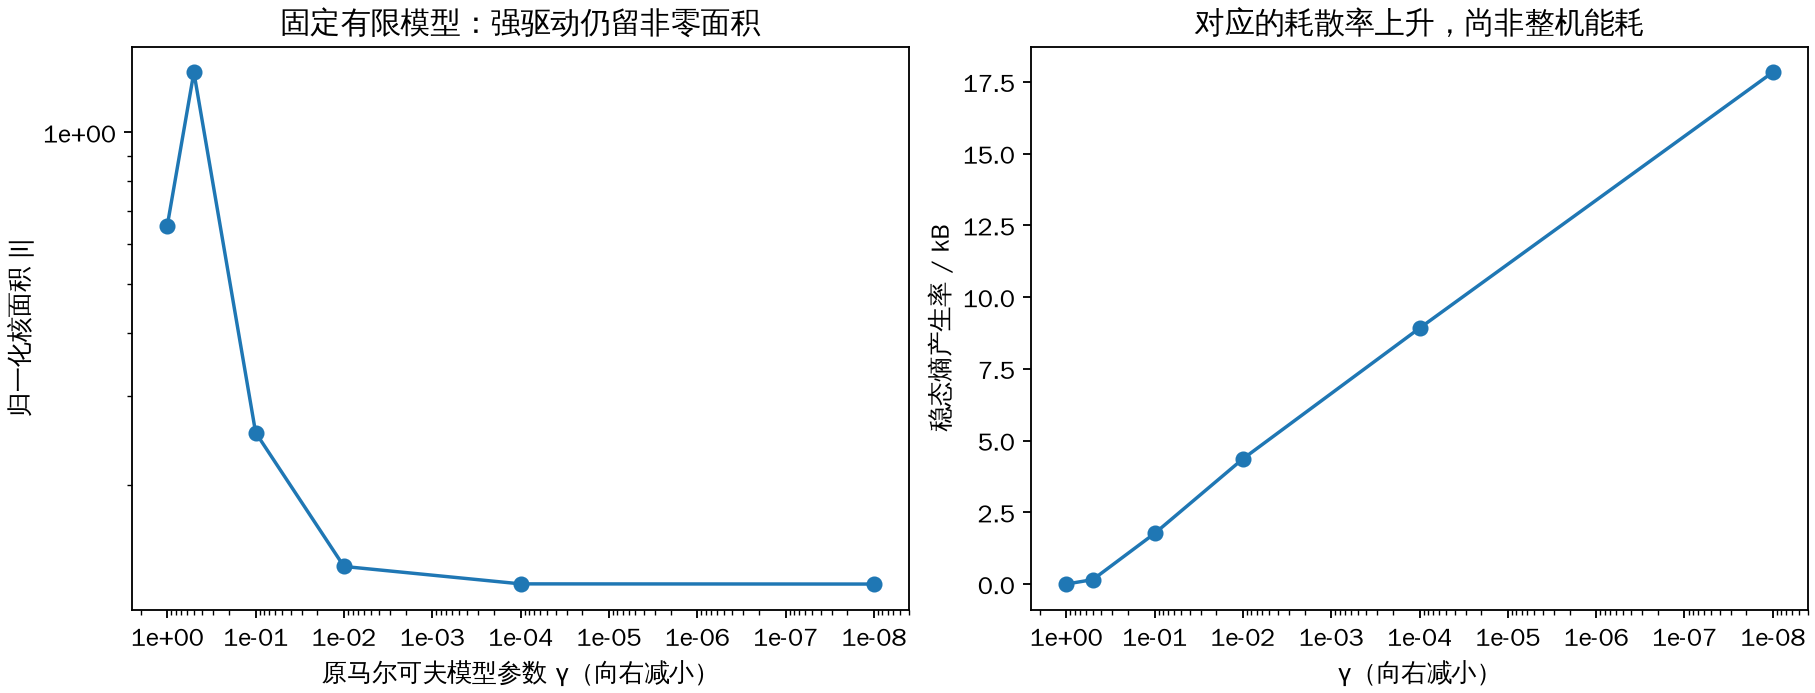
熵产生率乘温度才成为该热浴模型的功率,还须对时间积分才能得到每周期能量。换物理时间尺度,数值速率也会变化。外部边界驱动、标签生成、测量、参数保持及控制器并未被这项反馈账单全部覆盖;高通响应的存在也不足以替任意被动元件指定同一个热力学下界。这里可承重的是指定微观模型中的代价与响应误差,不是所有学习系统统一的“每次学习耗能”。
这条机制在哪些条件下可信
跨时对比的最小因果链已经可以说清:内部状态保留近期历史,反馈消除恒定背景,非线性阈值按节奏选择瞬态,参数调整再把任务相关的变化保存下来。正确答案仍须通过边界约束到达网络;目标方向与呈现节奏必须配合。
本篇较稳的是这组局部方程、阈值窗口和闭环任务的计算关系,以及原数值方案的实际范围。仍未决的是连续调参和换样本下的误差控制、整网不同连接能否共享阈值窗口、真实元件长期稳定性,以及计入控制和保持后的整体成本。
检验一个新装置时,最有用的证据不是只看训练曲线下降,而是让同一当前任务经历不同前史,改变快慢方向与等待时长,并独立测局部两状态差、实际更新和任务损失。只有三者在条件改变后仍按预期相连,才能把“有历史响应”推进为“利用历史完成纠错”。