为什么“它总要经过我的起点”这个直觉会失效
若用同一条牛顿冷却方程描述两个物体,初温较高的那个不可能先到达相同的更低温度。因为温度就是完整状态:同一时刻、同一温度,下一刻的变化也相同,后面的轨迹无法从前面的轨迹旁边绕过去。
但快速离开平衡后,很多系统不能再由一个温度概括。两个平均能量相似的分布,可能把概率放在完全不同的位置;一个主要需要局部调整,另一个还需要等待罕见的跨势垒跃迁。此时,“经过相同温度读数”不等于“经过相同完整状态”。1
本文研究的Mpemba效应采用受控定义:最终动力学和目标态固定,比较不同初态到达同一精度标准所需的时间。初始更远的状态,如果后来更早达到标准,就出现了反常的松弛排序。主要例子使用不同温度的平衡分布作为初态,再让它们共同趋向同一个更低温的热平衡;量子部分则明确改为一般稳态。
这里的“到达”需要一个精度界限。许多模型只在无限长时间才严格等于目标,在实验中也只能判断误差是否已经小到无法分辨。本文不会把有限时间内测得接近平衡,写成数学上已经精确相等。
胶体实验实际改变了什么
Kumar和Bechhoefer在2020年的实验中,用光镊反馈产生一个可控的双阱势,让水中的单颗粒从指定位置释放后扩散。重复1000次,便能在每个时刻估计颗粒位置的概率分布。势阱内移动较快,两个阱之间重新分配概率较慢。2
有一个实验细节非常重要:水浴始终保持同一温度。 论文中的初始温度 $T_{\mathrm{initial}}=1000T_b$,并不是说把水真的加热到千倍温度。研究者先算出
再按这个分布抽取起始位置,用光镊把颗粒放到那里。释放之后,它始终在相同的真实水浴和最终势形中演化。这样实现的是高温平衡位置分布的制备与骤变后松弛;后续非平衡分布通常不再对应任何单一温度。2
作者用位置直方图之间的L1差异衡量离平衡多远:
$\pi$是水浴温度下的平衡分布。初始温度比为1000的样本,这个距离起初比温度比为12的样本更大,却先降到平衡对照的噪声范围。我们从论文公开表格重绘了这组结果;没有重新生成实验轨迹,也没有把每个时间点当作独立实验。3 8
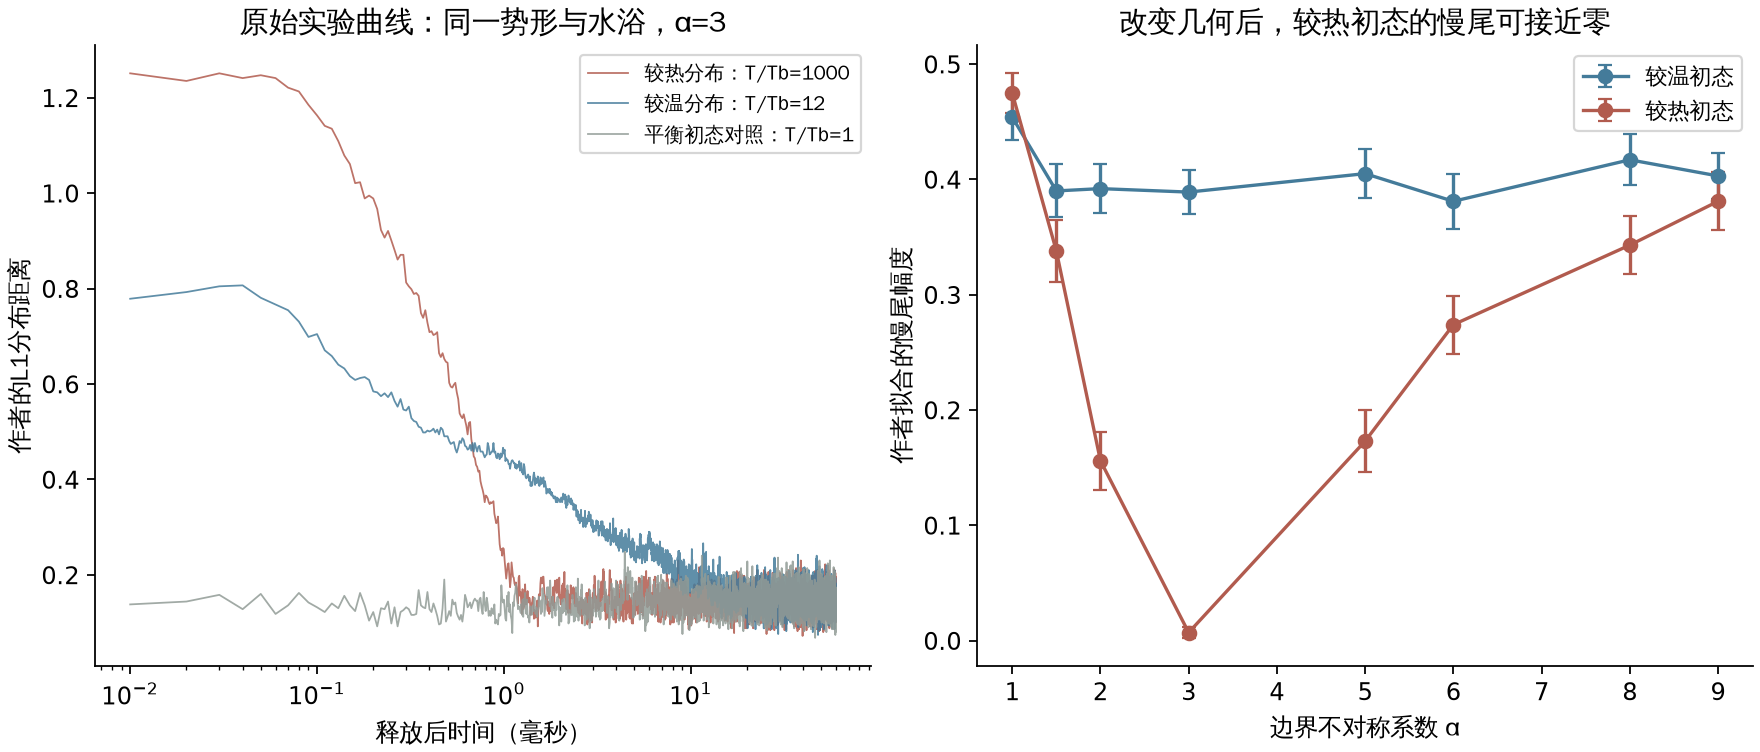
这个结果依赖势形。作者保持阱结构的主要部分,改变两侧边界相对宽度,定义 $\alpha=|x_{\max}/x_{\min}|$。边界近似对称时没有出现同样的加速;在合适的不对称程度下,更热的初态留下的慢尾非常小;进一步改变不对称程度,这个优势又减弱。2
一个直观解释是:极高初温使起始位置几乎均匀分布,左右两侧最初分到多少概率,主要由空间范围决定。若这些概率恰好接近低温平衡要求的阱间分配,颗粒只需较快地向各自附近的阱底移动,较少需要等待跨阱重新分配。较温初态虽然整体更集中,阱间比例却可能更不合适。局部已经接近,不等于最慢的那部分也接近。 这是快慢分离下的图像,精确条件仍要看完整动力学。
慢尾从哪里来
在有限状态Markov模型中,概率分布满足
$R_{ij}$ 表示从状态$j$跳到状态$i$的速率。固定水浴、势形和耦合方式后,$R$不随初始温度改变。若系统连通并满足详细平衡,就有唯一热平衡分布$\pi$,其他偏差会逐步衰减。1
可以把这些偏差拆成几个有不同衰减速度的形状,称为松弛模态。为了避免正负号混淆,本文把衰减率写为正数 $0<\mu_2<\mu_3\leq\cdots$:
$r_2$是一种变化得最慢的分布形状,$a_2$则表示初态带入了多少这种偏差。它不是初态到目标的总距离。某个初态总偏差很大,但大部分落在快速衰减方向上;另一个总偏差较小,却留下更多慢模态,后来反而会落后。1 4
普通的加速可以只来自 $|a_2|$ 较小:长时概率偏差都按同一个 $\mu_2$ 衰减,但一个尾巴从较低的位置开始。强Mpemba效应要求更进一步:在最慢模态不简并的情形下,若特殊初态使 $a_2=0$,而下一模态仍被激发,长时衰减便由更快的 $\mu_3$ 接管。初态没有改写系统的衰减谱,而是改变了哪些模态实际参与。4
还不能把“投影”随手当成普通欧氏点积。一般速率矩阵的右特征向量不正交;系数应由配套的左特征向量提取。若归一化为 $\ell_i^Tr_j=\delta_{ij}$,则
本篇计算使用了详细平衡对应的加权对称化,核对左右向量配对后才求这个系数。这个步骤决定我们是否真的去掉了慢模态,而不是只把某个任意方向上的分量算成零。
三个状态,把路径和等待时间算出来
采用原始理论中的Arrhenius跃迁形式:
其中势垒对称,$B_{ij}=B_{ji}$,每列对角项设置为其余跃迁率之和的负值。这使概率守恒,并满足 $R_{ij}\pi_j=R_{ji}\pi_i$。1
本篇选择三态能量 $(0,0.1,6)$,三个势垒为 $B_{12}=10$、$B_{13}=6.2$、$B_{23}=10$。能量以 $k_BT_b$ 为单位,温度以$T_b$为单位,时间以共同尝试频率$\Gamma$的倒数为单位。这组参数用于展示机制,不是对胶体实验的拟合。 状态3很容易降到状态1,状态2与其余状态之间的调整却慢得多。
共同目标分布约为
取较温初态 $T_w=1.5$,再沿热平衡初态曲线求解 $a_2(T_h)=0$,找到非平凡根 $T_h\approx2.128690$。两组初始概率分别为:
| 初态 | 状态1 | 状态2 | 状态3 | 初始TV距离 |
|---|---|---|---|---|
| 较温,$T_w=1.5$ | 0.511817 | 0.478809 | 0.009374 | 0.012480 |
| 较热,$T_h\approx2.128690$ | 0.496575 | 0.473786 | 0.029639 | 0.028340 |
这里 $D_{\mathrm{TV}}=\frac12\sum_i|p_i-\pi_i|$,是实验L1定义的一半;后面的阈值全部按TV定义。较热初态在TV和KL散度下都更远,却把最慢系数压到了数值精度附近。两种初态使用完全相同的$R$,没有给较热系统换一个更快的环境。本篇计算
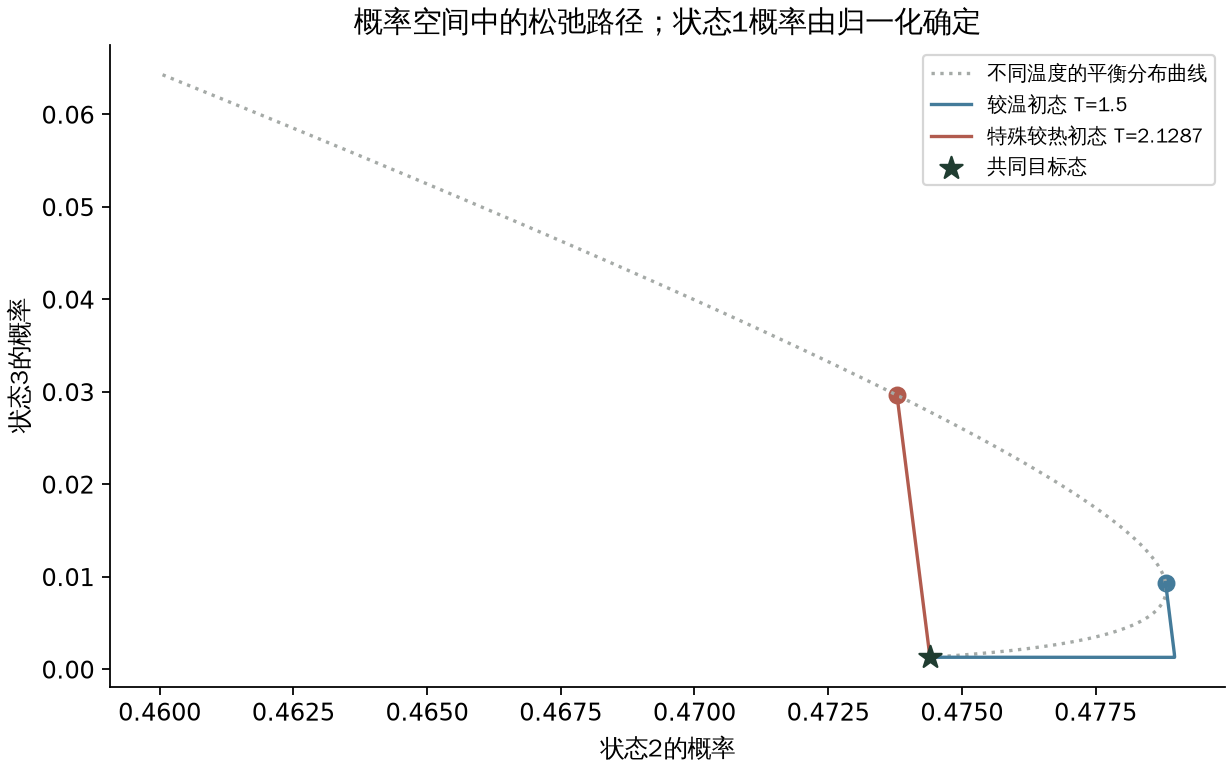
注意较热初态的状态2占据率也没有精确等于平衡值。准确条件是整个分布偏差的慢模态系数为零,而不是某一个状态的概率碰巧相等。快速跃迁还会同时改变其他状态的占据。
这组模型的慢、快衰减率约为 $1.889\times10^{-4}$ 和 $0.839$,相差约4443倍。但这不是“任何精度下都快4443倍”的结论。实际达标时间还取决于起始幅度和阈值:
| 要求TV小于 | 较温初态所需时间 | 特殊较热初态所需时间 |
|---|---|---|
| $10^{-2}$ | 0.448 | 1.242 |
| $10^{-3}$ | 8058.8 | 3.986 |
| $10^{-6}$ | 44635.7 | 12.219 |
最宽松的标准下,较温初态先达标;要达到严格精度时,长尾才成为主要成本,特殊较热初态的优势非常大。因此,初始距离、曲线交叉和指定精度的达标时间,是三个有关联却不能互换的判断。
计算用谱展开得到完整分布,并以矩阵指数独立核对,最大差约 $4.4\times10^{-14}$;概率归一化、非负、详细平衡和两种距离的单调衰减都通过检查。这不是抽几条随机轨迹后猜出的尾部,也不证明所有三态模型都有同样效应。
稍微没有制备准,慢尾会回来
强效应的理想条件是一个系数严格为零。实验只能把它压到测量分辨率以内。胶体论文中接近零的慢尾,是通过有限采样曲线和模型拟合判断的,不能解释成直接测到了数学上的精确零。2 3
本篇把特殊初温提高0.1%,其慢模态系数便从数值零恢复为约 $5.24\times10^{-5}$。要求TV小于 $10^{-3}$ 时,达标时间仍约3.99,与理想情况很接近;要求小于 $10^{-6}$ 时,却要等约17281个时间单位,远长于理想的12.22,但仍短于较温初态的44636。
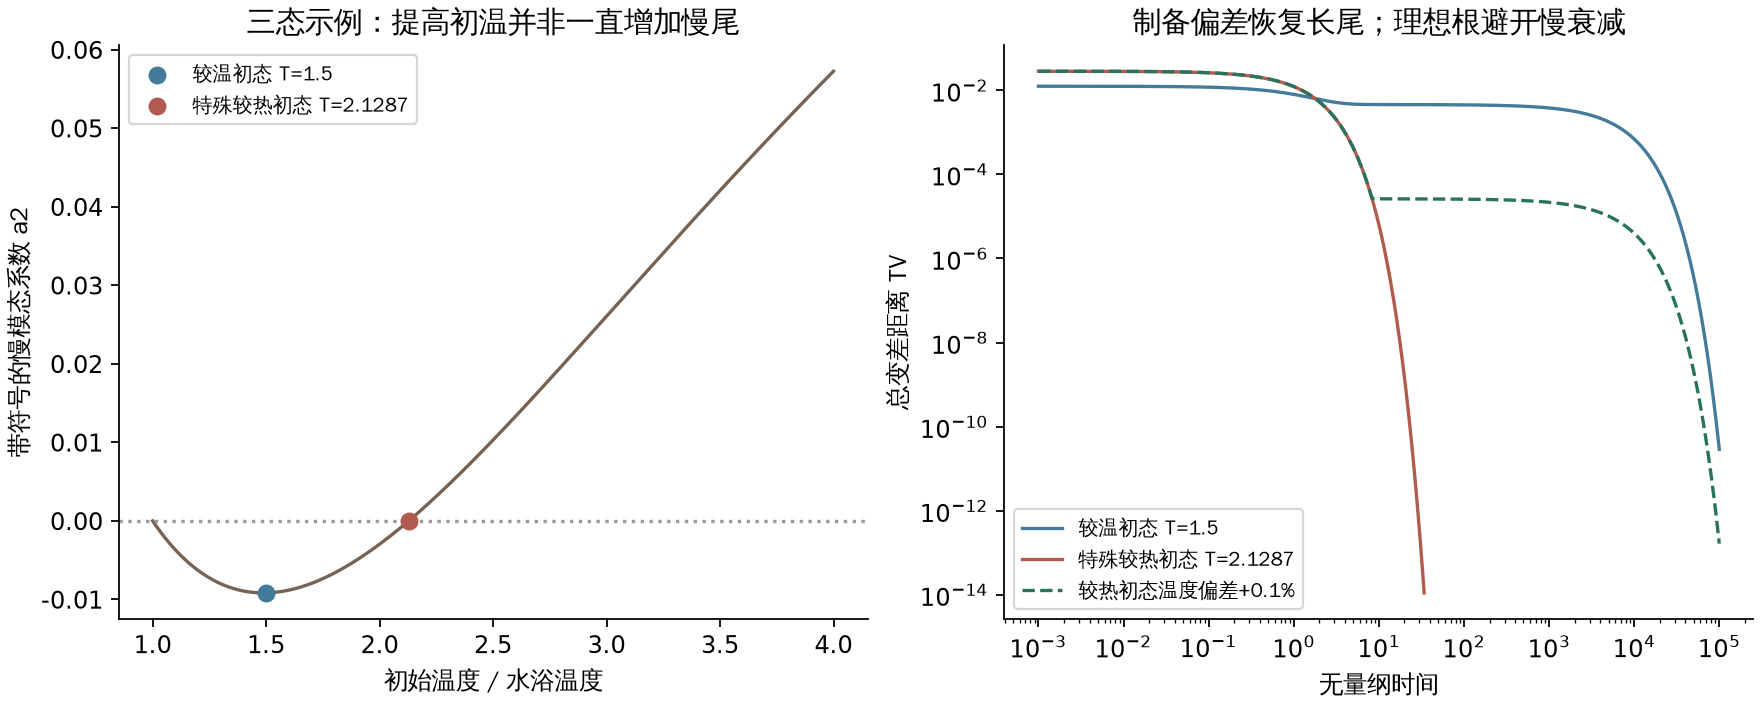
这不是说强效应只能存在于一个稍扰动就消失的模型。2019年的理论研究区分了两个问题:是否还存在某个消除慢模态的初温,以及实验是否恰好制备到那个初温。模型参数略变时,零点可能移动而仍然存在;但继续使用旧制备值,就会留下残余慢分量。4
若把理想“较热”初态当成一项加速策略,还需要计算制备与切换所花的时间和资源。上表只计算释放之后的松弛时间,不能直接作为整套实验或设备总周期的收益。
换一把距离尺子,交叉时刻也会变
TV衡量总概率差,KL散度则对相对平衡概率的偏离采取不同加权。一个在目标分布中很罕见的状态,出现少量额外概率,也可能显著影响KL。两把尺子看到同一条演化路径,不一定给出同一交叉时刻。
本篇三态例子的TV曲线约在 $t=1.785$ 交叉,KL曲线约在 $t=5.203$ 交叉。两种指标都显示较热初态后来更近,但“从什么时候开始更近”不同。本篇计算
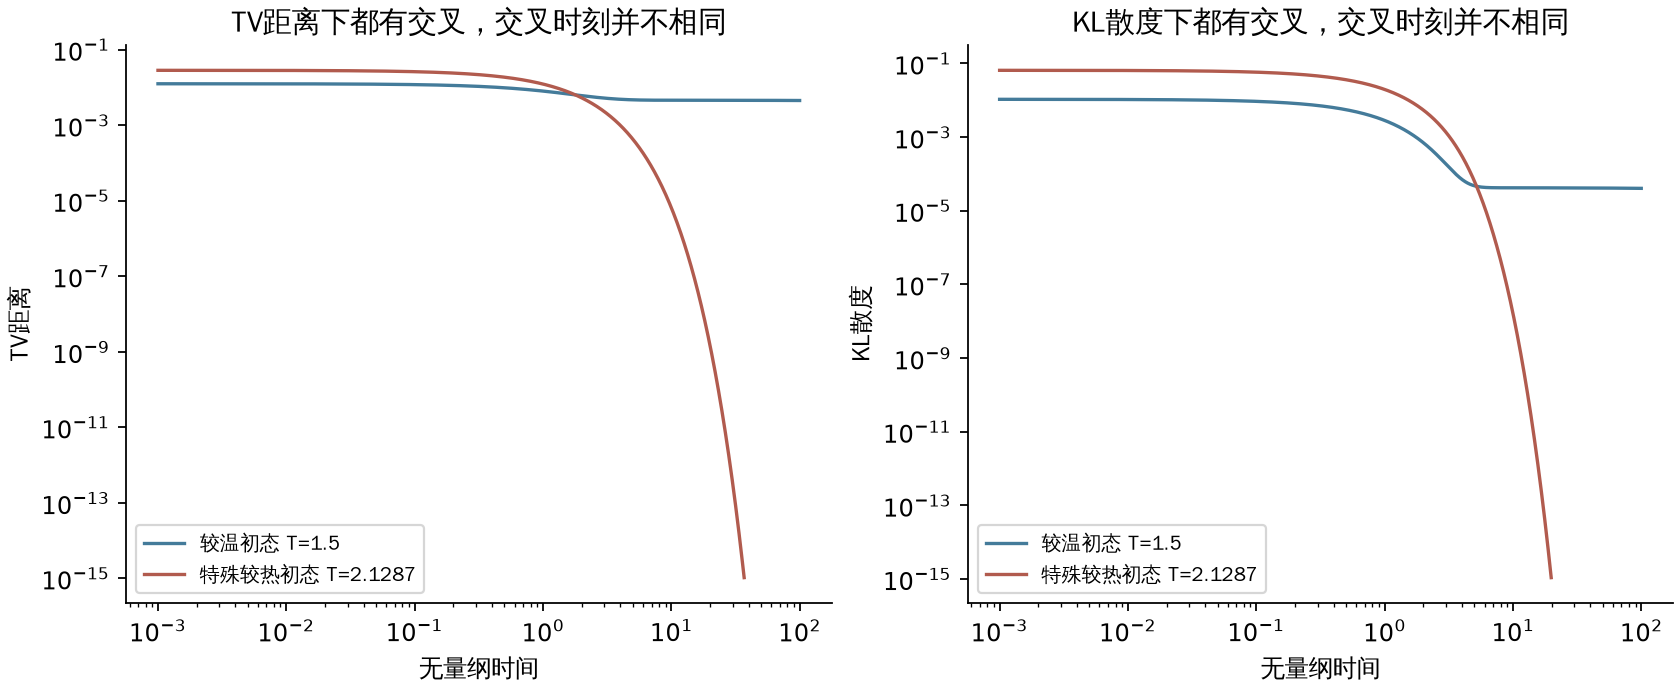
对于本篇满足详细平衡的模型,KL还等于相对于平衡的非平衡自由能差除以 $k_BT_b$。两组初态都在降低自身的这项自由能差;它们之间的排序反转,不意味着其中一组违反了耗散方向。1
如果希望结论不依赖于任选一把尺子,可以提出更强的问题。2025年的热主序研究比较概率分布相对于同一个Gibbs参考分布的整体排序。具体做法是按$p_i/\pi_i$排序,再比较累积概率构成的相对Lorenz曲线。满足这个排序关系时,对所有连续凸函数$f$都有对应的
大小关系,TV和KL都包含在其中。5
我们也检查了本篇例子:初始较热分布在这个意义下更远;到$t=20$时,比较两条分段直线的全部转折点,较热分布的相对Lorenz曲线已不高于较温分布。这支撑的是该时刻这对分布对所有上述凸$f$指标的一致排序,不是声称已经检验所有模型、所有时间或任意量子距离。若两条Lorenz曲线相交,通常就不能得到这样统一的排序结论。
量子实验延伸了什么,又改变了什么
2025年的单离子实验用$^{40}\mathrm{Ca}^+$的三个能级构成受驱动、可耗散的有效系统。研究者用旋转操作制备一个特定纯态,再通过密度矩阵层析追踪它与稳态的距离。这个初态起初更远,却压低了最慢衰减模态的激发,在所测参数下更快接近稳态。6
共同点是模态结构:初态决定各个衰减方向的系数。不同点是这里的状态是含相干信息的密度矩阵,目标是持续驱动和耗散共同形成的稳态,不要求是一个按温度排序的热平衡态。因此,它不能简单翻译成“更热的离子冷得更快”。作者的有效动力学、激光相位跟踪和层析基底都有具体设定,制备操作也有成本。6
这个装置还显示了一条边界。改变驱动参数后,两条慢模态可以形成具有相同实部的复共轭对;按照该实验的制备方案,仅消掉一个相关方向,另一个同速方向仍会留下。这时可能仍有幅度上的优势,却不再获得原先那种长时指数率提升。该参数边界与它的Liouvillian异常点相联系,但不能升格为“所有量子强Mpemba效应都必须由异常点产生”。6 7
更一般地,若最慢衰减率简并,想让更快的一层主导,就要处理整个相关慢子空间,不能只把某一个选定系数写成零。经典的简单模态图像有用,量子相干、简并和非对角化结构则需要各自核条件。
哪些情况下,这条路线走不通
两态热模型提供了一个清楚的对照。固定水浴后,只有一个非平衡衰减方向,偏差满足
对于都高于水浴温度的两个Gibbs初态,较热者沿同一方向离得更远。在TV下,两条曲线的比值始终等于初始比值,因此不会交叉。本篇用相应两态模型核对了这一点。可选择的不同路径与不同衰减时间尺度,是上述三态例子的重要条件;有三个状态也不自动保证效应。1
其他情况也必须重新判断:只测一个位置的温度或只测某个平均量,可能看不到完整分布的慢尾;比较时若同时改变势形、摩擦或耦合强度,速度差异就不再只来自初态;慢模态投影不随可制备初态发生合适变化,也不会出现我们计算中的强加速。宏观水结冰还牵涉流动、成核和边界等过程,本篇没有用胶体结果替它们作统一解释。
这篇得到的答案是:起点远近描述偏差的总量,松弛时间还取决于偏差中最难消除的那部分。 某些更远初态恰好较少激发慢过程,便能在严格精度下先接近目标;但是否发生、优势多大、能持续到多高精度,都必须连同动力学、制备方式、距离定义和阈值一起说明。