少经历几次,不一定少花时间
设想两组动物学习同一个关系:一个声音之后,会出现奖励。甲组很快又遇到下一次,乙组要等更久。
如果把每次经历都看成一份固定大小的学习,那么经历更密集的一组应该更快学会。但每次经历究竟改变多少,并不一定固定。间隔也可能改变背景预期、事件的可区分性、临时痕迹和后续更新的强度。
因此,“更快学会”至少有三种意思:所需经历次数更少,实际训练时间更短,以及经过较长时间后仍记得更好。这三者不能互相替代。神经系统如何使用时间,也是区分学习模型的重要问题。1
本篇集中研究奖励关联的获得阶段,以2026年Burke等的小鼠研究为主线,结合原始模型和其他任务,解释哪些结论有证据,哪些仍只是可能的机制。2
实验里,什么算一次,什么算学会
Burke等让小鼠学习短声音与稍后奖励之间的关系,用奖励到来前增加的舔舐行为判断动物是否开始期待奖励。2
这里有三个时间变量:
- 线索到结果的延迟:声音开始之后,多久出现奖励。
- 线索之间的间隔:两次声音之间相隔多久。
- 奖励之间的间隔:两次奖励之间相隔多久。
当每次声音都带来奖励时,后两者同步变化,很难只靠这一种实验分清到底是谁在起作用。如果有些声音后不发奖励,线索仍按原频率出现,奖励却变稀疏,两种间隔才被分开。
论文另用“试次间隔”给组别命名。例如“60秒组”的60秒,并不是严格的完整奖励间隔;加上线索、等待和奖励消费的固定时间,回归分析使用的平均奖励间隔为64.25秒。600秒组对应604.25秒。
“学会”也不是直接看见某条突触完成了变化。作者先计算声音引起的舔舐相对基线的增量,再用整段学习记录的累积曲线回顾定位开始增加的位置。没有持续达到行为标准的动物,被归为未表现出学习,并从“达到标准需要多少次”的比较中排除。
这些定义是理解结果的一部分。一个动物没有明显舔舐,可能没有建立足够的关联,也可能有了信息但没有跨过行为表达门槛。后面的多巴胺结果恰好提供了这类区分。
从几十秒到几百秒,次数确实大幅下降
本篇取得作者公开代码仓库中的行为获得数据,重新汇总五组共52条已达到行为判据的记录。前四组的结果如下,误差为本篇从个体数据计算的均值标准误:
| 名义试次间隔 | 平均奖励间隔 | 纳入次数分析的动物 | 达到行为判据所需次数 |
|---|---|---|---|
| 30秒 | 34.25秒 | 5 | 176.2 ± 36.3 |
| 60秒 | 64.25秒 | 17 | 93.7 ± 6.7 |
| 300秒 | 304.25秒 | 6 | 16.7 ± 4.0 |
| 600秒 | 604.25秒 | 19 | 8.8 ± 0.6 |
其中,30秒组原有6只、60秒组原有19只;分别有1只和2只未达到行为标准,没有进入上述次数均值。300秒与600秒组这里分别纳入全部6只和19只。2
从60秒组到600秒组,所需次数大约少了十倍,但每次之间也大约多等了十倍。所以,在该范围内,较少的次数没有带来相应程度的总训练时间缩短。
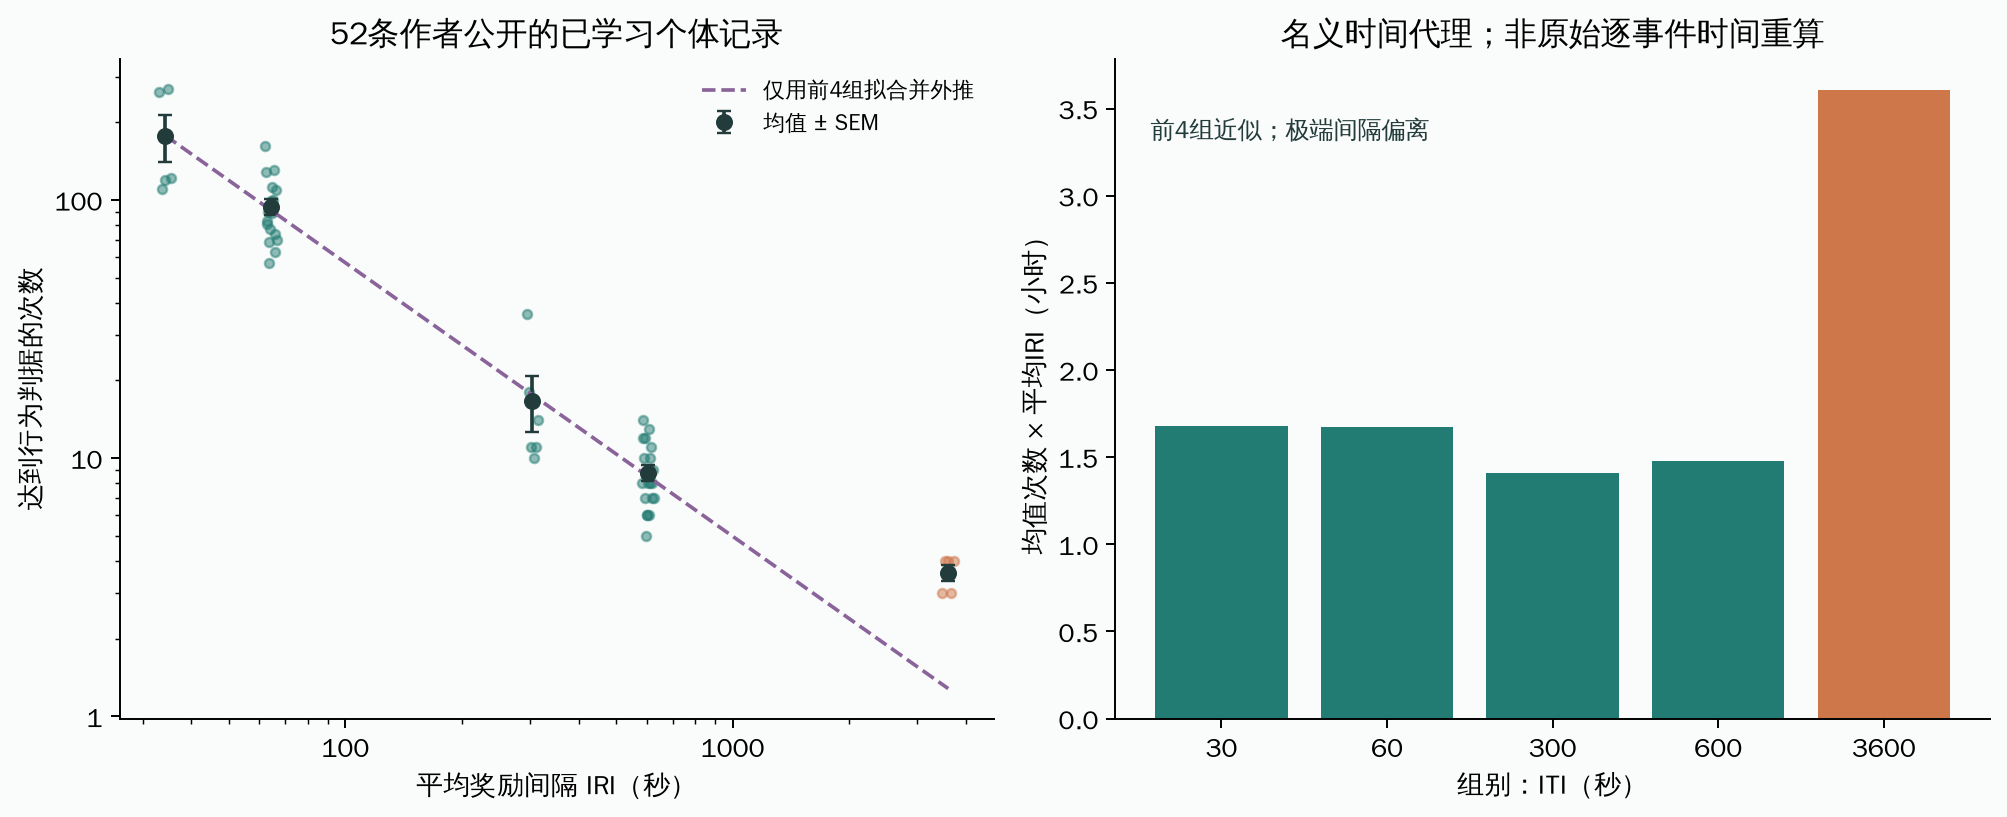
将前四组的平均次数与平均奖励间隔取对数,再做线性回归,本篇重算出斜率约−1.059,与原文一致。它接近−1,意味着在这个范围内,可以近似写成:
其中$D$是奖励间隔,$N_{\mathrm{learn}}$是达到判据所需的次数。
但这是一条由四个组均值形成的经验关系。拟合很好,不等于它是一条没有误差、没有边界的生物学定律。作者对实际总训练时间没有检出组间差异,也不能据此证明所有条件下的时间完全相等。这里的训练时间主要累计实验中的经历,不是把两次训练之间整天的生活时间也算进去。
一小时间隔,已经不再按原比例走
如果把上述关系直接延伸到一小时间隔,预测的平均获得次数约为1.28次。但原实验五只动物的公开记录是3、4、4、3、4次,平均3.6次。2
这仍然比600秒组需要的次数少,却没有按原先比例继续下降。多巴胺线索反应也很快出现,但同样不满足简单的无限比例外推。
这个结果很有价值,因为它同时告诉我们两件事:间隔对学习有强影响;这种影响在更极端的尺度上会改变。不能只保留前一段漂亮的直线,再把“越等越有效”当成结论。
文中的一小时组每天训练安排也更长,与其他组并非所有日程条件都完全相同。它可以检验原比例的外推,却没有单独定位究竟是哪项记忆、生理或表达限制使比例失效。
本篇使用了2026年8月更正后的期刊版本。该次更正修复的是图4b顶部栅格图的对齐,同一研究的更正版不作为另一份独立证据。
大脑可能不仅数次数,也在估计事件发生的时间背景
一种直觉是:如果奖励本来就到处出现,那么某个声音恰好出现在奖励前,并不提供太多新信息;若背景中很久才出现一次奖励,同样的先后关系就更值得注意。
这个直觉解释了为什么“奖励前出现过什么”需要与背景比较。但它还不能独自推出十倍间隔对应十倍学习量。
例如,在一个自选的随机背景中,假设奖励服从固定平均率的泊松过程。将平均间隔从60秒变成600秒,一段固定短窗口内出现奖励的概率大约降十倍,但用负对数概率衡量的“意外程度”只增加约1.6倍。本篇实际算了这个例子;它不是实验的真实奖励时序,只说明“更加罕见”与“学习量正比增加”之间还缺一段机制。
Jeong等提出的回溯关联模型ANCCR,把这段机制进一步具体化:结果出现时,利用尚存的线索痕迹,估计哪些线索比背景巧合更稳定地出现在结果之前;再结合线索和结果本身的出现频率,把向后看的关联转换为向前的预测。3
向后看与向前看并不是同一个问题。“每次听到声音之后有没有奖励”,与“每次得到奖励之前有没有听到声音”,在部分奖励、额外奖励和多线索条件下,会给出不同统计量。
在模型里,可以用贝叶斯关系帮助理解这个转换:
这里的$r$、$c$分别代表奖励与线索。真实时序中的事件定义、背景与统计窗口需要一致,不能把不同时段、不同背景下估计的几项直接拼起来。ANCCR实际使用的是带时间痕迹和背景校正的表示,上式只是理解它的入口。
模型名称中的“因果”也不意味着仅凭先后顺序就能在任何环境中排除共同原因。它是在规定的候选事件与时间表示中学习关联结构,现实中的因果识别仍需要相应控制和假设。
关键一步:更新频率变了,每次更新的权重也要跟着变吗
2026年论文进一步提出,向后关联只在奖励出现时更新,而背景事件率持续更新。如果两者要代表同一段近期历史,就不能任意给它们不同的遗忘速度。2
用一个简化例子讲这件事。设某个估计量在一次更新后保留旧值的比例是$1-\alpha$。经过$n$次更新,旧信息还留下的权重是:
如果两次更新相隔$D$秒,那么这些更新经过了$nD$秒。若希望旧信息按一个固定时间常数$\tau$衰减,就需要满足:
从而得到:
当$D$远小于$\tau$时,才可以近似写成$\alpha(D)\approx D/\tau$。间隔越大,每次更新越重,但精确表达式会逐渐饱和,不能一直线性增加到超过1。
这里有一个必须明确的推论桥梁:按时间匹配历史窗口,是模型的设计与机制假设;它不是贝叶斯公式单独强迫所有学习系统都采用的更新方式。 还需要假设如何保留痕迹、在哪些事件更新,以及系统怎样估计合适的时间尺度。原论文的附件也给出了资格痕迹时间与背景更新率之间的适用条件。
所谓资格痕迹,可以先理解为“某个线索最近出现过”的暂时记录。它使结果到来时仍有可能关联到较早的线索;痕迹保留多久、是否随环境改变,是需要解释的生物学环节。
上面用于历史权重的$\tau$,并不等于单个线索资格痕迹的寿命。完整模型分别定义这两种时间尺度,再说明它们在什么条件下能够配合。
一个实际计算:次数优势与时间优势为何会分开
本篇选择$\tau=3600$秒,用一个简单的误差更新式:
这里$w$是示意关联量,目标值固定为1,没有拟合真实小鼠。每次奖励才更新;没有奖励的间隔内,$w$保持不变。
实际计算得到,若用$w\geq0.8$作为示意判据,60秒间隔需要97次,600秒间隔需要10次,分别经过5820秒和6000秒。两者的次数差很大,经过时间却接近。一小时间隔需要2次,已经表现出事件离散性造成的时间差。
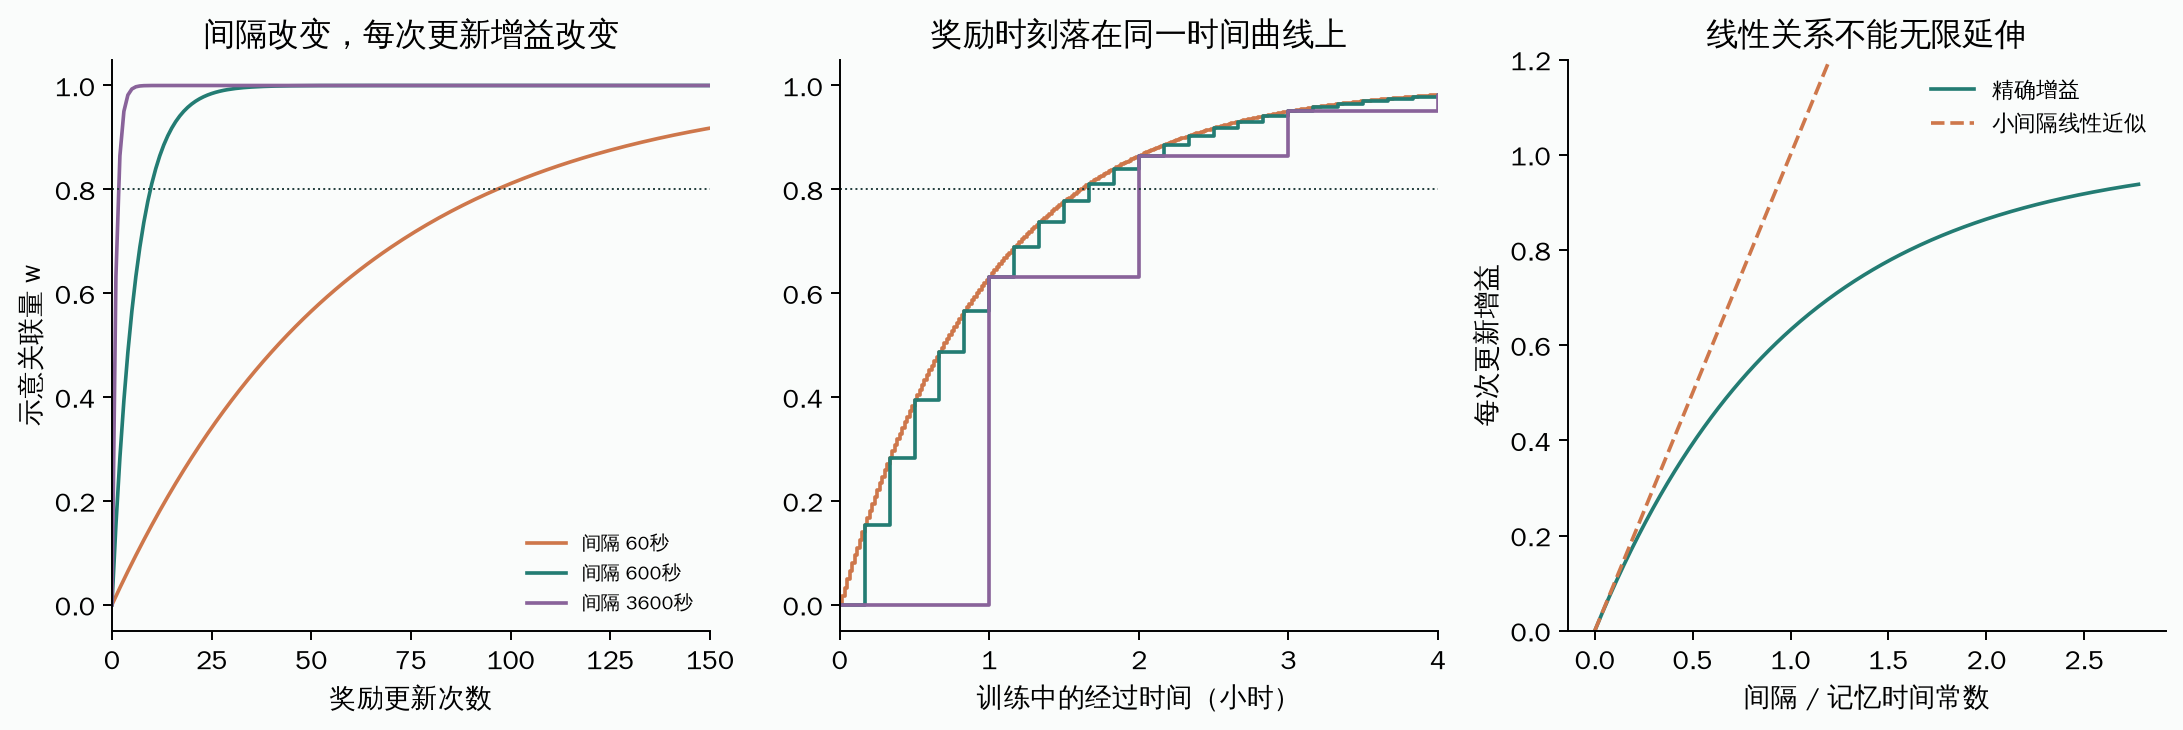
作为对照,若无论间隔多久,每次都使用固定增益0.02,那么达到同一判据都要80次。此时600秒间隔就比60秒间隔多花十倍时间。
这个例子说明,知道“发生了多少次更新”还不够,必须知道每次更新有多重。它也说明,写成误差更新形式的模型并非逻辑上不能出现间隔效应;关键在于更新率和时间表示怎样产生。
不过,这个小模型直接指定了时间常数与增益关系,没有解释大脑如何实现它,也不能复现论文全部多巴胺动态。它展示的是一种计算上的可能关系,不能冒充第二套完整的生物学理论。
减少奖励之后,究竟哪种次数减少了
在100%奖励条件下,线索次数与奖励次数一起变化。为了拆开它们,Burke等保持声音的出现频率,将其中一组的奖励概率降到50%。2
对于达到行为判据的动物,100%奖励组平均约需要94次奖励;50%奖励组约需要45次奖励,接近一半。但50%组总共经历了约87次声音,包括没有奖励的那些次,和原先的线索总数相近。
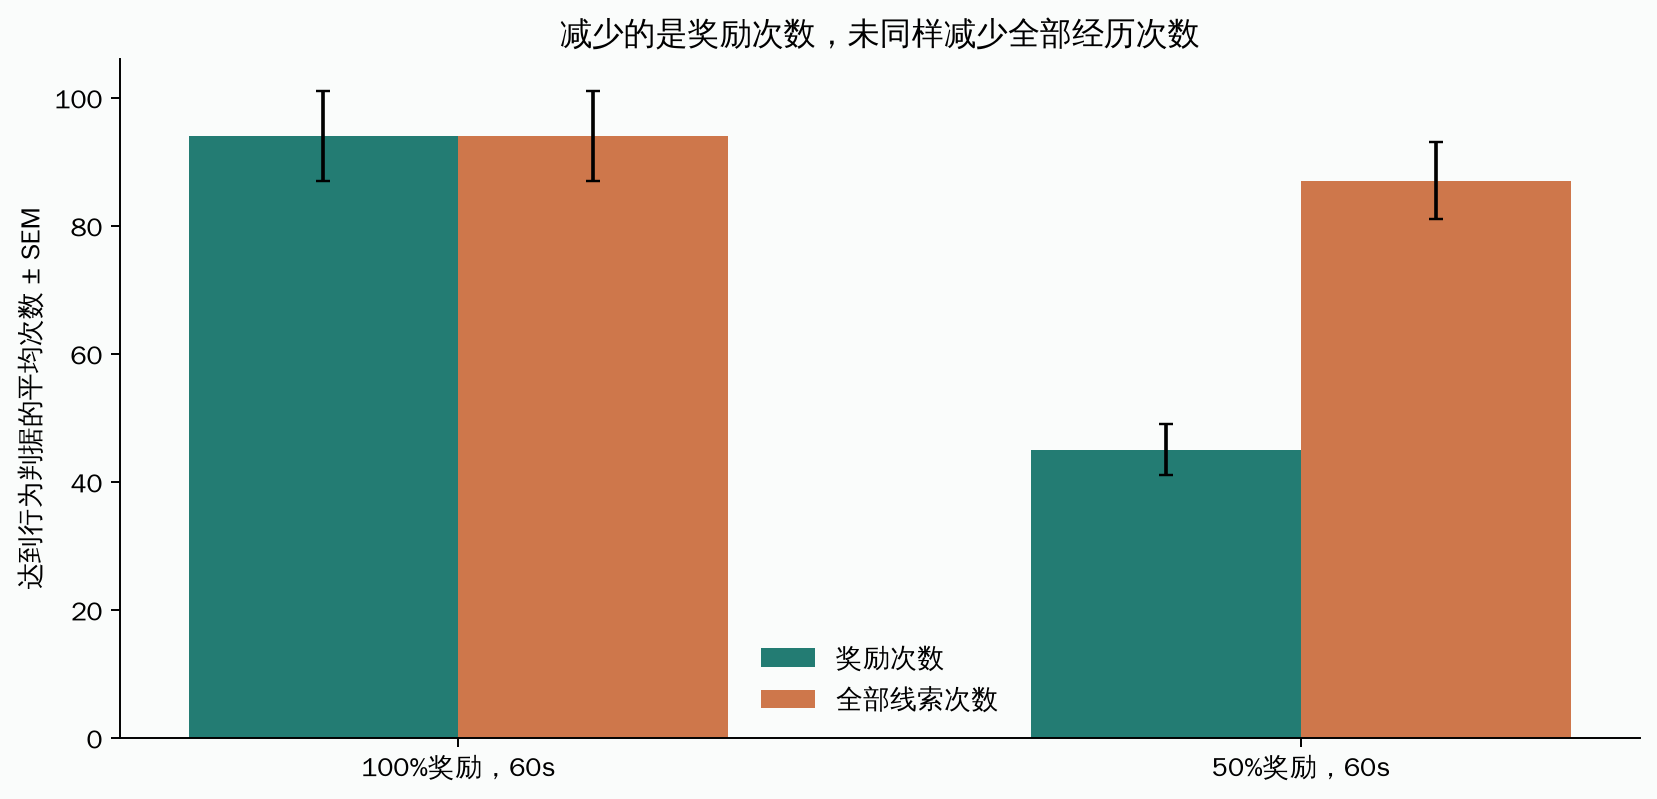
所以这项结果支持奖励间隔参与每次有奖经历的更新,不能被改写为“减少一半经历,学习仍完全一样”。没有奖励的线索仍然是经历,也可能包含信息。
行为和神经信号的结局还不完全相同。50%奖励组最终的期待性舔舐较低;其中两只没有达到行为学习标准的动物,仍出现了线索相关的多巴胺变化。把奖励概率进一步降到10%时,行为、神经反应和获得判据又有不同程度的变化。
这说明,关联信息的形成、某种神经信号的出现,以及足以驱动明显行为,是需要分别观察的层次。神经信号也不是可以直接读出全部知识的统一仪表。
本研究记录的是伏隔核核心部位的局部多巴胺释放变化,没有遍测整个大脑,也没有直接从神经信号中读出那条学习率公式。
几个控制条件,比只比较“密集”和“稀疏”更有解释力
奖励间隔变长时,每天获得的奖励数、饱足程度、环境暴露、注意与日间安排都可能跟着变化。因此,原研究做了几组有意义的拆分。2
第一组保留短间隔,但每天只给六次经历,和长间隔组匹配次数。它没有获得长间隔组同样的每次经历优势,说明单靠“每天少做几次”不足以解释结果。
第二组把六次短间隔经历集中做完,再让动物继续待在环境中,使环境暴露总时长接近长间隔组。结果仍没有等同于把等待插在经历之间。这说明等待放在哪里,也可能改变学习。
第三组在奖励线索之间加入更多无奖励的其他声音,增加听觉事件总数。目标关联仍较快获得,限制了“只是所有声音变少、每个声音更显眼”的简单解释。但它不能排除对有奖励经历进行选择性回放,因为回放未必平等对待所有声音。
第四组在两次目标奖励之间插入另一种奖励。学得多快更接近目标奖励自身的间隔,而不是所有奖励合在一起的频率;但也没有完全符合“不同奖励绝不混淆”的预测。作者观察到的平均获得次数约12,落在完全按奖励身份区分所预测的约8.5,与按总奖励频率所预测的约26.8之间。
这个中间结果提示,系统如何划分“同一种事件”也会影响有效的时间统计。味道、背景和任务经验可能影响这种划分。不过,部分泛化是对结果的机制解释,并不是这一个对照已经直接测出了完整的事件分类过程。
哪个模型目前解释得更好,结论能走多远
原论文比较了微刺激时间差分学习、SOP和ANCCR,并另测试了给时间差分模型加入间隔调整后的学习率。SOP用刺激表征的激活与恢复过程解释间隔作用;时间差分模型则沿时间状态更新对未来奖励的估计。
在所查的模型实现、参数范围和行为读出下,ANCCR对跨间隔的获得次数及部分神经动态解释更好。加入间隔调整的时间差分版本,已经能明显改善行为拟合,但没有同时解释原文要求的全部动态。2
本篇从作者保存的模拟结果中重新计算比较分数,并重绘其平均获得次数,没有再次运行整个参数扫描:
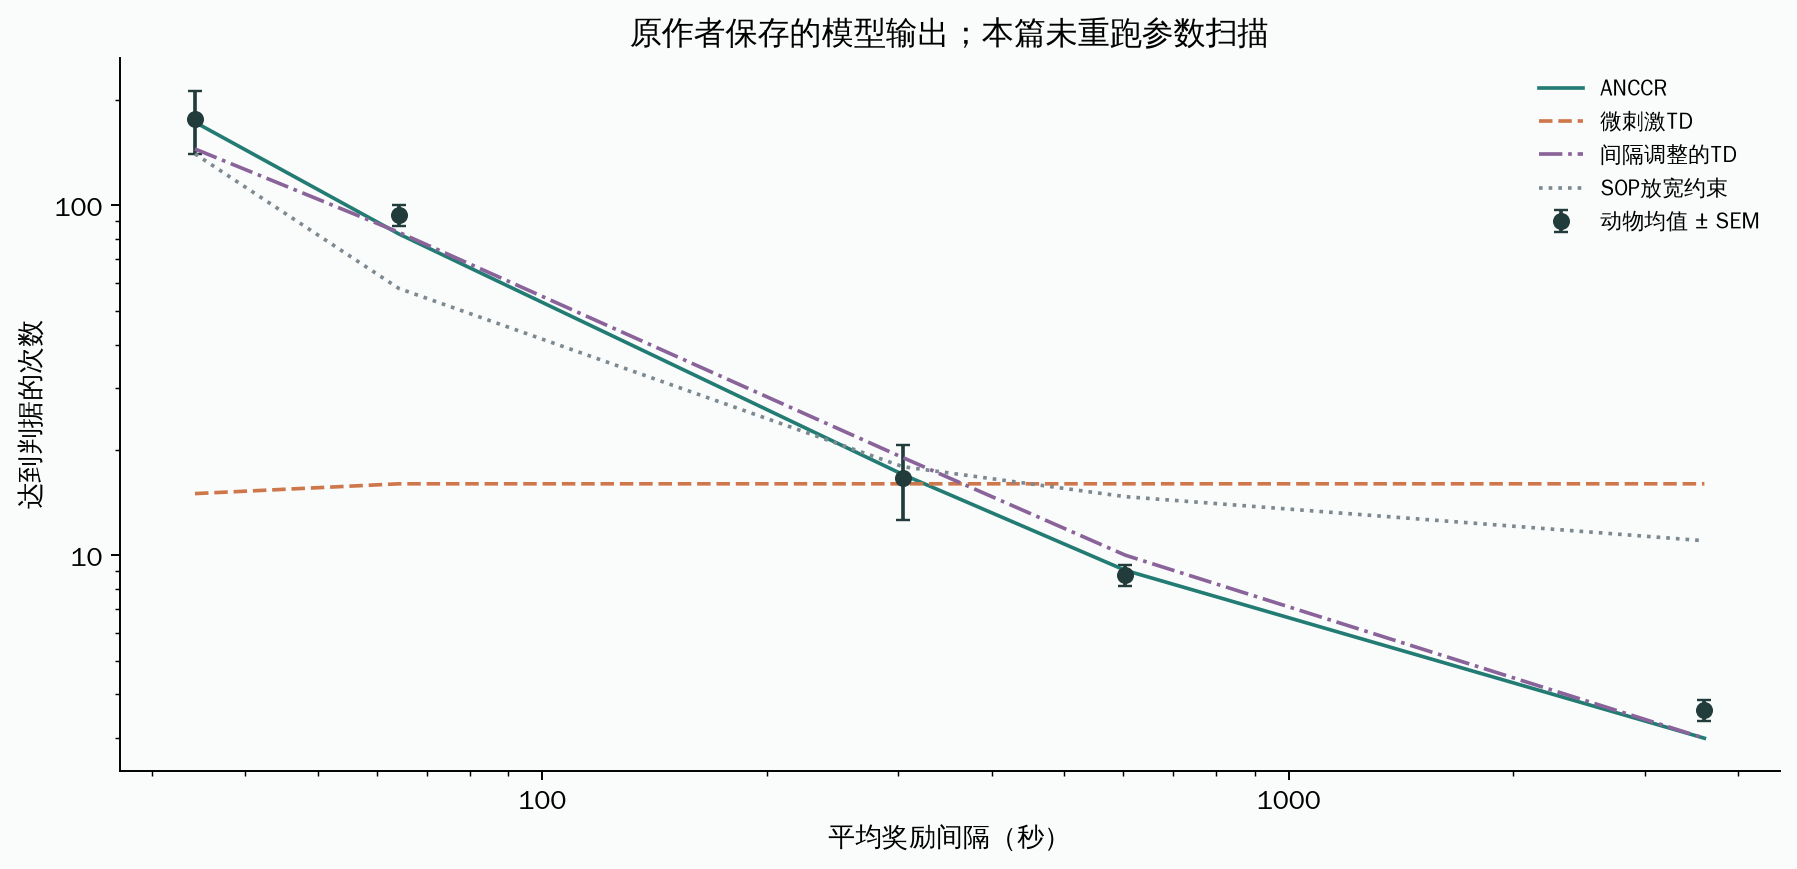
这里有两点不能省略。第一,原文主图的AIC形式比较把参数惩罚项设为零;作者另提供计入参数数目的版本。相对权重反映的是该组候选与计分方式,不能读成“某个理论为真的概率”。本篇把SOP受约束与放宽约束的输出分别保存,避免混用其不同分数。
第二,模型把内部关联量超过某个阈值当作行为起点;真实动物数据则用累积行为曲线回顾定位。二者之间仍有一个行为读出的假设。模型选择结果不能完全脱离这条桥梁。
2025年Hamou等提出了另一条值得比较的路线:学习线索到结果的整个时间间隔分布,并同时估计哪个事件具有预测意义。它采用跨多个尺度的时间表示,在部分条件下可以产生接近的次数—间隔关系;相应的在线更新又可以写成类似预测误差的形式。4
这说明,时间结构、回溯信息与误差更新之间,并非只有互相排斥的一种组合。但Hamou等也明确承认,其模型对二阶条件作用、复杂多线索归因等尚不完整;它主要对应的预训练和延迟条件,与Burke等的短线索痕迹任务也不同。本文没有在同一套原始数据上给它重新调参与评分,不能宣布它已经解释了2026年的全部结果。
较稳妥的判断是:2026年的结果对某些常用模型实现提出了强约束,为事件间隔与回溯更新提供了具体证据;它尚未证明所有预测误差算法都失败,或全脑所有学习都只用ANCCR。13
主实验还保持了声音到奖励的延迟,没有系统扫描这个变量。因此,它也不能证明线索到结果的时间距离不重要。把这段延迟、奖励频率和既往奖励经历分别改变,会是继续区分机制的重要方向。
获得一个简单关联,与以后还记得,不是同一道题
人的间隔学习也不能从这组小鼠获得实验直接推出统一日程。一个重要区别是,人在意的常常是几天或几个月之后还能否回忆,而非训练中第一次出现某个期待动作。
Cepeda等的事实记忆实验,把首次学习与复习之间的间隔,以及复习之后到最终测试的延迟分别改变。第二次学习固定复习轮数,最终的回忆和识别成绩随间隔先改善、再下降;较晚测试时,较有利的复习间隔也会变化。5
因此,在这种保持任务里,“等得更久”不是一直有利。这个实验与小鼠奖励关联的任务、尺度、目标和读出不同,不能把一种比例关系平移过去。首次按标准学会、固定次数复习和长期测试,也与“固定训练时间内能获得多少关联”使用不同的比较条件。
对于本库,值得保留的机制线索是:学习系统要同时处理发生了什么、多久发生一次,以及这些信息怎样转成行为。 增加经历次数有时会增加信息,有时也伴随着每次更新权重的改变;间隔带来的收益,则依赖事件定义、历史窗口、遗忘和任务目标。