先给一句短答案:两种情况都真实存在——有的肿瘤里,谁更可能扛过治疗在给药之前就有偏好,而且这份偏好能传给后代(但仍是概率倾向,不是每个细胞的命运已定,也不等于遗传固定:本篇主案例里这份偏好本身是可逆的);有的肿瘤里,活下来的细胞是被药改了状态,撤药几天就改回去。分辨它们靠的不是杀伤曲线:本文会证明"药物诱导状态转换"与"既有亚群被选择"生成的是同一族函数,曲线拟合得再好也分不开。能分辨的是两件事——把同一批细胞分成互不相干的几份分别治疗,看赢家是不是同一批;以及停药之后再治一次,看敏感性回来多少。
一、耐受、持续存活、休眠、耐药:四个判据
这四个词在肿瘤文献里经常混用,但它们各有各的操作定义,来自细菌学,本篇沿用同一套(s1、s2):
| 说法 | 判据 | 用什么量 | 撤药之后 |
|---|---|---|---|
| 耐药 resistance | 能在更高浓度下继续生长 | 最低抑菌/抑制浓度 MIC 上移 | 典型情形不回复 |
| 耐受 tolerance | 浓度再高也只是拖慢死亡,整群都这样 | 杀死一定比例所需的时间 MDK;时间-杀伤曲线呈单相 | 典型情形回复 |
| 持续存活 persistence | 大部分细胞很快死,少数慢得多 | 时间-杀伤曲线呈双相 | 通常回复 |
| 休眠 dormancy | 细胞不再增殖 | 增殖标志、分裂计数 | 可再进入周期 |
关键在于耐受和持续存活都用时间度量(MDK),耐药用浓度度量(MIC);最右一列只是这三类在细菌学里的典型表现,不是它们的定义——遗传改变照样能影响耐受倾向,非遗传状态也可以长期稳定,所以“撤药回不回复”本身要单独测,不能拿标签代替。用在肿瘤上还要多说一句:药敏终点得写清是净增殖、存活还是死亡,三者的曲线形状不同。而"整群"与"少数"的区别正是本篇要问的那个区别的表型版本。休眠是另一根轴:不增殖的细胞往往难杀,但难杀的细胞不一定不增殖——下面 PC9 的数据里,扛住十四天的谱系分成完全不分裂和仍在分裂两批,而且是两批不同的谱系。休眠本身的长期命运留给 T97。
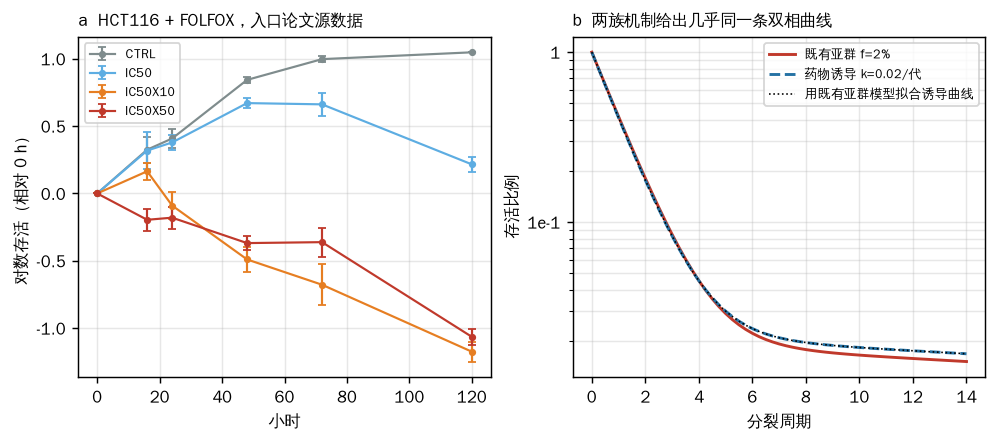
需要立刻说清楚的是,这些标签描述的是曲线形状,不是机制。第五节会证明,同一条双相曲线既可以来自"治疗前就有 2% 的细胞是耐受的",也可以来自"所有细胞在药里以每代 2% 的速率转成耐受"——两者不是"难以区分",是同一族函数。
二、主案例:PC9 加奥希替尼,谁更可能活下来在给药前就有偏好
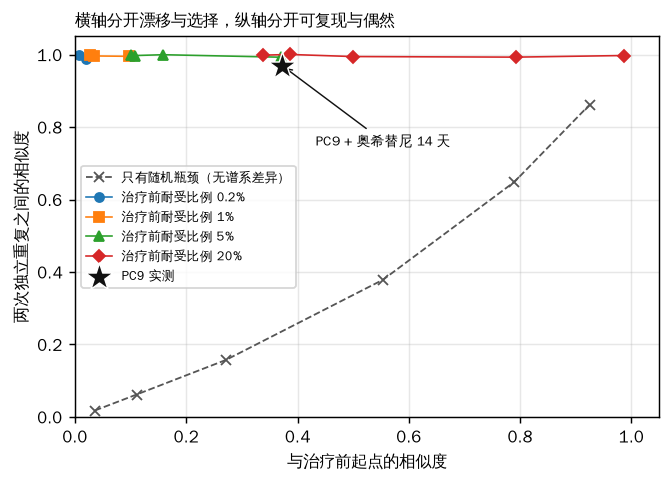
用 Watermelon 谱系条码数据集(s3,GSE150949):EGFR 突变肺腺癌 PC9 细胞先转入高复杂度表达型条码库,再用 300 nM 奥希替尼连续处理 14 天,在第 0、3、7、14 天做单细胞转录组;第 14 天按 mCherry 稀释程度分选成循环(低)、中等、不循环(高)三档。关键设计是有两次完全独立的重复实验,种子来自同一个已转导的细胞池(原文:"two independent replicate experiments using the same starting Watermelon-transduced PC9 cell population")。这就把 Luria–Delbrück 的逻辑搬到了现代:两次实验里的加药事件互不相干,凡是两边共同出现的偏好,就只能来自加药之前就存在、并且传给了后代的差异——除非两边共享某种系统性的观测偏差,第十节讨论一个本篇排除不掉的候选。要先声明这条逻辑能给到哪一层:它能证明“治疗前就有、可遗传给后代的倾向差异”,不能证明“每个细胞的结局在给药前已经定死”。同一条谱系里的细胞仍可以有随机结局;一条谱系也可以因为带着较稳定的响应程序,在药里更容易转成耐受态——这种“可遗传的诱导倾向”同时包含治疗前差异与治疗中的转换,不落在“既有亚群 vs 药物诱导”的二选一里。原文自己的措辞也是克隆水平可重复的增殖潜力,比“谁活下来给药前就定了”弱。
原始数据 56419 个细胞,其中 35792 个带可读条码。第 14 天的三个分选门是分别测序的,各门捕获到的带条码细胞数为重复1 循环 753/中等 2003/不循环 4107,重复2 为 1240/2385/4213;下面凡是“第 14 天”的合并样本,都是把这三门捕获到的细胞直接相加,这一点在第二节末尾单独检验。本篇不用原文的相关系数,而用 Morisita–Horn 相似度:它的分子对两份独立样本的组成内积无偏,分母用无偏 Simpson 指数,因此不同测序深度之间可比。
先做估计量自检——把同一份样本随机对半分,两半之间应当给 1:
| 样本 | 带条码细胞数 | 检出谱系数 | 自身对半分的相似度 |
|---|---|---|---|
| 第 0 天 | 5087 | 2993 | 0.997 ± 0.026 |
| 第 3 天 重复1 | 5616 | 3219 | 1.005 ± 0.022 |
| 第 7 天 重复1 | 2594 | 1862 | 0.993 ± 0.057 |
| 第 14 天 重复1 | 6863 | 3280 | 0.998 ± 0.013 |
| 第 14 天 重复2 | 7838 | 3510 | 0.998 ± 0.010 |
在这些深度和多样性下估计量没有系统偏差。于是可以读正题:
| 比较 | 第 3 天 | 第 7 天 | 第 14 天 |
|---|---|---|---|
| 与治疗前起点 | 0.925 / 0.917 | 0.692 / 0.733 | 0.397 / 0.349(合并规则相关,见下) |
| 两次独立重复之间 | 0.979 | 0.985 | 0.969 |
组成一路离开起点,到第 14 天只剩三分之一像;而两次互不相干的实验始终彼此几乎一样。等深度稀释(从实测细胞里不放回抽到 5087 个)后两列都不动:与起点 0.397 / 0.348,重复之间 0.968。
但“离起点 0.37”这个数不能当成存活群体的真实组成偏移。 第 14 天是先按 mCherry 分成三门、各门分别单细胞测序的,各门测到多少细胞由测序分配、捕获率与质控保留率共同决定,不等于存活群体里三档的实际比例——而这三档离起点的距离差得很远:
| 与治疗前起点的相似度 | 循环档 | 中等档 | 不循环档 | 三门合并 |
|---|---|---|---|---|
| 重复1 | 0.027 | 0.155 | 0.507 | 0.397 |
| 重复2 | 0.035 | 0.198 | 0.497 | 0.349 |
换一条合并规则(各门等细胞数,都降到 753 个)结果就变成 0.155 / 0.179。也就是说已检查的分门和合并方式给出的这一列在0.03到0.51之间变化;这不是任意混合权重的严格上下界,本篇拿不到实际分选比例,无法定标。
可复现度在已检查的合并方式下较稳。 分门单看,重复之间是循环档 0.985、中等档 0.959、不循环档 0.966;等细胞数合并后是 0.993。三种读法都在 0.96 以上。所以下面关于“两次独立重复彼此多像”的主要观察仍然成立,但不保证任意真实权重下都有同样数值,凡是靠“离起点多远”的定量结论都要带上这条合并规则的条件——第七节的耐受比例估计就是其中之一。
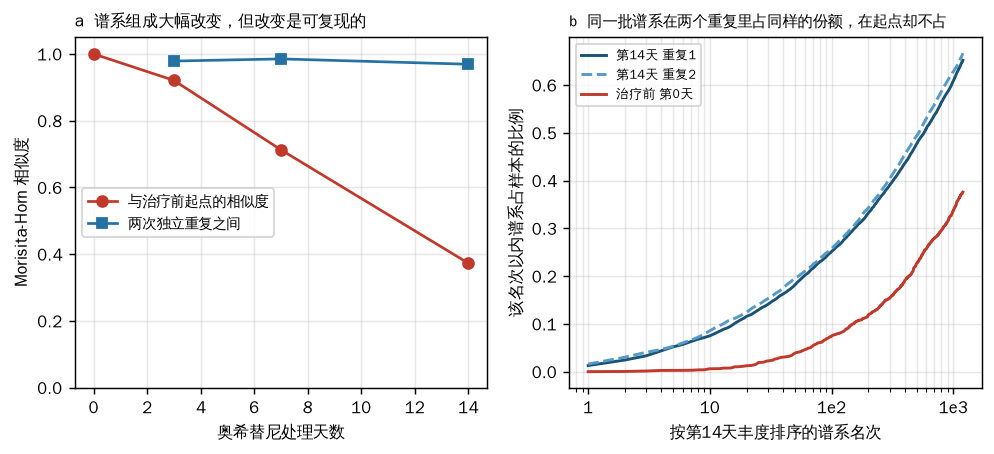
只靠随机瓶颈能不能做到这样? 不能,而且差得很远。把"每个细胞以同样的概率存活、活下来的奠基细胞再扩增"作为零模型,用第 0 天的经验分布反复模拟,扫描瓶颈宽度:要让处理后组成偏离起点到 0.373 这个程度,奠基细胞数得压到六百上下,而那时两个重复之间的相似度只有 0.238。实测是 0.969。漂移能解释"离起点远",解释不了"两次都远到同一个地方"。在已检查的两种合并规则下,零模型与实测仍相距很远:若按等细胞数合并读成 0.155,零模型给出的重复间相似度会降到 0.088,与实测的 0.99 差得更远。
其他判据给同一结论:
- 用 Hata 2016 判定既有耐药克隆时的判据(s4,"多个重复里被共同富集的条码"):第 14 天丰度前 50 的谱系有 38 条(76%)在两个重复里都进前 50,随机期望 0.47 条(超几何 p = 2×10⁻⁷⁵);前 100 是 70%,前 500 仍有 54%。
- 前 100 条谱系占第 14 天细胞的 25.1%(重复1)与 25.8%(重复2),两边几乎相同;同一批谱系在治疗前的样本里只占 7.5%。
- 第 14 天有 5327 条谱系被测到,其中 542 条就占了一半细胞。
原文自己也做过这件事,报告的是两个重复之间克隆大小 r² = 0.81(p = 9×10⁻⁵)。本篇的增量在于加了与治疗前起点的比较和漂移零模型:光有"两个重复相关"还不够,因为大克隆本来就大;把三份样本放在一起才能说清楚,可复现的那部分不是起点的样子。
三、能扛药和还能分裂,是两批不重叠的谱系
第 14 天按 mCherry 分成三档之后,同一档在两个重复之间高度相似,不同档之间几乎不重叠:
| 比较 | Morisita–Horn |
|---|---|
| 重复1 不循环档 ~ 重复2 不循环档 | 0.966 |
| 重复1 循环档 ~ 重复2 循环档 | 0.985 |
| 重复1 不循环档 ~ 重复1 循环档 | 0.015 |
在两个重复里都有至少 5 个细胞的 157 条谱系上,"落进循环档的比例"在两个重复之间的 Spearman 相关是 0.641,不循环档是 0.897;而按各档总比例做二项抽样的零模型给 0.005 ± 0.083。也就是说,一条谱系落在哪一档,在加药之前就有可重复的倾向。要注意这仍是倾向:Spearman 0.641/0.897 说明两个重复里同一条谱系的落档比例相关,不说明同一条谱系里每个细胞的结局相同。原文还给了一个方向相反、必须一起摆出来的结果——把两档细胞各自放回无药培养后,两者的倍增时间相近,作者据此认为这个表型差别不是治疗前的增殖速率异质性造成的(s3,Fig. 1h)。两件事可以同时成立:治疗前存在可遗传的响应倾向,而这份倾向不等于“天生长得慢”。原文的说法是"只有 8% 的谱系产生了持续存活细胞"、"不到 0.5% 的起始细胞形成了六个细胞以上的集落"、"第 14 天持续存活细胞里的条码只有不到 12% 属于五倍以上的克隆扩张",三个数字与这里的组成分析一致:能扛的少,能扛且能长的更少,而这两件事由不同的谱系承担。
四、同一个问题,结直肠癌化疗给出相反的答案
如果就此以为"持续存活总是既有亚群被选择",那就错了。入口论文之一(s5)在结直肠癌上做的是同一件事的反面:
- FOLFIRI 处理各种患者来源类器官,不论基线高低都诱导出 TROP2 表达,连"基线时每个细胞都表达 TROP2"的肿瘤,表面量也显著升高;同样的处理在小鼠和人的正常肠类器官、以及体内正常结肠上不诱导。
- 这个诱导在撤药 96 小时后回复。
- 为了直接分开"诱导"与"富集",作者做了 Tacstd2CreER–tdTomato 谱系追踪的小鼠类器官,脾内注射后追踪肝转移里的克隆扩张:各治疗组之间看不出克隆构成差异。
- 反过来,用 TROP2 抗体偶联药物处理,48 小时内细胞状态组成就变了(LGR5 程序上升、TROP2 高与胎儿样程序下降),药效退去后又变回来。
另一篇入口论文(s2)在结直肠癌类器官、结直肠癌细胞系以及乳腺癌与卵巢癌的原代培养上给出的是时间维度的版本:早期(16–120 小时)多数模型的时间-杀伤曲线是单相的,整群一起变慢,这是耐受;随时间推移转成双相,这是持续存活;而停药五到七周后,敏感性完全恢复。同一篇里 NCI-H23 肺腺癌细胞系连最低剂量都被彻底清除,既没有耐受也没有持续存活——说明这不是所有肿瘤细胞的通用反应。
所以两种答案都对,只是对不同的体系。这给出本篇的第一个实用结论:"耐受是选出来的还是转出来的"不是一个可以一次性回答的问题,只能在给定癌种、给定药物、给定时间窗口下测。
五、杀伤曲线读不出机制:一个恒等式,不是一次拟合失败
上面两节靠的都是谱系追踪。那不做谱系追踪,只看杀伤曲线行不行?不行,而且理由比"拟合不出来"更硬。
设敏感态与耐受态的细胞数为 $(n_S,n_T)$,加药后
先看单向诱导($k_{\rm off}=0$,治疗前全部敏感)。 解出来是
这与"治疗前就有比例 $f=k_{\rm on}/(r_T-r_S+k_{\rm on})$ 的细胞是耐受的、敏感态以 $r_S-k_{\rm on}$ 衰减"的曲线逐点相同。取 $k_{\rm on}=0.02$、$r_S=-0.9$、$r_T=-0.02$ 时 $f=0.0222$,两条曲线的最大相对偏差是 2.2×10⁻¹⁶——机器精度。反过来用另一族拟合,残差平方和也是 0。这不是"噪声太大分不开",是两族模型张成同一族函数。
更一般地:常系数、只看总量、且两个本征值不相同时,两状态线性模型的解都是两个指数之和,曲线上只有三个可估计的数(两个本征值加一个混合系数),而机制有五个未知量——四个速率 $k_{\rm on},k_{\rm off},r_S,r_T$ 加治疗前的耐受比例 $f_0$。五对三,注定有两维机制读不出来。(两个本征值相等这种退化情形例外,那时解里会出现 $t\,e^{\lambda t}$ 项,形状与普通双指数不同;这属于退化参数情形,不能因为它不常见就预先排除,但"任何两状态模型必为普通双指数"这句话本身要排除它。另外,五对三说的是整体缺乏唯一性,不等于每个参数都毫无约束——下一段就有一个被曲线卡住的例子。)
把这件事量化:固定一条由"$f_0=2\%$ 既有亚群"生成的曲线,再固定 $f_0$ 与 $k_{\rm off}$ 的一组取值去反解其余参数,十组里有七组把同一条曲线拟合到残差 < 10⁻⁶,覆盖 $f_0$ 从 0(纯诱导)到 2%、$k_{\rm off}$ 取 0 或 0.05。这七组机制对同一件临床上真正关心的事给出完全不同的预测:停药 20 代之后再治一次的存活比例从 0.179 到 0.755,差四倍多。而且这个差别几乎全部由 $k_{\rm off}$(耐受态在无药时回不回得去)决定,与治疗前耐受比例 $f_0$ 基本无关——偏偏 $k_{\rm off}$ 正是杀伤曲线完全读不出的那一维。
曲线也不是什么都限制不住:$f_0=5\%$ 这一组在本次扫描的速率范围与非负转换约束下没找到相容解(最好的残差 1.39)。这说明曲线确实对 $f_0$ 有约束,但"约 2% 是上界"是这次扫描的结果而不是已证明的界——要作为上界用,得在写明的速率排序与非负性假设下推一遍。
六、复现入口论文的"耐受→持续存活"判定,并看它有多稳
入口论文(s2)用一个 z 检验判定某条曲线是否偏离单指数:早期几个时间点做半对数线性拟合,按各点实测的均值与标准差重抽 1000 次,把零模型外推到最后一个时间点,再算 z 与单侧 p。用它公开的 source data(11 个模型、FOLFOX/FOLFIRI、IC50 至 IC50×100、每点 3–4 个重复、0–120 小时六个时间点)重跑,共 54 个"模型×药物×剂量"组合:
- 早期窗口取前 3 个时间点(0、16、24 小时)时,11 个组合被判为偏离单指数(p < 0.05);
- 改成前 4 个(加上 48 小时)时降到 5 个;
- 两种窗口下的判定在 54 个组合里有 48 个一致,6 个翻转。
所以"何时从耐受转成持续存活"这个时点,对"算哪些点是早期"敏感;论文自己也报告这个时点在不同类器官之间差别很大(例如 PDO17 在 48 小时转、有的到 120 小时也没转完),本篇的复算说明其中一部分差别来自判据本身的自由度。
耐受的另一个判据是杀伤速率对浓度不敏感。把杀伤速率定义为"对照斜率减本剂量斜率",看它随浓度的幂次 $\alpha$(按比例杀伤给 $\alpha\approx1$):在 11 个能算的模型×药物组合上,$\alpha$ 的中位数是 0.44,范围 0.15–0.83,而剂量本身放大了 20–100 倍。这支持"浓度依赖很弱"的定性说法,但它不是零——把它读成"再加多少药都一样"会过头。
七、条码实验能读出什么:记忆时间与耐受比例的简并
第二节的两个数(与起点 0.373、重复之间 0.969)能不能反推出机制参数?部分能,而且要带着上一节那条警告读:0.373 依赖三个分选门的合并规则,下面凡是用到它的都是条件结论。在 T93 留下的克隆动力学骨架上加一层可逆状态(这正是那篇交接里给 T94 留的接口),用"记忆时间 $\tau=1/k_{\rm off}$"和"治疗前耐受比例 $f$"两个参数扫格点,每格模拟共同条码池、两次独立取种、加药、按深度测序,算同样两个统计量:
- $\tau\le3$ 代:所有谱系都收敛到同一个平衡组成,与起点的相似度接近 1($\tau=3$、$f=20\%$ 给 0.987),或者群体直接灭绝。实测的 0.373 排除了这一档。
- 与实测同时相容(与起点相差 < 0.12 且重复之间 > 0.90)的有三组:$(\tau=10,\ f=5\%)$、$(\tau=100,\ f=20\%)$、$(\tau=\text{不可逆},\ f=20\%)$。
- 把输入换成等门重加权的 0.155,相容集变成 $(\tau=10,\ f=1\%)$、$(\tau=30,\ f=5\%)$、$(\tau=100,\ f=5\%)$、$(\tau=\text{不可逆},\ f=5\%)$。耐受比例的估计随合并规则整体挪了一档,而"记忆十代到不可逆都相容"这条简并两种读法下都在。
也就是说,在本模型和捕获假设下,这些读数支持治疗前存在能跨一定时间保留的异质性,但分不开"记忆十代的可逆状态"与"不可逆的遗传差异",也分不开一档与另一档的耐受比例。这和 T93 里"同一亚克隆占比对应一整条选择优势—出现时间曲线"是同一类简并,只是搬到了状态维度。
但这只是"这份条码数据分不开",不是"这个体系没有答案"。 同一篇原文已经把答案给出来了:把第 14 天分选出的循环与不循环持续存活细胞分别放回无药培养20次传代,两者都很快重新获得药物敏感性,作者据此判定底下是可逆机制而不是遗传突变(s3,Fig. 1g)。所以在 PC9+奥希替尼这个体系里,"不可逆"那一支被原研究自己的实验压下去了;本篇能加的是为什么条码数据本身给不出这个判定,以及要用条码把它测出来需要什么设计。
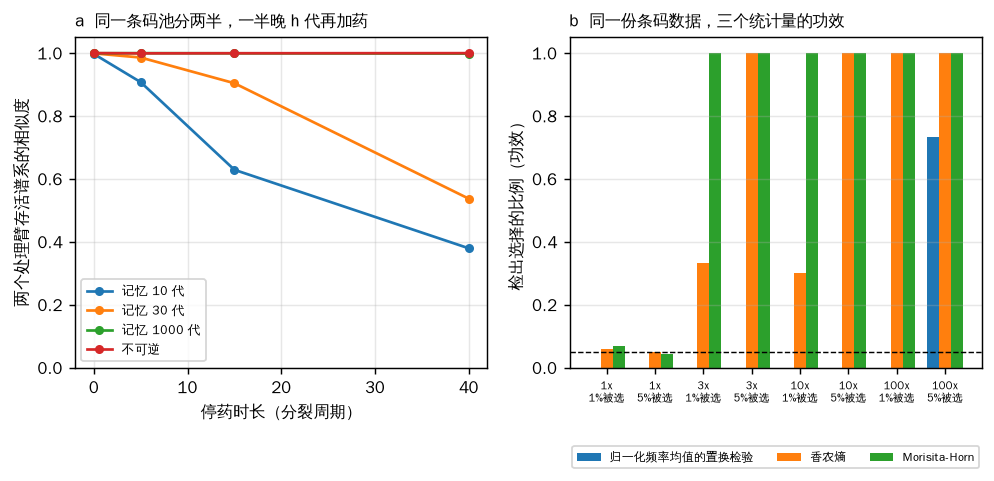
要把记忆时间测出来,得让状态有机会忘掉。 把同一个条码池分成两半,一半立刻加药,另一半在无药条件下等 $h$ 代再加药,比较两臂存活谱系的组成:
| 停药时长 | 0 代 | 5 代 | 15 代 | 40 代 |
|---|---|---|---|---|
| 记忆 10 代 | 1.00 | 0.91 | 0.63 | 0.38 |
| 记忆 30 代 | 1.00 | 0.99 | 0.90 | 0.54 |
| 记忆 1000 代 | 1.00 | 1.00 | 1.00 | 1.00 |
| 不可逆 | 1.00 | 1.00 | 1.00 | 1.00 |
(这张表的设置:治疗前耐受比例 5%,停药期间只让状态弛豫、两态都不增长。换设置数字会变,所以下面的功效段用的是同一组设置。)
停药必须长到与记忆时间同量级才有信息:等 5 代时几条线还挤在一起,而记忆 1000 代那一行在整个 40 代窗口里都和不可逆一模一样——看不到变化只能给记忆时间的下界,不能证明不可逆。要把"记忆 30 代"与"不可逆"分开,40 代的间隔下差距是 0.46,标准差 0.005–0.040,在这套设置里 300 条谱系就够(差距/标准差 11.6),一千条到 21,一万条到 95。这类实验的瓶颈不是条码数量,是耐心。
必须说清楚两个换算上的坑。一是时间单位:模型里的时间单位是一次分裂周期,而药里的细胞大多不分裂;把"记忆 10 代"换算成停药几周,需要另外测出耐受态细胞的实际分裂速率,本篇没有这个数,因此上表只能读成"以分裂计"的设计要求,不能直接换成日历天数。二是"记忆时间"与相似度曲线的关系:这里的 $\tau=1/k_{\rm off}$ 是耐受态的驻留时间,而群体组成的弛豫快慢由 $k_{\rm on}+k_{\rm off}$ 决定,还要叠上初始组成、正反转换、两态增殖差异与读出方式。所以上表的半衰点不能直接读成 $1/k_{\rm off}$,它只是这套设置下的一条经验曲线。
八、"条码分布没有差异"能证明没有选择吗
入口论文(s2)用条码实验排除了遗传克隆选择:比较对照与处理各时点归一化条码频率分布的置换检验,统计量取均值,各时点 p 均不显著,同时看香农熵的变化趋势一致。熵这一半是有信息的;均值那一半没有——归一化频率的均值恒等于 1/N(N 为检出的条码数),这是归一化本身的结果,与分布形状无关,所以这个检验实际只在比较两组的条码丰富度。
用模拟量化三个统计量在同一份条码数据上的功效(2000 个条码、每组 2 万读数、被选中的条码获得 1×–100× 的存活优势):
| 存活优势 × 被选比例 | 频率均值置换检验 | 香农熵 | Morisita–Horn |
|---|---|---|---|
| 1× 作用于 1% / 5%(无选择) | 0.000 / 0.000 | 0.058 / 0.050 | 0.067 / 0.042 |
| 3× 作用于 1% / 5% | 0.000 / 0.000 | 0.33 / 1.00 | 1.00 / 1.00 |
| 10× 作用于 1% / 5% | 0.000 / 0.000 | 0.30 / 1.00 | 1.00 / 1.00 |
| 100× 作用于 1% / 5% | 0.000 / 0.733 | 1.00 / 1.00 | 1.00 / 1.00 |
八种情形里有七种,均值置换检验的功效是 0.000——包括"1% 的条码获得百倍存活优势"这种极强的选择。熵在选择作用于较多条码时可靠,作用于 1% 时功效降到 0.3。与对照重复相比的 Morisita–Horn 在所有六种有选择的情形里功效都是 1.00,且无选择时的假阳性率 0.04–0.07 正常。
必须说明一处不确定:该文只写了「以均值为统计量」,没有公开具体调用方式,本篇按 scipy 双样本置换检验最自然的读法(两组均值之差)复算;若其实际写法不同,上面这一列的结论也会不同。
这不否定那篇的结论——它的正面证据(撤药后敏感性完全恢复、熵的同步下降)本身是有力的,而且第四节那篇独立地用谱系追踪支持了同一方向。不过这两条也不是各自单独就能排除选择:香农熵只看丰度分布的形状,条码身份被大幅置换时它可以一动不动;而"撤药后恢复敏感"同样兼容"原有的可逆亚群被选出来又弛豫回去"。要排除选择,靠的是这些读数加在一起,以及第四节那份谱系追踪。但**"检验不显著"这一条,在那个统计量下不承重**。这也是本篇给后续几篇留的一条通用提醒:报告条码实验的阴性结论时,需要同时报告该统计量对目标效应量的功效。
九、同一个遗传耐药机制,可以从两条路来
前面把"选择"与"状态转换"当成两种答案,但它们在时间上是接续的。Hata 2016(s4)在同一个 PC9 体系里把两条路同时拍了下来:
- 早出现的耐药克隆来自既有细胞。 1200 多个五千细胞的小池子里,两周后 5–10% 长出快速增殖的耐药集落,检查过的 50 个全部带 T790M;用 ClonTracer 条码分到五个重复,约 90% 的富集条码至少与另外两个重复共有,超过 50% 五个重复全部共有。作者估计亲本 PC9 里大约每 2.5 万至 5 万个细胞有一个带 T790M——低于当时测序与数字 PCR 的检出限。
- 晚出现的耐药克隆来自药物耐受细胞。 16 个没有早期集落的耐受细胞池继续培养,5 个后来获得 T790M;PC9-GR3 系里 T790M 第 22 周才首次检出(占 6%),一个月内成为主群。用 RFP 标记的 T790M 细胞掺入实验标定"既有细胞出头"的时间分布后,作者算出这些晚期克隆来自未检出的既有细胞的概率是 0.006。
- 两条路来的细胞不等价:从耐受态演化来的 T790M 细胞保留耐受态的转录特征,对第三代 EGFR 抑制剂的凋亡反应更弱。
所以"既有亚群 vs 状态转换"不是二选一,而是先后:状态转换先让一部分细胞活下来,活下来的细胞再成为遗传耐药的来源。这也解释了为什么第七节的简并很难靠单次实验消除——治疗过程本身在改变答案。
在患者身上能看到的对应现象是残留病灶的状态:对 30 位患者 49 份样本(治疗前/残留/进展)做单细胞转录组,残留期的癌细胞显著上调一套肺泡细胞基因程序(s6)。这类证据说明"残留细胞处在与治疗前不同的状态"在人身上成立,但它是取样关联,不能直接换算成本篇的谱系可复现度。
十、边界、反例与可以检查的预期
本篇没有证明的:
- 第二、三节的所有结论都来自一个细胞系、一种药、一个 14 天窗口。PC9 是长期传代的细胞系,其"治疗前异质性"未必代表患者肿瘤;数据里第 0 天只有一份样本、没有重复,所以起点的抽样噪声只能靠对半分自检来估。
- 条码只在能被捕获时才计数(这就是第二节说的那个排除不掉的候选)。如果某些谱系在药下的条码转录本表达系统性偏低,会被误读成"没活下来";这种偏差同样会在两个重复里复现,因此无法用可复现性判据排除。要排除它需要用不依赖表达的条码读出(如 DNA 层面的扩增子测序)。
- 第五至八节是模型与统计,不是对任何具体肿瘤的定量预测。两状态是卡通;真实的状态空间连续且多维。
- 本篇没有取药敏曲线以外的功能数据,也没有做任何治疗建议。健康议题按本库规矩只作研究。
被数据修正的预期: 开题时我预计"能扛药"和"还能分裂"会是同一批谱系里程度不同的表现,因而两档之间应当有明显重叠。实测的跨档相似度是 0.015,两档几乎不共享谱系;这一点按实测写成否定结论。
可以检查的预期:
- 在同一份 Watermelon 数据上,若能拿到第 14 天三档的实际分选比例并据此加权,可重新估计与起点及重复之间的相似度。本篇的分门及两种合并结果不能预定真实加权值,但提示重复间相似性可能仍较高——本篇已在分门与等门两种读法下核过(0.96–0.99)。若加权后重复间相似度明显掉下来,说明可复现度本身也被合并规则制造了一部分,第二节的主结论要改。
- 换一个已知靠药物诱导的体系(例如第四节的 FOLFIRI+结直肠癌类器官)做同样的两重复条码实验,预期与起点的相似度保持较高,或者掉下去时重复之间也掉下去。要留一个口子:如果不同谱系的诱导率本身有稳定差异,组成偏移与高可复现度可以同时出现——那种情形既不属于"纯诱导"也不属于"纯既有亚群",本篇第二节的判据分不开它,还需状态与功能读数来比较;停药再治可增加信息,但不保证单独分开全部解释。
- 用第七节的分半延迟设计做 PC9+奥希替尼:若两臂相似度随停药时长单调下降,在排除差异增殖、谱系选择和读出变化后,支持耐受态可逆且记忆时间有限(半衰点给的是 $k_{\rm on}+k_{\rm off}$ 那条弛豫曲线,要反推 $1/k_{\rm off}$ 还得再测一个量);若各档都在 0.9 以上,只能给出记忆时间的下界——任何有限窗口都可能看不见很慢的可逆过程,上表里"记忆 1000 代"那一行就是为此加的:它在 40 代之后两臂相似度 0.998,与不可逆的 0.999 分不开。具体停药几周要先测出耐受态细胞的分裂速率才能定,本篇不给周数。
- 若第九节的接续图景成立,则在同一实验里延长到出现遗传耐药时,晚期的赢家应当是早期赢家谱系内部的少数分支。要注意条码是随后代一起传下去的:晚期新改变若发生在早期赢家谱系内部,它仍带同一个条码,所以"早晚赢家条码的重合度"不必下降,甚至可能上升。要检验这条接续图景,需要能区分同一条码内部分支的信息——例如配套的突变检出(如 T790M)或状态读出,光看条码身份不够。