「测到了 KZ 标度」,测到的到底是什么
把一个系统推过连续相变,推得越慢,留下的缺陷越少。Kibble 与 Zurek 把这句话写成一条幂律:缺陷密度正比于 $\tau_Q^{-\alpha}$,而
$D$ 是空间维数,$d$ 是缺陷维数,$\nu$ 与 $z$ 是静态与动态临界指数。12
均匀费米超流给出两组数:温度淬火 $\alpha=0.69(2)$,相互作用淬火 $0.68(2)$,而 model F 的 $\nu\approx0.67$、$z=1.5$ 代进去给 0.67。1 二维双组分玻色气的数值给出涡旋数正比于 $\tau_Q^{-0.48\pm0.019}$,平均场的 $\nu=1/2$、$z=2$ 给 0.5。2 两处都可以写成同一句话:测到了普适的 KZ 标度。
这句话里叠着三件强度完全不同的事:
- 存在一条幂律;
- 它的指数落在某个普适类给出的数上;
- 数到的缺陷就是形成时刻生成的那些缺陷。
本文把三件事分开处理。先拆指数这条链条,看一个 $\alpha$ 到底定住了什么、定不住什么;再换两套与费米超流、与双组分玻色气都不相干的模型,从头把链条重算一遍;最后说明第三件事才是留出最大余地的那一件。
一个指数定的是一条曲线,不是一个点
把上式反过来解:
三维里的涡旋线 $D-d=2$。取三维 XY 的 $\nu=0.6717$,把两次淬火按误差加权合并($\alpha=0.6850\pm0.0141$),得到
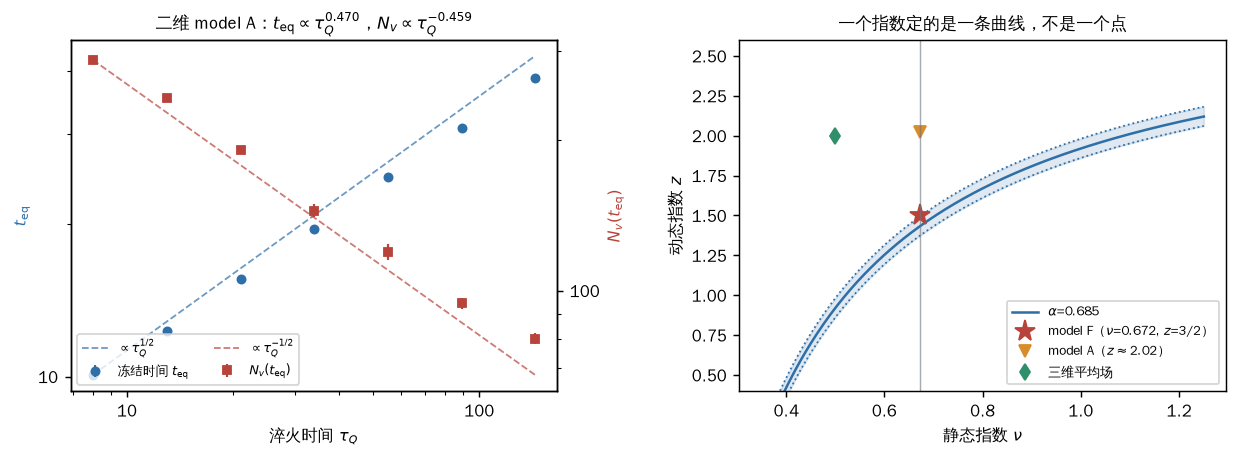
$\nu$ 自身的不确定度几乎不进来:$\nu$ 差 0.001 只再带来 0.0022。这个 $z$ 离 model F 的 $3/2$ 有 1.1 个标准差,而把 model A 的 $z\approx2.02$ 排除到 9.8 个标准差。
这比「与 0.67 相符」强得多:它是对 $z$ 的一次带误差棒的测量,并且否掉了一个具体的对手。但同一步也把一件事摆到明处——$\nu$ 是从外面输入的。若不另外知道 $\nu$,同一个 $\alpha$ 只定出 $(\nu,z)$ 平面上的一条曲线:在 $\nu=0.5$ 处它要求 $z=0.920$,在 $\nu=0.6717$ 处要求 $z=1.431$(图 1 右)。所以「指数与理论一致」这句话,一半是测量,一半是借来的。这不是毛病,是必须写清楚的记账方式。
几何换掉指数的数值,却一点也不改变它的杠杆
同一个普适类,放进简谐阱里适用另一个式子:$\alpha_{\rm inh}=(D-d)(1+2\nu)/(1+\nu z)$。3 同一个 model F,均匀样品给 0.6683,简谐阱给 2.3342(也就是 $7/3$),差 3.49 倍。指数不是材料的属性,几何也写在里面;跨几何比较两个 $\alpha$ 而不做换算,比较的是两件不同的东西。
同一个实验组的前一篇在简谐阱里测到 $\alpha=2.24(9)$。3 用阱的公式反解给 $z=1.626\pm0.125$,只能把 model A 排除到 3.1 个标准差,而均匀样品给 9.8 个。很容易把这 3.1 倍记到「把阱做均匀」头上。这笔账记错了地方。
$z$ 只出现在两个式子共同的分母 $1+\nu z$ 里,分子与 $z$ 无关。于是把 $z$ 从 $3/2$ 换成 2.02,两种几何给出的相对指数变化完全相同:都是 14.820%。几何改的是指数的数值,不是它对 $z$ 的杠杆。
真正的差别在别处:$\alpha$ 的相对精度,均匀实验 2.06%,阱中实验 4.02%。把后者的精度提到前者,它排除 model A 的力度就从 3.1 升到 6.1 个标准差;剩下的差距来自两次实验的中心值本来就落在不同的 $z$ 上(1.626 与 1.431),那是实验结果之间的差异,不是几何效应。均匀几何真正省掉的是一条需要额外假设的修正式,而不是提高了指数对 $z$ 的敏感度。
换两套毫不相干的模型,从头核这条链条
(一)一维横场 Ising 链的量子淬火。 这一支有精确解:扭结密度 $n=\dfrac{1}{2\pi}\dfrac{1}{\sqrt{2J\tau_Q/\hbar}}$。4 本文逐个动量直接积分 Bogoliubov 二能级方程,末态投影读扭结密度,与精确式比:$\tau_Q=2$ 差 1.45%,$\tau_Q=50$ 差 0.12%,log-log 斜率 $-0.5040\pm0.0009$。
放这一节有两个用处。一是锚点:同一套积分与拟合流程能把一个可解的情形复现到千分之一,后面那些没有解析解的数就不容易是数值假象。二是它顺手演示了「指数相符」这件事的弱点——一维量子 Ising($\nu=z=1$、$D-d=1$)与二维经典平均场点缺陷($\nu=1/2$、$z=2$、$D-d=2$)给出的都是 $1/2$,而两者的微观内容毫无关系。同一个数字可以由很不一样的链条凑出来。
(二)二维复 Ginzburg–Landau(model A)的经典淬火。 这是本文的主体:
$\eta$ 是高斯白噪声。涡旋按每个格点方块上的相位绕数直接数,因此任何时刻的涡旋数都可以读出来——这正是下一节要用的东西。
结果:冻结时间正比于 $\tau_Q^{0.4700\pm0.0040}$(KZ 给 $1/2$,2 测到 0.48),在冻结时刻数的涡旋数正比于 $\tau_Q^{-0.4588\pm0.0126}$(KZ 给 $-1/2$,2 测到 $-0.48\pm0.019$)。
两个数都比 $1/2$ 低几个百分点,而且低出的量大于统计误差。本文不把它们四舍五入成 $1/2$:有限格点、$\varepsilon$ 被截在 1、以及冻结时刻是按操作定义取的,都会往这个方向推。值得注意的是 2 自己测到的也是 0.48 而不是 0.50,方向相同。
形成律不是测量律
这一节只用上面那一批模拟,一个新的淬火都不跑,只换一件事:什么时候数。
| 约定 | 表观指数 |
|---|---|
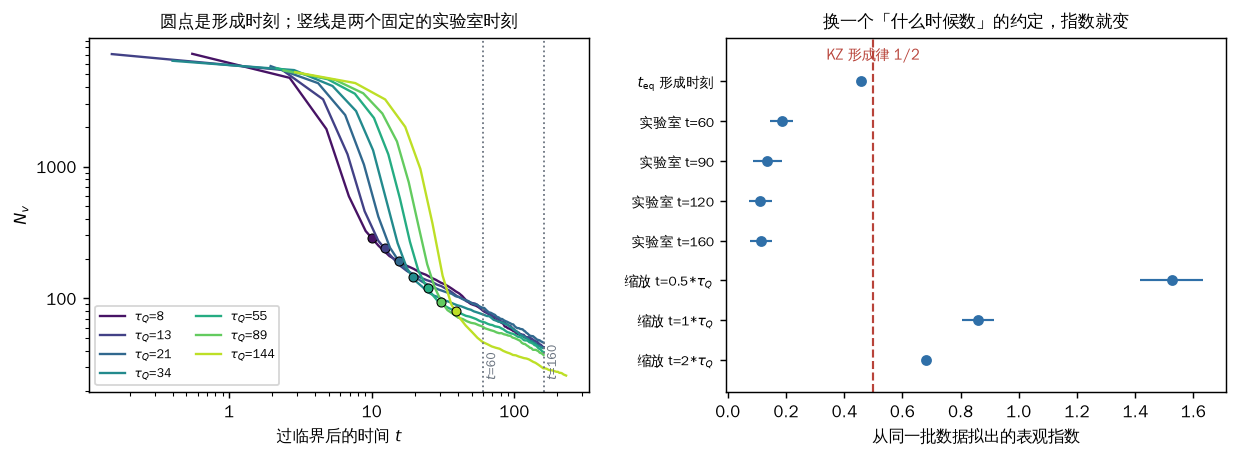
| 冻结时刻 $t_{\rm eq}$(形成时刻) | $0.4588\pm0.0126$ |
| 固定实验室时刻 $t=60$ | $0.1845\pm0.0410$ |
| 固定实验室时刻 $t=90$ | $0.1357\pm0.0493$ |
| 固定实验室时刻 $t=120$ | $0.1121\pm0.0396$ |
| 固定实验室时刻 $t=160$ | $0.1138\pm0.0372$ |
| 固定缩放时刻 $t=0.5\,\tau_Q$ | $1.5256\pm0.1078$ |
| 固定缩放时刻 $t=1\,\tau_Q$ | $0.8598\pm0.0554$ |
| 固定缩放时刻 $t=2\,\tau_Q$ | $0.6801\pm0.0075$ |
同一批数据,表观指数从 0.112 走到 1.526。在固定的实验室时刻数,淬火速率的记忆几乎被抹平:$\tau_Q$ 从 8 变到 89,$t=160$ 时的涡旋数只在 37 到 46 之间动。
还有一层更细的:连「形成时刻」这个约定本身,两处也不是同一个定义。本文取的是序参量模方达到平衡值的某个比例;2 取的是序参量从指数增长转入绝热线性增长的交叉点,而涡旋数恰在那一刻取极大(具体提取步骤在它的 Supplementary Note 1,本文没有取到)。两种定义在本模型里都落在同一段时间里,但它们不是同一个量——这一点本身就是本节论点的一个小型版本。
原因是粗化。二维点缺陷靠正反涡旋对湮灭而减少,5 最粗的写法是 $\dot N=-A N^2/S$($S$ 是面积),积出来
关键在 $t_c$ 反比于 $N_0$:慢淬火留下的缺陷少,于是它们衰减得也慢,把一部分差距又还回去。把 $N_0\propto\tau_Q^{-\alpha_{\rm form}}$ 代进去得 $t_c\propto\tau_Q^{+\alpha_{\rm form}}$,于是
两项预言都可以核。第一项:$t_c$ 实测正比于 $\tau_Q^{0.470\pm0.019}$,与它要求的 $+\alpha_{\rm form}=0.4588$ 在误差内相符。第二项:用各个 $\tau_Q$ 自己拟出的 $(N_0,t_c)$ 造出闭式曲线,再用与数据完全相同的方式拟斜率,得到
| 观测时刻 | 闭式预言 | 直接拟合 |
|---|---|---|
| $t=60$ | 0.191 | $0.1845\pm0.0410$ |
| $t=90$ | 0.145 | $0.1357\pm0.0493$ |
| $t=120$ | 0.114 | $0.1121\pm0.0396$ |
| $t=160$ | 0.085 | $0.1138\pm0.0372$ |
最大差 0.029,四个点全部落在直接拟合的统计误差之内。也就是说,表观指数被吃掉多少,是可以从两个参数算出来的:形成指数与粗化时标。
这里有一处值得记下来的反直觉。把衰减律换成看上去更贴合数据的形式——用实测的粗化段斜率 $-0.5613\pm0.0788$ 代替正反对湮灭给的 $-1$——预言反而全面变差,最大差扩大到 0.135。原因不难看:慢一些的衰减保留更多记忆,于是预言的表观指数偏高,而实测是偏低的。拟合优度更好的那个参数化,在这个问题上给出的是更差的预言。另一处同方向的提醒是:两参数拟合给出的「初值」$N_0$ 按 $\tau_Q^{-0.418\pm0.033}$ 标度,与在冻结时刻直接数出来的 $-0.4588\pm0.0126$ 并不是同一个量。
顺便得到一条可用的经验规则:要保住九成的形成指数,观测必须早于 $t_{\rm eq}+t_c/9$。本模型里 $\tau_Q=8$ 时 $t_c\approx43$,$\tau_Q=144$ 时约 172。已发表的实验在淬火后等 0.2 s 再成像,而涡旋衰减的时标约 1 s。1 若把这个比值当作 $t/t_c$ 代进闭式,形成指数还剩五分之四略多,也就是说压低幅度不到两成。这是一句值得各自核算的提醒,不是对那篇工作的判断——衰减时标与本模型的 $t_c$ 不是同一个量,真正该做的是用它自己的衰减曲线拟出 $t_c$ 再代。
窗口:两端都有硬边界,成因不同
标度区不是无限长。慢端很直白:淬火慢到平均只剩不到一个缺陷,幂律就没有意义了;本文 $256\times256$ 的格子上这个边界落在 $\tau_Q\sim6.6\times10^5$。
快端不一样,它是饱和。把慢端三点的幂律外推过去,$\tau_Q=5$ 处实际值低 6.7%,$\tau_Q=3$ 低 16.9%,$\tau_Q=2$ 低 27.0%——淬火再快,缺陷也不再按幂律继续增多。这与「快到一定程度就等同于瞬时淬火」的图像一致:$\tau_Q$ 小到某个值以下,冻结长度已经接近初始涨落自带的关联长度,再快也没有东西可以再多冻出来。本文扫到的最快一点还没有完全平,但偏离是单调增大的。把快端一起拟进去,整段斜率从 $-0.4496$ 被拉平到 $-0.3183$。这正是两篇入口各自划出标度区的理由:2 明写 $\tau_Q<20$ 时 KZ 标度失效,1 报告两种淬火都在涡旋数 10 附近开始饱和。
换个时刻数,饱和只会更彻底:同一批快淬火在固定实验室时刻 $t=60$ 数,$\tau_Q$ 从 2 到 21,涡旋数只从 97.5 走到 85.0,斜率 $-0.0516$。上一节说的「测量律不是形成律」在这里叠加了一次——快端本来就平,再等一段时间数,就几乎全平了。
窗口有多宽取决于格子有多大,而且长得很慢:
| 边长 $L$ | 窗口宽度(十进位) |
|---|---|
| 128 | 3.296 |
| 256 | 4.500 |
| 512 | 5.704 |
| 1024 | 6.908 |
| 2048 | 8.112 |
线度加倍只买到 1.20 个十进位,因为冻结长度只按 $\tau_Q^{1/4}$ 长。想把标度区拓宽一个量级,格子要放大到十倍以上——这也是为什么「把样品做大」很难成为改善指数精度的主要手段。
位置像 Poisson,符号完全不像
2 报告涡旋位置可以用 Poisson 点过程描述,并给出最近邻间距分布。「像 Poisson」是个复合判断,本文把它拆成三项,在同一批 model A 淬火的冻结时刻分别检验(每个 $\tau_Q$ 十四次噪声实现)。
第一项,数目涨落。 把格子切成边长 16 到 128 的方格数涡旋,Var/Mean 落在 0.77 到 1.16 之间,Poisson 给 1。通过。
第二项,最近邻间距。 归一化之后与 $p(S)=\frac{\pi}{2}S\,\mathrm{e}^{-\pi S^2/4}$ 比,KS 距离 0.027 到 0.029。看上去小得可以直接说「符合」——但样本量也很大($\tau_Q=21$ 那一组有 2344 个涡旋),同样本量的 5% 临界值分别是 0.028、0.035、0.041,实测与临界之比是 0.97、0.80、0.71。所以正确的说法不是「符合 Poisson」,而是「在这个样本量上还分不开」,而且最大的那一组已经贴到临界线。这两句话给出的下一步完全不同:前者结案,后者要求把样本量再加一倍。
第三项,符号。 这一项塌得干干净净。最近邻异号的比例是 0.930、0.937、0.930,而符号独立会给 0.5。会不会只是格点分辨不开的近对造成的假象?把最近邻间距小于 5 个格距的对全部剔掉(平均间距约 11 个格距,剔掉之后还剩 81% 到 92% 的对),比例仍然是 0.914、0.925、0.925。
再往大尺度看:半径 $R$ 的圆盘里净荷的方差 $\langle Q^2\rangle/\langle N\rangle$,符号独立会给 1 且与 $R$ 无关。实测在 $R=8$ 处是 0.66,$R=64$ 处降到 0.0871,随半径的幂是 $-1.044\pm0.013$、$-1.066\pm0.014$、$-1.039\pm0.022$。$R^{-1}$ 正是净荷只来自边界的周长律:圆盘里正负涡旋成对抵消,剩下的净荷只由被圆周切开的那些对贡献,方差便按周长而不是面积增长。这不是一群互相独立的点,是一团中性且互相屏蔽的正负涡旋。
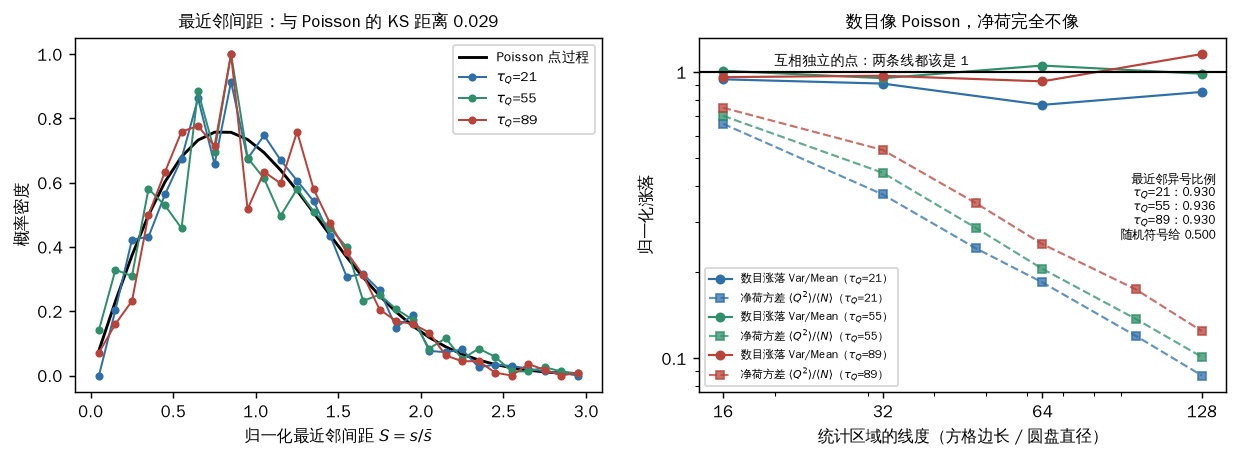
要说清楚的是,2 自己在正文里写明畴合并时产生的是「数目相等的量子涡旋与反涡旋」,也就是说它并没有主张符号独立——它主张的是位置可以用 Poisson 点过程描述。本文要指出的是:这两件事被同一句「well described by a Poisson point process」带过时,读者很容易把一个关于位置的陈述当成关于整个构型的陈述,而后者是错的,并且错得可以量化(异号比例 0.93 对 0.5,净荷方差 $R^{-1}$ 对常数)。
这一节也没有推翻 2:它做的是双组分玻色气的 SPGPE,本文做的是单组分二维 model A,两者不能直接对。它说明的是这句话本身要怎么写才可判:「涡旋位置可以用 Poisson 点过程描述」可以在数目与间距两个边缘分布上成立,同时在符号上错到极处。而符号恰恰是能区分机制的那一项——独立形成的缺陷不会有 0.93 的异号最近邻,成对产生的会。
边界、反例与可检查的预期
没有覆盖的: 全部自算都在二维、经典、单组分、周期边界的 model A 上,格子 $256\times256$。没有做三维,没有做费米子,没有做双组分 SPGPE,也没有做非均匀(简谐阱)的数值——阱里那一条完全依赖 3 写出的解析修正式,本文没有独立核过它的推导。噪声强度与格距没有对任何真实体系标定,因此本文的 $t_{\rm eq}$、$t_c$ 的绝对值只在模型内部有意义,能往外搬的只有无量纲的标度关系。
方法上的一处弱点: 冻结时刻 $t_{\rm eq}$ 是按操作定义取的(序参量模方达到平衡值的某个比例,并在记录点之间线性插值),不是一个无歧义的物理时刻。换一个阈值,$t_{\rm eq}$ 的前因子会变。本文没有系统扫过这个阈值,而第四节第一行的指数直接依赖它。这一条是全篇最应该被别人复核的地方。
一处已经改掉的错,写在这里作为反例: 快端最初是用「只积到 $1.6\,\tau_Q$」的短窗口跑的,$\tau_Q=2$ 处读到的涡旋数比慢端外推高出一倍以上,看上去像是快端「多出来」。把积分窗口加长之后,同一个 $\tau_Q=2$ 给的是低 27.0%,方向完全相反。原因是短窗口里冻结判据根本没被满足,读到的是淬火刚结束、尚未开始湮灭的那个瞬间(这一版的具体数字来自开发过程中的一次运行,现在的脚本不再产生它,所以正文只保留方向)。同一段数据在两种窗口下给出方向相反的结论,这正是本文主线的一个自证:测量约定不是记账细节,它能改变结论的符号。
一处方向上的系统性: 第五节的闭式在四个观测时刻都落在误差内,但方向不是随机的——$t=60$、90、120 三点预言偏高,只有 $t=160$ 预言偏低(0.085 对 $0.1138\pm0.0372$)。这说明两参数的粗化描述在长时间端开始不够用,与 $N_0$ 的标度($-0.418\pm0.033$)和形成时刻的直接计数($-0.4588\pm0.0126$)对不齐是同一件事的两面。误差内不等于没有信息,符号的排列本身就是下一步该查的地方。
可检查的预期:
- 同一台装置、同一批淬火,只改变等待时间。 本文最强的预期是:表观指数随观测时刻单调下降,且下降的方式由 $\alpha_{\rm form}/(1+t/t_c)$ 给出,其中 $t_c$ 可以从同一批数据的衰减曲线独立拟出来,不需要新参数。把等待时间从 0.2 s 扫到几秒,测到的 $\alpha$ 应当明显变小;若它在误差内不动,说明整个观测窗口都落在 $t\ll t_c$ 一侧,那时才可以把测到的指数当形成指数用。这一条不需要任何新装置,只需要把同一组数据按不同等待时间分别拟合并分别报告。
- 符号的最近邻统计。 任何能分辨涡旋符号的成像都可以直接测最近邻异号比例。若缺陷确实是成对产生的,这个比例应当远高于 0.5;若测到接近 0.5,本文第七节就错了。它随粗化怎样演化本文没有算,而这正是一个能分辨两种图像的量:若屏蔽是标度不变的,比例应当在缺陷变稀之后仍然保持高位;若只是「独立产生、近距离随机配对」,比例应当随平均间距变大而向 0.5 回落。
- 净荷方差的周长律。 $\langle Q^2\rangle/\langle N\rangle\propto R^{-1}$ 是一条比「像 Poisson」硬得多的判据,而且不需要分辨单个涡旋的位置,只需要能测出一个区域里的净环量。若某个体系测到它与 $R$ 无关,那里的缺陷符号就真的是独立的,本文关于「成对产生」的图像在那里不成立。
- 快端膝盖由微观尺度定,与系统大小无关。 慢端三点($\tau_Q=8$、13、21)本身就是拟合基准,残差不到 1%;第一个不参与拟合的点 $\tau_Q=5$ 已经偏 6.7%,到 $\tau_Q=2$ 偏 27.0%。膝盖因此落在 5 与 8 之间。与慢端不同,这个位置不应当随格子边长移动——慢端只由边长定,快端只由噪声强度与短程截断定。把格子加倍而膝盖不动、把噪声强度改一倍而膝盖跟着动,这两条一起就能把两端的成因分开;若膝盖随边长移动,本节对快端的解释就错了。
如果被推翻: 只要有人在一个体系里证明表观指数与观测时刻无关(且观测时刻确实跨越了 $t_c$),第五节的主线就错了。反过来,本文没有、也不能证明已发表的那些 $\alpha$ 测错了——本文说的是这些数在被引用时必须带上「什么时候数」这个标签,而这个标签目前很少被写出来。
数据与代码
复算脚本 research/calculations/quench_rate_and_defect_history.py,输出在 research/assets/2026-09-16-quench-rate-and-defect-history/(results.json 与 18 个 CSV、3 张图)。随机种子全部固定,两次完整运行在本文引用的所有有效数字上一致。原始文献在 evidence/2026-09-16-quench-rate-and-defect-history/。