找到一条路线以后,还有三种不同的判断
稀有事件太少,直接模拟常把大部分资源花在等待。路径采样让成功转变更常出现,机器学习又可以从这些路径学习反应坐标。问题在于:算法改变了我们看到的路径频率。
一条路线能够在原动力学中发生,只说明它可行;它占成功路径的多少,关乎相对概率;每单位时间发生多少次,还关乎物理时钟。漂亮、连贯的路径图不足以同时证明三者。
Breebaart等人的方法研究已在2026年发表于PRL。本文取得的是2025年作者v1全文及其中补充材料,另核2026发表题录与公开固定代码;发表PDF未取得。版本分界保留,不把早期附件当作已核的最终发表附件。1
本文把该研究作为真实方法入口,实际执行其中势能/梯度和权重映射函数的有限核验;完整AIMMD-TIS、神经网络训练与主客体分子轨迹没有重跑。统计比较则采用本库透明的双通道链,检验权重、覆盖、计算预算与样本相关性。
原方法怎样绕过漫长等待
界面采样从离开A的路径开始,按它们能否越过不同界面组织路径系综;既包括成功到B,也包括返回A。各条路径仍按原动力学生长,但不同系综中被保留、被看到的机会不同。
因此,改变路径系综的取样频率,可以不改变每条轨迹的动力学。这与给体系加一股外力推动转变,是两种不同的加速方法。
原作者版以WHAM匹配重叠界面的跨越概率,再构建重加权路径系综RPE;同一路径的各时间帧沿用该路径权重,并结合稳定态模拟。转变速率还需要离开稳定态的通量:
只知道最后一个概率,不知道多久有一次起步,就没有速率。原文的正反路径权重匹配用于平衡系综;不能不加论证地把它搬到T112那类有稳态环流的非平衡系统。1
本库从固定代码抽取两个原权重映射方法,在已给定跨越曲线与直方图的合成输入上执行,独立计算最大差约$4.2\times10^{-22}$。2 这确认所核函数如何分配权重,不确认输入曲线正确,也不等于复现WHAM估计或完整采样。
先准备一个能独立核对的二维参照
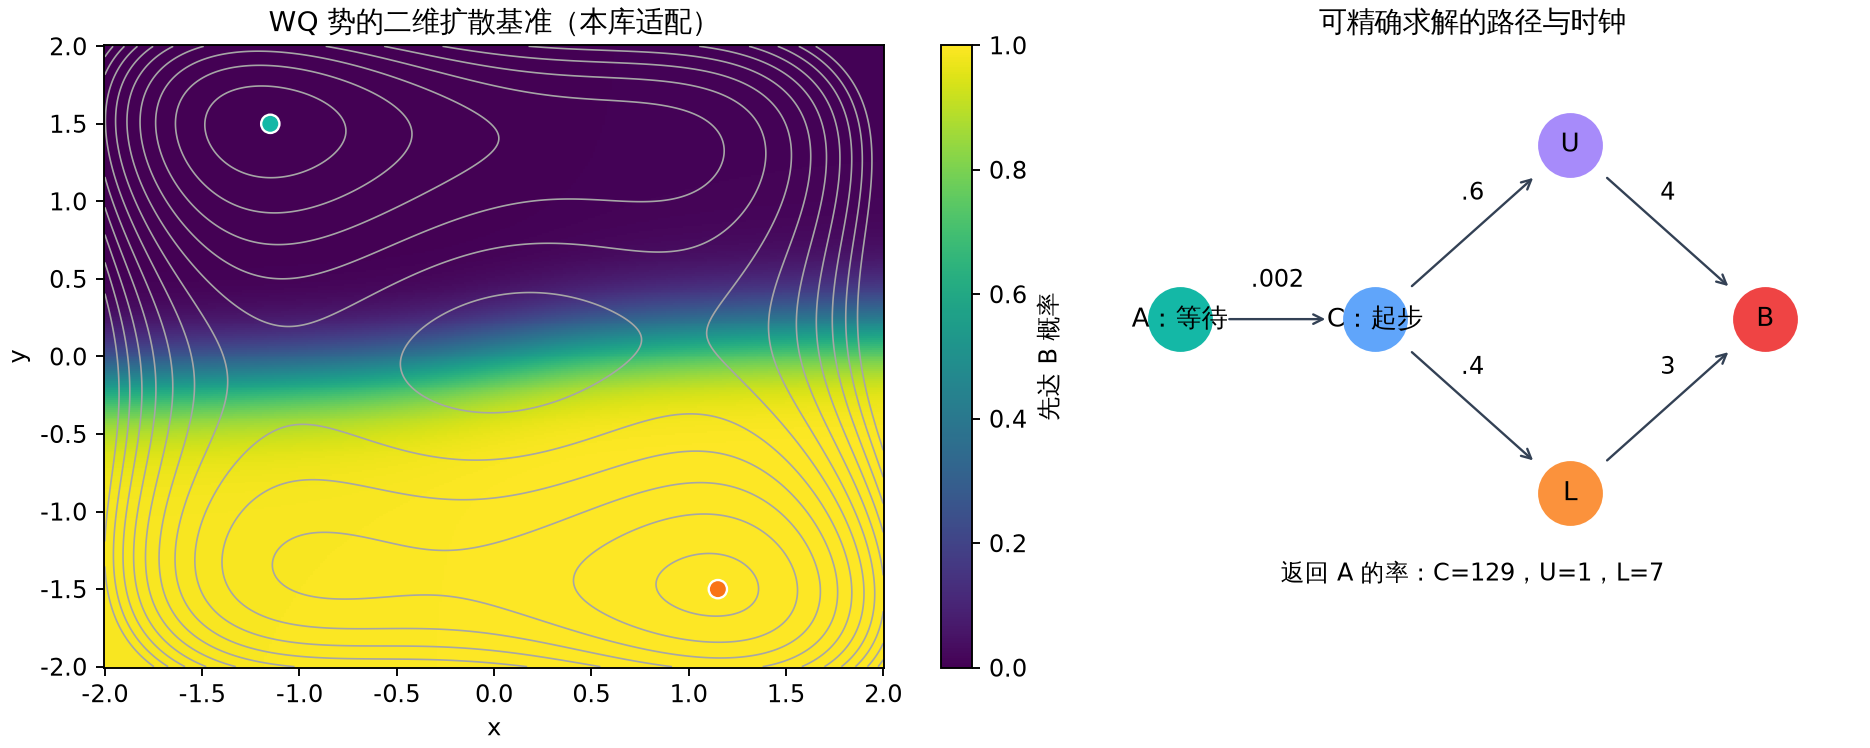
原作者版的Wolfe–Quapp基准有两个反应维度与20个谐振子维度,采用带惯性的Langevin动力学。本库只适配其二维势,采用无量纲温度1的过阻尼扩散:
常数项不改变力。A/B为以$(-1.15,1.5)$、$(1.15,-1.5)$为中心、半径0.25的圆;有限方域$[-2,2]^2$反射。本库实际执行原源码的势能/梯度类,在500点与独立多项式完全一致,再用数值差分核导数,最大差约$1.7\times10^{-9}$。该类位于原仓库build/lib,此次显式选择不旋转、尺度2,并不声称默认导入或完整环境已经运行。
以满足详细平衡的有限格点跳跃链求解先达概率$q$,网格0.05、0.025、0.0125之间的最大$q$差,从约$7.8\times10^{-4}$降至$1.9\times10^{-4}$。独立生成1500条跳跃发射,三组全部到达A或B,成功比例与格点$q$相差不到0.93个抽样标准误。
这提供可回查的本库适配基准,没有给出作者22维惯性模型的复现率。圆形边界离散、有限反射域与动力学差异都保留。验证一种方法时,势能相同并不足以保证基准相同。
一个最小例子:真正主要的路线可能被算法画成次要路线
五态链从A等待到C,再选择立即返回A,或进入上通道U、下通道L。原跳跃率为:
| 位置 | 出发方向与率 | 下一阶段的先达B概率 |
|---|---|---|
| A | 到C:0.002 | 由后续路线决定 |
| C | 到A:129;到U:0.6;到L:0.4 | $p=3/650$ |
| U | 到A:1;到B:4 | 0.8 |
| L | 到A:7;到B:3 | 0.3 |
C的一次起步成功概率是:
成功路径中,上通道份额是0.8。它比下通道重要,并非仅因C去U比去L多,还因为U更容易继续到B。
现在人为采用取样提议$Q$,增加C去两条通道的概率;U/L之后的动力学和C的总退出率130保持相同。偏向下通道的提议取:
成功概率变成$0.09\times0.8+0.81\times0.3=0.315$,成功路径上通道份额却只有约22.86%。算法找到的每一条路线都可行,未经校正的路径频率仍将主要机制颠倒。
这个人为提议改变了跳跃选择概率,用于使权重问题透明;它不是原作者保持动力学的TIS实现。两者共同需要恢复目标路径测度,具体权重构造不同。
权重怎样把概率恢复回来
若原路径概率为$P(\omega)$、取样概率为$Q(\omega)$,且所有目标路径仍有取样机会,定义:
本例只有C的分支被改变,且等待时间律相同,故整条路径的似然比就是该分支的$P/Q$。成功概率可用$\widehat p=N^{-1}\sum_iw_iY_i$估计,$Y_i$是是否到B;成功路径上通道份额是:
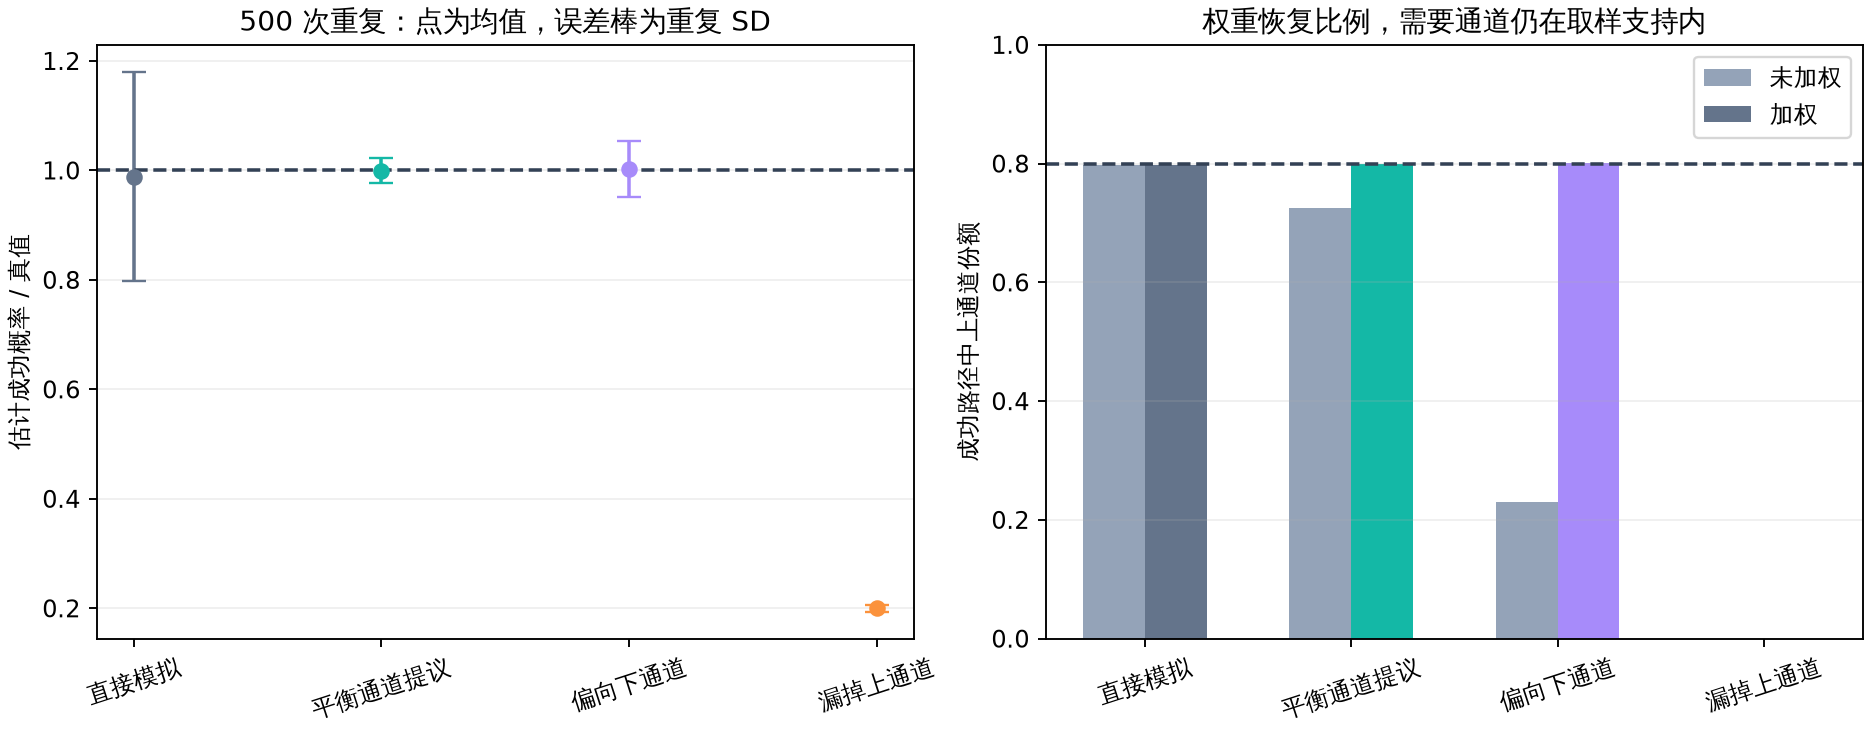
前者在完整支持下是无偏均值估计,后者是有限样本有比值偏差的一致估计。本库实际按同一预期传播预算比较,每种提议独立重复500次:
| 提议 | 未加权成功概率 | 加权成功概率均值 | 加权估计的跨重复SD | 未加权/加权上通道份额均值 |
|---|---|---|---|---|
| 原动力学直接模拟 | 0.00456 | 0.00456 | 0.000883 | 79.84%/79.84% |
| 平衡提议$(0.4,0.3,0.3)$ | 0.33004 | 0.00461 | 0.000107 | 72.56%/79.86% |
| 偏向下通道$(0.1,0.09,0.81)$ | 0.31492 | 0.00463 | 0.000234 | 22.95%/80.03% |
| 漏掉上通道$(0.1,0,0.9)$ | 0.26970 | 0.000922 | 0.0000271 | 0%/0% |
每次预期约6000个起步后实际使用的跳跃传播,固定尝试数分别为5954、3750、3157、3157;实际平均开销约6000,单次范围约5924—6085。固定样本数避免由随机停预算产生额外停止偏差。预算不计模型准备、提议设计、稳定态通量估计或神经网络训练,因而不能将此表宣称为整个AIMMD-TIS的CPU加速倍数。
前三行的成功概率均值与解析值相差不到1.31个跨重复均值标准误,实测SD与独立解析方差相差不到3%。平衡提议在此传播预算下的方差约为直接模拟的1/64;偏向下通道也有增益,但较差的通道分配耗掉一部分收益。加速和正确性在限定条件下可以兼得。
漏掉路径时,精度越高也可能只是越精确地算错
最后一行没有任何上通道路径。$P/Q$在那些路径上不存在,已有的下通道权重只能恢复下通道的那部分概率,即真值的20%。再采一百万条同种路径,也不会自动补出另外80%。
这个失败看上去甚至很“稳定”:成功事件的权重有效样本数平均约851,高于偏向下通道的约349;加权成功概率SD只有约$2.7\times10^{-5}$。大有效样本数和小波动,都无法证明路径覆盖完整。
常用权重诊断:
只描述已观察样本的权重集中。关心成功事件时,还应查看用$w_iY_i$形成的事件诊断;直接模拟全部路径权重均匀,全部路径有效数5954,成功事件实际平均却只有约27条。有效样本数依赖要估的量,也不包含未见通道的信息。
漏采提议的平均总权重期望为约0.99538,乍看很接近1,因为漏掉的上通道尝试只占原起步的约0.46%;它们却占成功转变的80%。只查总质量,也未必对目标事件有足够判别力。
更有效的对照包括不同通道初始路径、不同界面或坐标、独立重复,以及在可解基准上核各通道概率。多次随机种子都从同一条通道初始化、又从不跨通道,不构成独立的覆盖证据。
路径数、帧数和物理时间不能互相替代
路径里连续许多帧共享同一次起步和结局;MCMC连续路径也可能相关。权重均匀并不意味着独立。
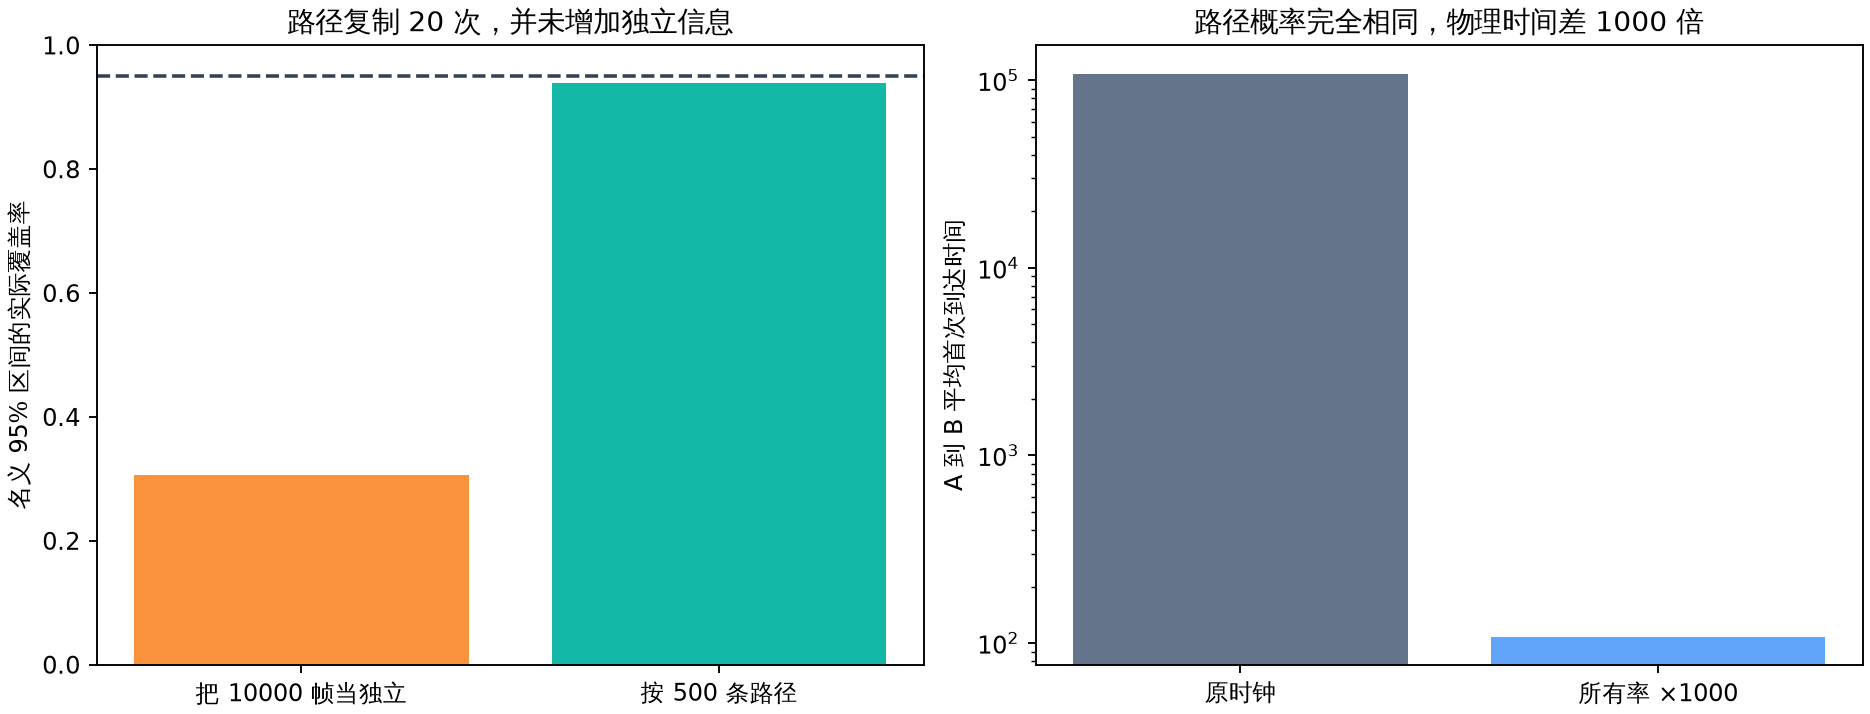
本库做一个可控反例:500条独立成功路径,以0.8概率走上通道;每条复制20次,得到10000帧。2000次重复中,把10000帧当独立形成的名义95%正态区间,实际只约30.55%覆盖真值;以500条独立路径计算则约93.95%。标准误相差$\sqrt{20}\approx4.47$。这里是人为完全复制,未测作者真实自相关;它用于隔离“更多帧不等于更多独立信息”的机制。
对于真实数据,应按路径、相关长度足够的块或独立采样运行估不确定性;仅把同一路径的帧随机分为训练集和测试集,不能保证测试已独立。
时钟也有同样的陷阱。五态链一次完整尝试的平均时间为:
从A到B的平均首次到达时间为$\bar t/p\approx108335.27$,与独立解后向方程一致。把所有跳跃率乘1000,路径选择与通道份额完全不变,平均首次到达时间却降为约108.34。
已知在A的出口率0.002,乘$p$得到$9.230769\times10^{-6}$;完整首次到达时间的倒数为$9.230604\times10^{-6}$,微小差别来自起步后占用的时间。这里把“以A内时间归一的出口量”和“从A开始的完整更新时钟”分别定义,不把近似相等推广成恒等。
若加速算法还改变等待时间或动力学,完整路径权重必须包含对应的时间/动力学似然比;只校正通道终点是不够的。估状态占有也需要按停留时间累计,不能把一条长路径和一条短路径各算一票。
学到极小概率,应该怎样验证
加权数据也会影响学到的先达概率。对同一状态的加权二元似然,最优常数概率是$\sum w_iY_i/\sum w_i$;若忽略选择权重,就会学习提议中的成功频率,而非目标动力学的概率。
原作者v1补充材料的分子验证选400个过渡区构型,每点100次按Boltzmann速度初始化的发射;选点logit范围$[-4,4]$,对应概率约0.018—0.982。文中也明确接近稳定态的小概率更难用直接发射验证。1
100次发射都未成功,独立二项模型下单侧95%上界仍约为0.02951;1000次全零,上界也约0.002991。不能把“没有看到成功”解释为已直接验证$10^{-10}$或$10^{-20}$。
这不否定尾部概率可借助界面分解和重加权估计,而是限定证据:过渡区发射、界面重叠与概率比、独立重复、稳定态通量,分别验证不同环节。直接发射通过的范围,不能冒充整个概率尾部已经被同一实验验证。
本篇得到什么,仍缺什么
在目标路径都有取样机会、完整似然比可算、时钟与误差正确处理时,加速采样能恢复真实概率,也能提高有限传播预算的精度。本库已经用显式路径枚举、500次重复和独立方差验证了这个条件性答案。
一旦主要通道漏掉,权重、损失下降、小误差棒和大样本数都可能给出错误信心;只画成功路线也不足以识别真实速率。二维适配、原函数有限执行与独立跳跃发射只核其声明范围,未完成原神经网络方法或分子系统的全面复现。真实方法的训练开销、跨通道混合时间、最终发表附件差异和极小概率尾部,仍需额外证据。
来源与复算范围
<a id="source-s1"></a>[1] Rik S. Breebaart、Gianmarco Lazzeri、Roberto Covino、Peter G. Bolhuis,2026 PRL Understanding Mechanisms of Molecular Rare Events from Start to Finish,发表入口。本库核发表题录/摘要;实际取得并读相关正文、方法、WQ参数与分子验证的是2025-07-05的作者v1及内附SI,标题为 Understanding Reaction Mechanisms from Start to Finish。发表PDF401未取,不混同版本。
<a id="source-s2"></a>[2] 原作者公开代码,aimmd-tis,固定提交2f5dd9b4e76c6b5ec8a0b52a101cfe414356b671。取得五个相关脚本、README与树/提交元数据;实际隔离执行WQ势能类和两个权重映射方法,未执行完整WHAM、OPS、Torch训练或分子模拟。
本库代码research/calculations/path_sampling_weights.py及path_sampling_weights_audit.py;原件与独立发射记录在evidence/2026-10-08-path-sampling-weights/,来源/自审在相应research/sources/JSON。参数、三网格和全部抽样统计见results.json,重复数组见batch-records.npz。