先给一句短答案:免疫系统确实在挑肿瘤,但基因组上最常被引用的那条证据("新抗原比预期少")在单个肿瘤里几乎什么都证明不了——它的表观量级与"从未见过免疫系统的模拟突变"给出的一样大,而在本篇的理想功效近似下,单个肿瘤按两计数比估计的中位最小可检出耗竭约69%,四格比则约86%,具体随样本而变。能定位免疫压力的是直接看逃逸事件本身,以及看它发生在肿瘤的哪一段时间、哪一处空间——而这两件事在不同癌种里给出的图景并不整齐。
一、把问题拆成识别、进入、清除,再加一根时间轴
"免疫系统限制肿瘤"至少混着三个环节:癌细胞是否可被识别(有没有新抗原、抗原提呈通路完不完整)、免疫细胞能否进入并接触(浸润、排斥、边缘 vs 核心)、接触后能否清除(细胞毒功能、抑制性信号)。三者互不蕴含:浸润多不等于杀得动,抗原多不等于被识别。
再加一根时间轴,问题就变成本篇真正要区分的两件事:
- 曾经被选择:肿瘤历史上某一段时间里,带新抗原的谱系被清除掉了,留下"新抗原比预期少"的痕迹;
- 现在还在被选择:此时此刻免疫系统仍在移除某些细胞。
这两件事在同一份测序数据里长得几乎一样。下面先看第一件能测到什么程度。
二、"新抗原被耗竭"这个信号,模拟出来的突变也有
如果免疫杀伤持续在移除带新抗原的细胞,那么在存活下来的肿瘤基因组里,被判定可提呈的新抗原相关非同义突变可能偏少。但原研究的两个分析口径要分开:下述癌种级四格方法按所选常见HLA及参考肽定义结合区域,后面的逐样本分析再使用患者自己的HLA。先看癌种级HLA结合突变比(HBMR):$(n^+/s^+)/(n^-/s^-)$,其中 $n$ 是非同义、$s$ 是同义突变,上标 $+/-$ 表示是否 HLA 结合。若有耗竭,HBMR < 1。
本篇重算了 van den Eynden 等 2019 年公布的泛癌统计(s1)。要先把两个分母分开:该文的癌种级 HBMR 表覆盖 19 个癌种、合计 7240 例,另一张逐样本表有 8165 行,两者不是同一个分析的同一个分母。下面先看癌种级的表,把观测值与该文用同一套突变谱、同一批基因模拟出来的突变并排放:
| 量 | 实测 TCGA 突变 | 模拟突变(从未见过免疫系统) |
|---|---|---|
| HBMR 中位数 | 0.898 | 0.879 |
| 19 个癌种里低于 1 的 | 13 | 16 |
| 与实测的相关 | — | Pearson 0.91 |
| 与实测的中位绝对差 | — | 0.037 |
也就是说,这个表观耗竭的大部分可由突变谱与基因组成解释——哪些基因更常突变、哪些位点的三核苷酸背景更容易出非同义变化,与免疫无关。按组成期望校正之后(该文的 HBMR_norm),19 个癌种的中位数回到 1.018,范围 0.921–1.134。
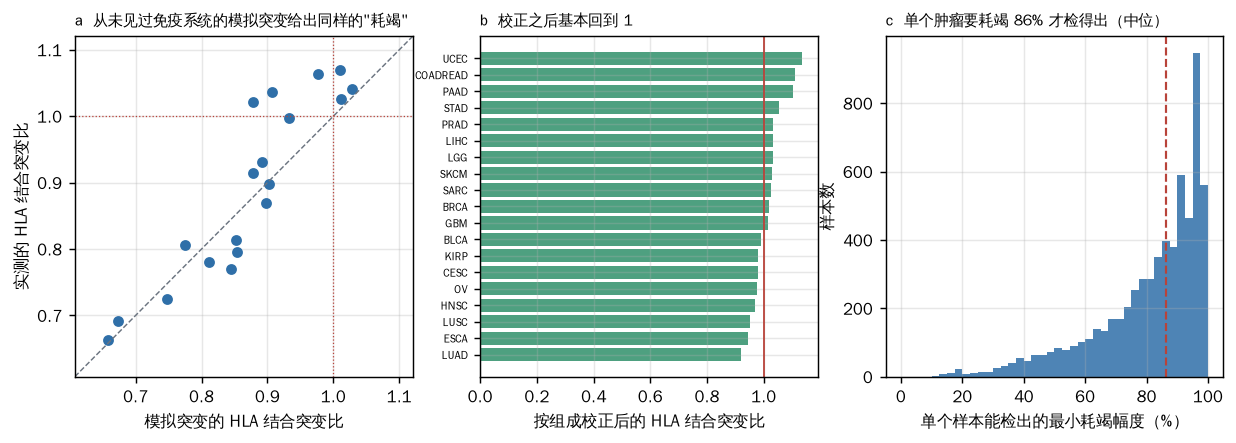
两项内部核对:一是把表里的四类计数按定义重算 HBMR,与该文报告值的最大绝对差是 3.5×10⁻⁵,说明本篇的读法与它一致;二是把 19 个癌种的校正值按逆方差合并,得到的总体校正比值是 1.044(95% CI 1.036–1.052)——不是低于 1 而是略高于 1,且异质性检验 $Q=278$(自由度 18,$p\approx0$)说明各癌种彼此严重不一致。合并值不符合单纯耗竭的方向,且高度异质;残余背景偏差、其他选择和取样差异都可能贡献,不能据此唯一归因。
值得单独说的是校正之后仍显著的七个癌种:只有肺腺癌(0.921)与肺鳞癌(0.952)显著低于 1,其余五个(结直肠 1.108、胰腺 1.105、子宫内膜 1.134、胃 1.054、黑色素瘤 1.028)显著高于 1。高于 1 不符合"带新抗原的谱系被清除"这个方向,但它也不只有一种解释:校正模型的残余偏差、别的选择过程(原文自己就在 HBMR 的定义附近保留了正选择可使比值高于 1 的读法)、取样与统计不确定性都可能贡献。能确定的是这套读数没有给出干净的耗竭信号;把偏离一概归到"模型偏差"同样是过度断言。这同时提醒:那两个低于 1 的读数虽与肺癌确有免疫选择的其他证据一致,量级也只有 8% 与 5%,落在同一套模型的误差范围附近。
合并值的窄区间要按条件读:它是固定效应逆方差合并的结果,只计入了各癌种内部的抽样误差,没有计入期望模型本身的误差;而 Q=278 说明各癌种之间的差异远超抽样误差。所以这条窄区间不是总不确定度的界,也不能据此断言"再多样本也不会更准"——能说的是,在这套背景模型下,各癌种的残余偏离彼此不一致,光靠加样本量解决不了这种不一致。逐样本层面同样:8110 例可算样本的 $dN_{\rm HLA}/dN_{\rm non\text{-}HLA}$ 中位数是 1.006(四分位区间 0.73–1.28),模拟突变给 0.972。
三、同一个阴性结论,在两个尺度上完全不是一回事
"没查到耗竭"要有意义,先得知道能查到多少。这里必须先分清两个统计量:癌种级用的是四格 HBMR $(n^+/s^+)/(n^-/s^-)$,而该文的逐样本分析用的是 $(n^+/n^-)/\text{期望}$——分母是模型给的期望,不是 $s^+/s^-$。两者的标准误不同,功效必须分开算。下面用对数比的正态近似给 80% 功效下可检出的最小耗竭:
| 尺度与统计量 | 能检出的最小耗竭 | 能查出 50%/20% 耗竭的样本比例 |
|---|---|---|
| 按癌种汇总的四格 HBMR(19 个癌种) | 2.2%–12.7%(黑色素瘤 2.4%、肺腺癌 4.3%、肺鳞癌 5.0%、胰腺 9.8%、肾乳头状 12.7%) | — |
| 单个肿瘤,逐样本实际用的两计数比(7555 例可算) | 中位 68.8%(四分位 53%–83%) | 21.3% / 1.6% |
| 单个肿瘤,若改算四格 HBMR(6280 例可算) | 中位 86.2%(四分位 73%–95%) | 7.8% / 0.7% |
两行差得这么远,本身就是提醒:换掉统计量,"单样本能查出多少"这个标题数字会实质改变,所以引用这类数字必须写明是哪一个比值。两个数也都还不是真实的检出限——期望模型自身的不确定性、低计数与检测误差都没有处理。
还有一个更根本的界线要划清:80% 功效下的最小可检出效应,说的是"若真实耗竭有这么大,我有八成机会看到它",它不是"没看到,所以真实耗竭小于这个幅度"。后者是置信上界,要对观测数据另做区间估计或等效性检验,还得处理背景模型的偏差。本篇不给这个上界。
在这两条限定之下,能说的是:同一句"没有检测到新抗原耗竭",在癌种汇总层面还能约束到百分之几的量级,在单个肿瘤层面则几乎不含信息。反过来,任何"这个肿瘤显示免疫编辑"的单样本结论,都需要先说明它的突变数够不够。
四、能定位免疫压力的是逃逸事件本身,以及它在时间与空间上的位置
统计痕迹读不出来,直接看逃逸事件就清楚得多。
肺癌(主案例)。 TRACERx 对 88 例未经治疗的早期非小细胞肺癌做了 258 个区域的分析(s2):抗原提呈通路的破坏——HLA 杂合性丢失、影响 MHC 稳定性、增强体或肽段生成的突变——见于 56% 的肺腺癌与 78% 的肺鳞癌(这里的"增强体"指的是参与抗原提呈调控的转录复合体,不是一般意义上的增强子);43/88 例有一个以上"历史上属于干系"的新抗原被亚克隆的拷贝数事件丢掉(各例占其干系新抗原的 0–42%)。更关键的是它按免疫浸润把肿瘤分开:浸润稀疏的肿瘤显示的是历史编辑,编辑强度随演化推进而衰减;浸润高的区域显示的是仍在进行的编辑,要么有 HLA 杂合性丢失,要么表达出来的新抗原被压低(含启动子高甲基化这一表观途径)。
结直肠癌(对照)。 EPICC 用 29 例结直肠癌的 495 个单腺体多组学样本加 82 个显微活检(s3):干系免疫逃逸突变见于 8/29 例,其中 3 例在系统发育树的不相交分支上各自出现 HLA 改变(平行演化,指向强选择);B2M 突变 4 例全部是干系的,HLA 杂合性丢失在 5 例中有 4 例是干系或近干系。腺瘤阶段几乎没有逃逸突变,且腺瘤的比例新抗原负荷显著低于癌。要注意这些腺瘤并不是所比较的那些癌的祖先(原文明确说明),所以这是阶段之间的横断面比较,支持作者"逃逸发生在癌形成之初"的推断,但不是直接观察到某个腺瘤走向癌时的逃逸时刻。而"正在进行"的编辑被定位到了空间上:只有侵袭边缘的样本显示高免疫原性新抗原的变异等位频率被压低(KS 检验 p=6×10⁻⁴),且集中在 0.05<VAF<0.1 的小亚克隆上(原文按其取样与分析尺度把这一档估成约一百个细胞;变异等位频率不直接等于细胞数,这个换算随取样体积与纯度而变);肿瘤表层与淋巴结转移灶都看不到。同一篇还报告,新抗原负荷的变异绝大部分由患者个体与病程阶段解释,取样部位的贡献可忽略;亚克隆逃逸对编辑强度"至多只有轻微影响"。
把两篇放在一起,共同点其实比"图景一致"要弱:免疫选择在时间、空间与机制上都是不均匀的。两篇各自的结论要按各自的人群与分层保留——TRACERx 区分的是浸润稀疏者的历史编辑(强度随演化衰减)与浸润较高区域仍在进行的编辑,并讨论了较强的免疫选择与多条逃逸路线;EPICC 在它那批结直肠癌里推断逃逸多在早期,并把持续编辑的信号定位到侵袭边缘。后者不能替前者裁定晚期选择有多强。
所以"整块肿瘤的耗竭信号测的是一个早已基本停止的过程"只是对某些观测的一种解释,不是统一答案:有限的检测能力、非遗传的逃逸方式、以及不同的背景模型,都还是竞争解释。也不能预设把同一套 VAF 分层搬到肺癌上必然得到结直肠癌的同一方向。
五、干系与亚克隆两个读数能读出什么:要分三段说
上一节的"早期逃逸"结论来自把突变按干系/亚克隆分层。这种分层能给多少信息?可以精确回答——但答案不是"一概读不出",而是按逃逸时点分成三段。
把免疫选择写成:以强度 $\sigma$(每单位时间被移除的带新抗原谱系比例)持续起作用,直到逃逸事件发生后停止。记 $\tau$ 为逃逸发生的相对时点,定义域 $\tau\ge0$,观察窗口为 $[0,2]$:$[0,1]$ 是干系阶段,$\tau=1$ 就是最近共同祖先,$[1,2]$ 是亚克隆阶段($\tau<0$ 会让下式给出 $r_c>1$,不在定义域内)。两个观测量是
于是分三段:
- $\tau\le1$(逃逸在最近共同祖先之前):只定得出乘积。 这时 $r_s=1$,而 $r_c=1-\sigma\tau$。$(\sigma,\tau)=(0.1,\,1.0)$、$(0.2,\,0.5)$、$(0.4,\,0.25)$ 给出完全相同的一对读数 $(0.9,\,1.0)$。EPICC 观察到的"逃逸多为干系事件"正落在这一段,所以那份数据能说"逃逸早",不能说"早期的免疫压力有多强"。
- $1<\tau<2$(逃逸落在亚克隆阶段之内):两个参数反而可以唯一反解。 这时 $r_c=1-\sigma$、$r_s=1-\sigma(\tau-1)$,直接得 $\sigma=1-r_c$、$\tau=1+(1-r_s)/(1-r_c)$,雅可比行列式等于 $\sigma$,只要 $\sigma>0$ 就不退化。脚本里用 $(0.2,1.5)$、$(0.35,1.2)$、$(0.05,1.9)$ 三组核过,反解逐位回到原参数。
- $\tau\ge2$(整个观察窗里都在受选择):只定得出强度。 这时 $r_c=r_s=1-\sigma$,落在对角线上,逃逸时点读不出来。
$(1,1)$ 这一点只对应 $\sigma=0$ 或 $\tau=0$,即"从未被选择"或"选择还没开始就逃逸",它不代表"逃逸在最近共同祖先之前"这一整段。所以不能笼统说这套分层"精确不可辨识":读不出什么,取决于逃逸落在哪一段,而这一段本身正是要推断的东西——这才是它真正的难处。
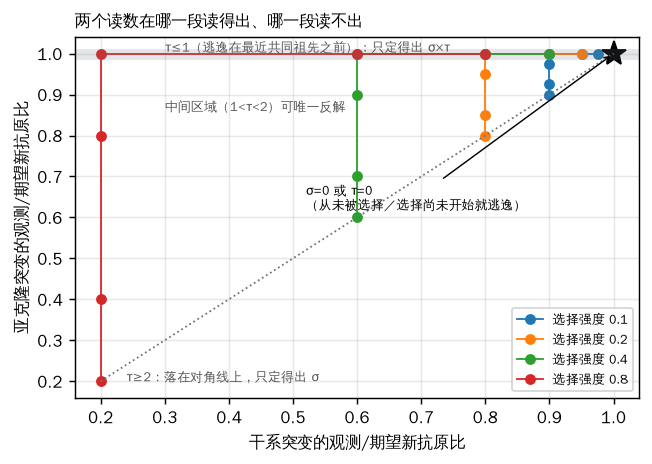
分辨力也能算:要把干系读数 0.90 与 1.00 分开(80% 功效、双侧 0.05),需要约 785 个可评估的新抗原;0.95 与 1.00 需要约 3140 个。典型的非超突变实体瘤远达不到这个量级,这是把期望当已知的单Poisson计数示意,与第三节比值统计量的标准误不同,不能互换数字。
六、浸润数量不等于清除能力
最后一条边界。上面两篇都把免疫浸润当作分层变量,但浸润本身是个模糊读数:
- EPICC 的多重免疫成像显示,侵袭边缘的浸润淋巴细胞比例更高,但那里 PD-L1 阳性肿瘤细胞的比例也显著更高,且 PD-L1 阳性细胞离细胞毒 T 细胞更近——浸润与抑制是同时上升的;在肿瘤表层,PD-L1 阳性细胞与 PD-1 阳性细胞往往相互排斥,在边缘则均匀混合。
- 同一篇发现"部分逃逸"的癌里 PD-1、VISTA、CD163 阳性细胞富集,而细胞毒 T 细胞与调节性 T 细胞的数量在逃逸与非逃逸之间没有差别。
所以"免疫热"与"免疫冷"这一对标签,同时混着识别、进入与清除三件事;用它做分层是有用的操作定义,但把它读成"免疫压力大小"会出错。这也是本专题反复出现的同一个毛病:一个综合读数被当成了某个具体机制的度量。
七、边界、反例与可以检查的预期
本篇没有证明的:
- 第二、三节全部基于 van den Eynden 2019 公布的汇总表,本篇没有重新做 HLA 分型、结合预测或突变模拟;如果那套模拟本身有系统偏差,本篇的重算会一同继承。第二节里五个癌种显著高于 1、合并值 1.044 也高于 1、异质性极强,与"该模型仍有残余偏差"相容,但也与别的选择过程或取样差异相容——本篇没有做误差校准,无法在这些解释之间裁决;因此只把它当作"这条路给不出可靠的耗竭估计"的证据,不把校正后的数值当作真实耗竭量,也不宣称偏离已被唯一归因。
- 功效计算用的是对数比的正态近似,把各类计数当作独立;真实数据里同一基因的多个位点并不独立,本篇没有评估这种相关结构会把实际功效推向哪一边,也没有把期望模型自身的误差计入。两个功效数字都是"最小可检出效应",不是阴性结果的置信上界。
- 第五节的模型把选择写成"匀速移除、逃逸后完全停止",真实过程既非匀速也非全有全无;该节能成立的是分区结论($\tau\le1$ 只给乘积、$1<\tau<2$ 可反解、$\tau\ge2$ 只给强度),不是任何具体数值,也不是"这套分层一概不可辨识"。
- TRACERx 与 EPICC 的所有数字按原文引用,本篇没有复算其中任何一项,也没有取得两者的原始测序数据。
- 本篇不评价任何免疫治疗方案,不构成治疗建议。健康议题按本库规矩只作研究。
被数据修正的预期: 开题时我预计按组成校正后仍会有相当一批癌种显示显著耗竭,只是幅度变小。实测是 19 个癌种里只有 2 个显著低于 1,却有 5 个显著高于 1;后者不符合单纯负选择耗竭的方向。按实测把结论改成"校正后的残余偏离不能唯一归于免疫耗竭,背景模型和其他选择仍需区分",不只挑低于 1 的那两个说。
可以检查的预期:
- EPICC 在它那批结直肠癌的侵袭边缘看到耗竭信号集中在最小的亚克隆里(VAF 0.05–0.1)。把同样的分层搬到 TRACERx 的肺癌多区域数据上是一个值得做的检验,但本篇不预言方向:TRACERx 自己报告的是浸润较高区域仍在进行的编辑,肺癌与结直肠癌在免疫背景、突变负荷与逃逸路线上都不同,得到相反的分布同样是可解释的结果。要紧的是把分层做出来并报告,而不是先假定两者一致。
- 第三节的功效表给出一个可直接使用的判据:任何一篇报告"某肿瘤有/无免疫编辑"的研究,都应当同时报告该样本的最小可检出耗竭幅度;按本篇的分布,绝大多数单样本结论应当落在"无法判定"里。
- 若浸润与抑制确实同时上升,则在同一批样本里,浸润淋巴细胞密度与抑制性标记密度应当正相关。至于两者相除的比值是否比单个密度更能预测编辑信号,本篇不作预言——那要看两者各自的噪声与它们和编辑的关系形状,没有验证之前不该写成性能保证。
- 要真正测"当下的免疫压力",需要的是 T94 那种设计的免疫版本:把同一个肿瘤的细胞分到有免疫与无免疫的两套受体里各自扩增,看两边胜出的谱系是否相同。目前的多区域测序做不到这件事。