旧功能丢了,先确认它本来能不能留下
一个电阻网络学会让指定输出接近目标电压,接着换一个任务继续调整导度。新任务变准,旧任务却变差:同一批电阻既是功能的载体,也是下一次学习要改动的对象。
但这至少有两种起点。如果同一输入在同一状态下既被要求输出1,又被要求输出0,两个答案不能同时成立;需要任务提示、不同读出或额外状态。若任务作用于不同端口,且存在一组导度能同时满足它们,遗忘才可能是更新路径没有保护已有功能。
两条原始研究恰好提供这两类入口。Ibrahim的2026年发表研究,用自动微分训练电阻网络,明确采用同输入、相反目标,讨论遗忘与适应的取舍。Chatterjee等的2025年预印本在不同端口训练多个任务,以局部更新阈值减少相互干扰。12 两者的任务、学习规则和证据性质不同,不能把一句“减少遗忘”直接横向排名。
同输入相反标签,有一个结构无关的取舍
先看Ibrahim研究的两个边界输入节点、一个输出节点模型。固定导度时,电阻平衡对边界电压线性。若两个输入同时处于1,所有自由节点也处于1。因此输出必可写为
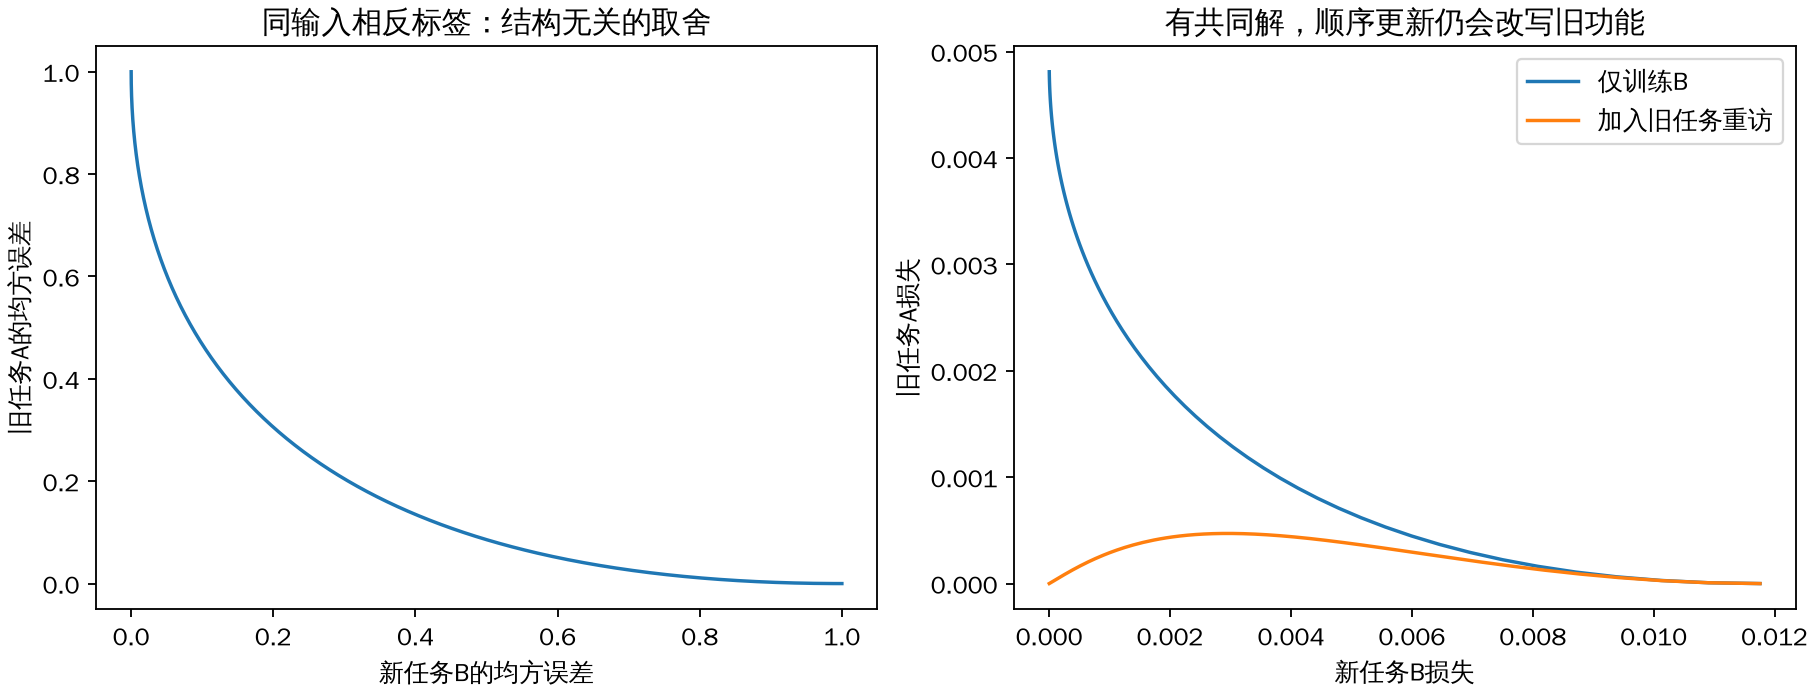
正导度连通网络给出内部电压的加权平均;常见两端均能接达的情形有$0<q<1$。任务A要求$(1,0)\mapsto1,(0,1)\mapsto0$;任务B完全反过来。按原文两个样本的均方误差,
所以每一个确定网络状态都满足
在这个模型和损失定义内,固定新任务误差,也就固定了旧任务的最终误差。改拓扑、加锚定或停止训练可以改变走到曲线哪一点、需要多少更新,却不能让同一状态离开这条关系。原文的遗忘量$F=L_A^{\rm after}-L_A^{\rm before}$还取决于旧任务起初学到多好;跨网络比较应同时匹配这一项。
这是有限条件下的精确结论。加入任务提示、时间记忆、额外输出或不同输入分布后,任务定义改变,不能继续套用该曲线。即使只学任务A,有限正导度及元件范围也可能使$q=1$只能逼近,不能把残差都归于遗忘。
原文还抽样连续目标$(y_1,y_2)$。在上述两边界模型中,最优$q=(1+y_1-y_2)/2$,对$y_1,y_2\in[0,1]$,在允许自由选择$q$的响应类中,单任务最低均方误差为
特定拓扑和导度范围还可抬高这一最低值。因此,随机标签本身也可能包含不能由该响应类消除的分量。研究任务冲突时,先核可实现性,比只按目标差异或梯度夹角分类更清楚。
原作者代码确实发生了什么
本库取得发表11页全文及固定提交7895b268f81815182b462769eff0229aaac31429的作者仓库,实际读图拉普拉斯、Dirichlet求解、softplus正导度、任务、梯度与锚定实现,并原样执行baseline1.py。13
这次代码基线为40节点、123边,每项任务300步、学习率0.1。任务A训练后$L_A=0.0920052$;再训练B后,$L_A=0.3432719$、$L_B=0.1714837$,遗忘量0.2512667。本库另用双精度Kirchhoff求解与解析导数完成同样600步,七项汇总数最大绝对差约$5.8\times10^{-8}$,抽查解析梯度与有限差分差约$4.0\times10^{-11}$。4
这些数字复核的是当前固定代码基线;发表表I展示另一组代表运行,不称本次精确重现表I或全部拓扑统计。代码从全网络线性求解得到自动微分梯度,属于数值训练;论文讨论的物理解释有明确电阻载体,但本次运行没有实现自主局部硬件。
发表研究观察到较强锚定通常降低遗忘,同时增加新任务误差;它也要求联合解释这两项。本篇上面的单参数关系进一步说明,在这个最小相反标签模型中,“旧任务更好”不能独自证明保护机制在相同新表现下更优。
换成确有共同解的电路
本库构造四节点、五导度网络。输入节点电压固定为1和0;输出为$a,b$。$g_1,g_2$分别把$a$接向两个输入,$g_3,g_4$同样连接$b$,$g_5$连接两个输出。电流平衡为
任务A只要求$V_a=0.625$,任务B只要求$V_b=0.375$。取
即可同时达到两项。因此,这一次不需要用“目标本来矛盾”解释遗忘。两项任务没有新增提示或切换参数;共同解位于全体方案共享的导度范围$[0.1,4]$内。
本库从30组固定随机初始导度出发,先把A的半平方损失压到$10^{-12}$以下,再只训练B。后段统一学习率0.5、最多10000步;主要比较点是B的半平方损失恰好达到$10^{-6}$,最后一步用连续插值定位该点。全部参数、历史、停止标准及结果留存。4
没有保护时,B都能到达门槛,但A的损失中位数升到约0.006086。共同解存在,并不保证只沿B的下降方向走就会留在A的解集合上。
干扰由哪些物理变化传过去
设$J_A=\partial V_a/\partial g$,一次导度改动为$\delta g$,旧响应的变化首先由
决定。即使A已经精确学会,$\nabla L_A$接近零,$J_A$也通常不为零。从精确旧解出发,旧损失的领先变化约为$\tfrac12(J_A\delta g)^2$。因此,旧任务梯度几乎消失时,两个损失梯度的余弦不再是可靠的完整保护指标。
电阻网络中,输出对某条导度的灵敏度包含两个因子:该边的实际电压降,以及从读出节点传播回来的伴随电压降。高电流常与大改动相关,但电流单独不能给出旧功能重要性。例如,在两个固定输入端之间直接接一条电阻,它可以载流并耗散,却不改变固定边界下的输出电压;那条边的输出灵敏度为零。
对本例,连接两个输出的$g_5$让改写B可以传到A。若移除该边并只调各自的四条支路,两输出解耦,B的参数改动便不会改A。这是可检查的边界,不意味着一般网络越模块化越好:拆得太开也可能失去所需功能或共享资源优势。
阈值减少了多少干扰,又挡住多少新学习
Chatterjee等采用两物理状态的局部信号,只更新超过阈值的边;其模拟在不同端口任务与足够多可调边的条件下,显示较少更新和更好的联合保持。原文也写明阈值过高会妨碍单任务学习。2
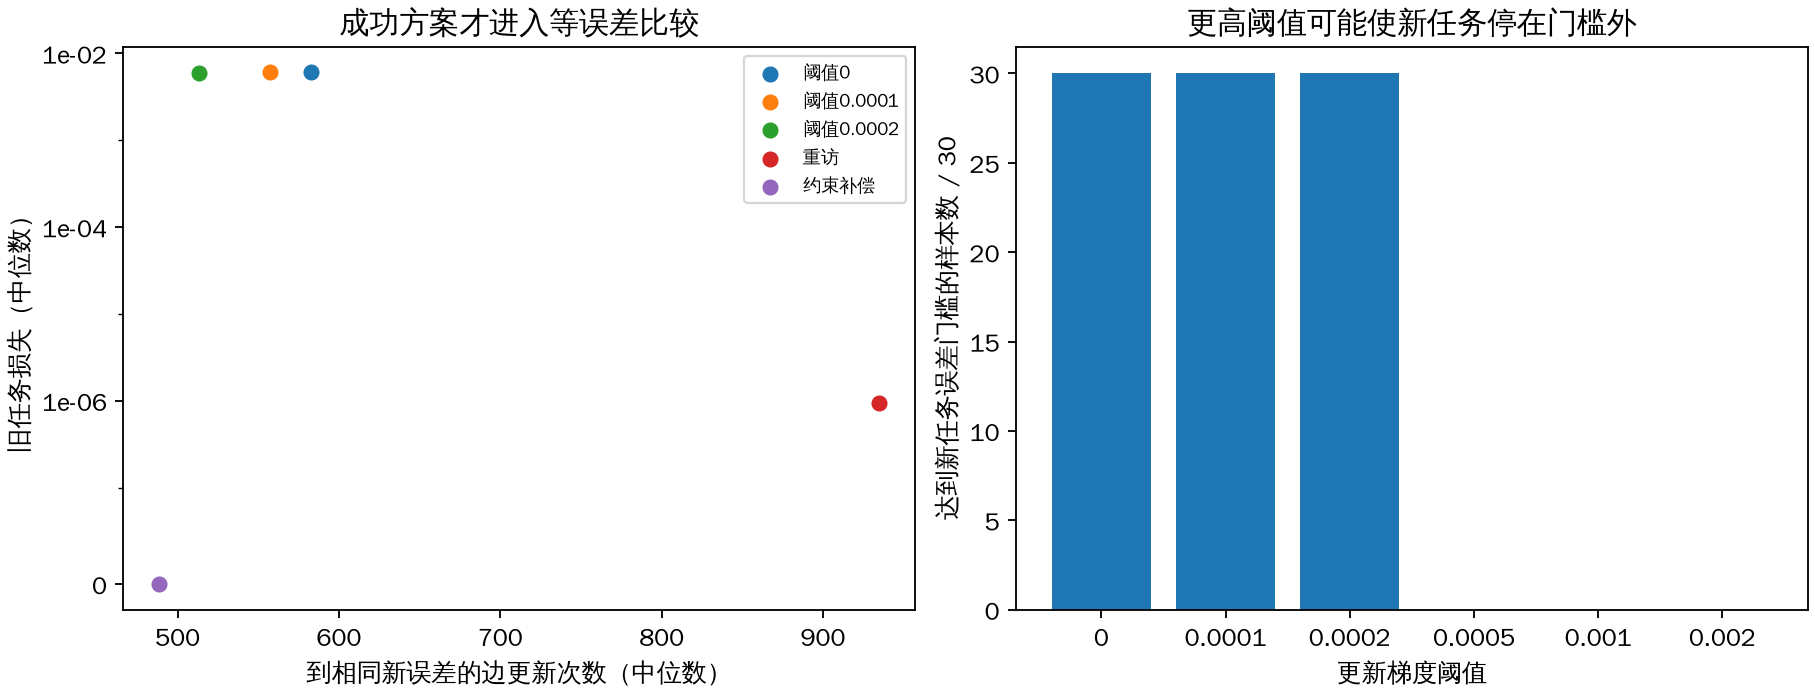
本库在上面的小电路中,先用可独立核对的解析导度梯度设置阈值。所有方案使用相同任务、初态、元件范围和新误差门槛。结果如下,数字为30组初态的中位数:
| 更新方案 | 到达B门槛 | 同B误差时A损失 | 边更新次数 |
|---|---|---|---|
| 无阈值 | 30/30 | 0.006086 | 582.5 |
| 阈值0.0001 | 30/30 | 0.006075 | 557 |
| 阈值0.0002 | 30/30 | 0.006035 | 513 |
| 阈值0.0005 | 0/30 | 不进入等误差比较 | 428,停滞时 |
阈值0.0002相对无阈值,边更新次数约少12%,旧损失只约少0.8%。更高阈值0.0005虽然让旧改动进一步减少,却使B最终损失中位数停在约$2.20\times10^{-6}$。不能把这一组的较低遗忘,直接算成相同新功能下的保护收益。
30组初态只测试这个固定拓扑和目标,不是跨材料普遍统计。它没有否定原大网络的空间分隔结果;它说明阈值能否形成有用的功能分隔,需要在具体物理敏感通路上验证,不能只凭“改的边少了”。
局部信号、重访与精确保护,各自需要什么
原阈值预印本的局部信号来自自由与弱钳位状态的边电压降平方差。对本例,令弱钳位幅度为$\eta$,本库解析梯度与实际两状态求解给出
其中$G_{bb}>0$是自由节点电导矩阵逆的输出对角元,即电阻Dirichlet算子的相应顺应度。四个递减$\eta$实际核对了这一极限。原文学习率还吸收因子2;本例用此式解释方向与归一化,不把数学记号相同当作数值阈值可直接互换。
再比较两种更直接的保护。重访每步也读取旧输出,将A和B损失梯度相加。同样到达B门槛时,A损失中位数约$9.48\times10^{-7}$;但需要约187次额外旧任务读取、935次边更新,均高于只学B。
约束补偿保留旧目标$V_a=0.625$,改变B支路后,根据电流平衡补偿$g_1$:
这项本库设计的协议使旧约束保持在数值精度内,同时达到相同B门槛;边更新次数中位数约488.5,包括起始时的一次精确旧约束校正。它也保留了旧目标,并使用特定电路方程及跨支路补偿,不能叫作无额外记忆的通用局部规则。
这两项对照不是同资源算法优劣排名。它们回答的是:旧任务保留可以通过哪些明确资源实现。若要求相同总读取次数、保存量、更新次数和元件数,应重新分配预算后再比较;目前足以说明只看最终旧误差会漏掉什么。
更新成本不等于整机能耗
阈值预印本以每次边更新固定消耗$\epsilon$为假设,估计更新能量,并以“训练步数乘曾更新过的边数”给出上界。其相关统计还筛选了两项任务均成功学习的样本;这不同于全体样本的无条件平均,也不等于物理求解、检测阈值、保存或控制的完整能耗。2
本库表中直接数了实际边更新次数。若采用同一固定单次代价假设,它可以折算调参成本;没有测电路读出功耗、控制器、写入幅度相关损耗或元件寿命,故不把少12%的边更新写成整机省电12%。
怎样证明保护保住了有用的旧功能
一个有说服力的比较,需要先展示新旧任务的共同可实现性,再匹配旧任务初始质量;训练B后,同时检查B的适应、A的保持、共同任务容量与额外资源。共同解可能只是存在,实际局部规则也可能到不了;少改参数可能保留旧功能,也可能只是冻结了学习。
在本篇已有证据中,原作者代码与独立求解确认了矛盾目标下的覆盖过程;精确误差关系解释它的不可消除取舍。另一个确有共同解的小电路,则把遗忘定位到顺序改写的物理响应方向。适度阈值减少更新但保护有限,重访和约束补偿确能显著保留旧功能,同时付出旧信息与控制成本。
尚未解决的是:在大型、带噪声、局部更新的真实装置里,哪些端口布局和参数余量能让阈值形成稳定的功能分隔;这种分隔能支持多少连续任务,又需要多少读写与保存。它们是后续可检验的问题,不能由一条遗忘曲线先行回答。