一项检查容易,不保证所有检查容易
假如每项检查只碰六个元件,每个元件也只参加少数检查,检查数量随系统规模增长得并不快。可是,六个参与者可能分散在不同位置;多项检查可能争用同一条通路;辅助元件发生一次错误,还可能沿后续门传播到多个数据元件。保护网络的难点因此不只在“每项有多大”。
量子低密度奇偶校验码,简称qLDPC,要求校验重量和每个物理比特参加的校验数都有不随规模增长的上界。这个条件限制抽象图的度数,没有直接限制图嵌入二维装置后的连线长度、每轮持续时间或故障传播。旋转表面码本身也属于稀疏校验码;比较的不是“稀疏与不稀疏”,而是不同稀疏结构怎样兑现保护。13
本篇先核一个小码的真实代数参数,再把同一个检查过程分别放到直接连接与邻近路由上。最后用逐故障传播检查:多出来的门只是资源增加,还是连可纠正错误的结构也变了。
先确认它真是一个量子码
选一个三行五列的二元经典校验矩阵,所有加法在模2意义下进行:
它是开放边界La-cross构造的一个自选小实例,种子偏移为$0,1,2$。本库没有声称复现作者某个已报告的仿真点。按超图积构造,取
两项乘积中的相同部分在模2下抵消,得到
这保证所有$X$型与$Z$型检查对易,能够共同约束一个量子编码空间。稀疏的任意二元矩阵没有自动满足这个条件。3
本库实际计算出:34个数据比特,两族检查的秩各为15,承载$34-15-15=4$个逻辑比特;最大检查重量为6,每个数据比特至多参加6项检查。穷尽重量1、2的纯$X$与纯$Z$图样,均没有非平凡逻辑操作;重量3找到显式逻辑代表,例如
这里从0开始编号。对CSS码,任何混合Pauli逻辑操作至少有一个非平凡的纯$X$或纯$Z$部分,重量不超过它自身,因此这也排除了重量小于3的混合逻辑操作。结合重量3代表,码距确为3。重量3只搜索到第一个代表,未冒称穷尽所有三错误图样。
原始超图积定理给出的更一般条件也已核:相同满行秩经典种子$[n,k,d]$可得到$N=n^2+(n-k)^2$、$K=k^2$、距离$d$的量子码。转置码只含零码字时,距离取无穷大的约定须同时使用;本篇有限实例仍独立枚举,不仅套用下界。3
四个逻辑比特,究竟省了什么
把该实例按经典Tanner图的笛卡尔积布置:经典数据位置为$0,2,4,6,7$,经典检查位置为$1,3,5$。量子数据位于数据×数据及检查×检查的位置,辅助比特位于另外两类交叉位置。总共占据$8\times8=64$个格点,其中34个数据、30个检查辅助,每项检查各用一个辅助比特。
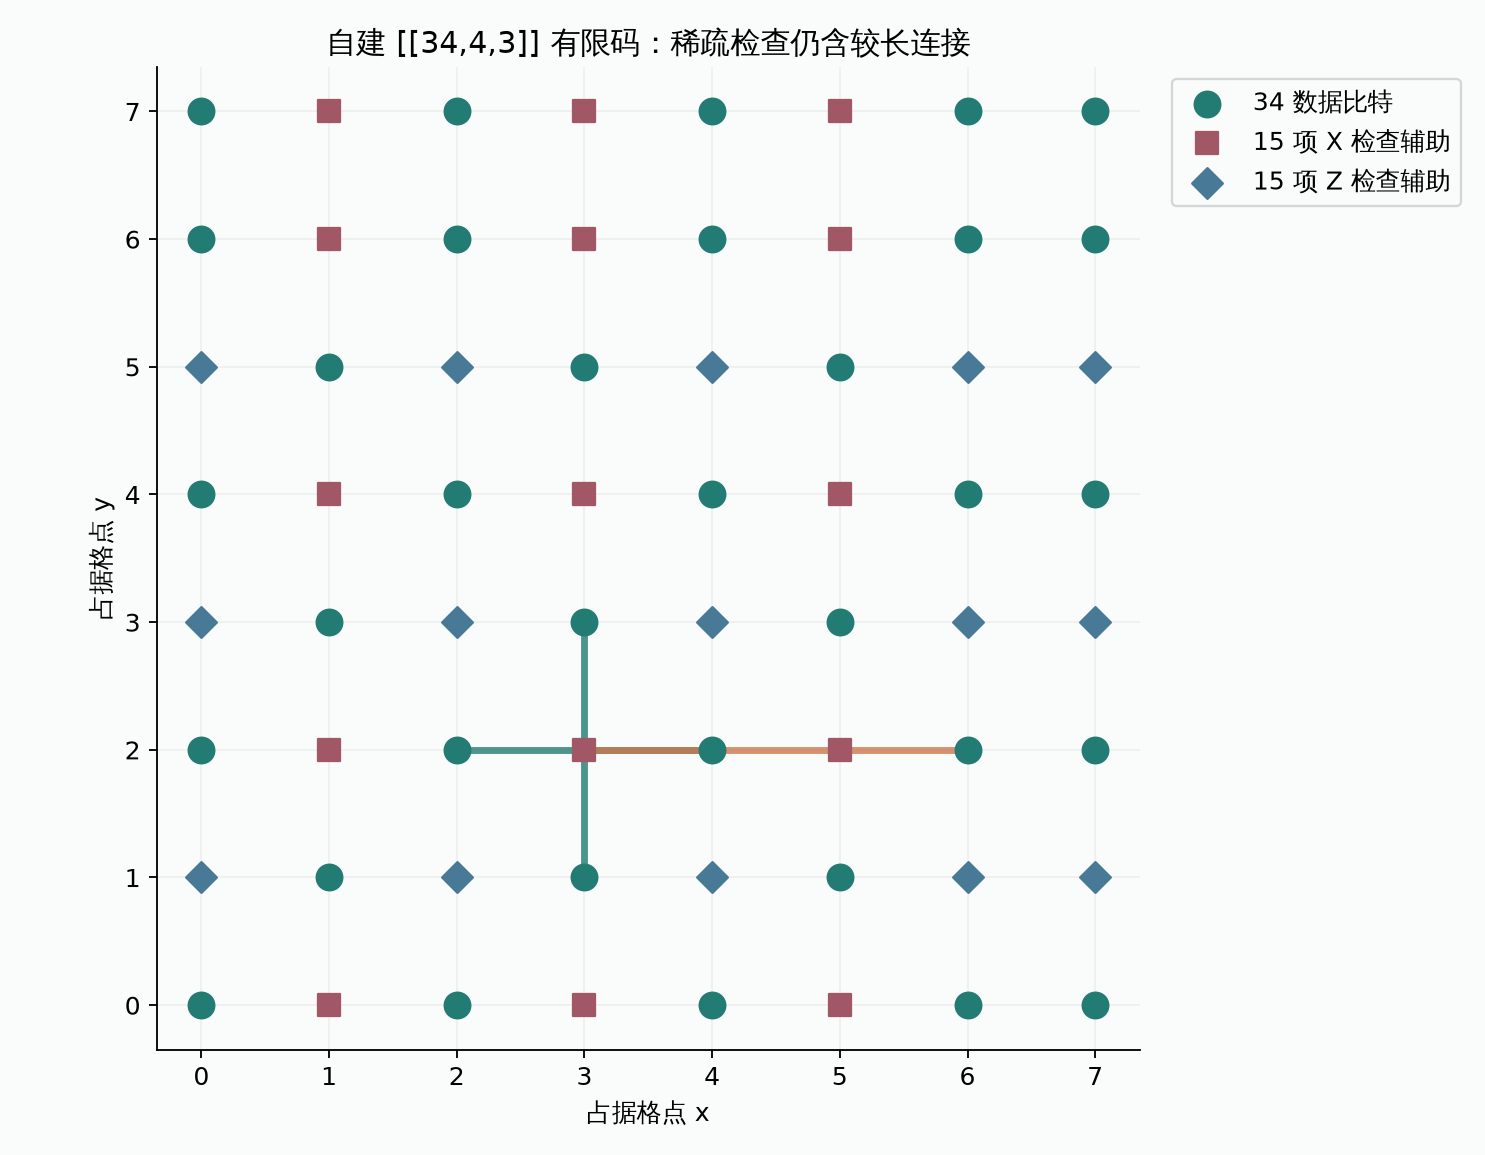
所有检查合计144次辅助—数据相互作用,曼哈顿长度1、2、3分别有96、16、32次。每项检查最多六个参与者,仍有48次相互作用跨过中间占据位置。
合适的紧凑基线是四份T36的九数据比特旋转表面码:同样保存四个未知逻辑比特,码距同为3。本库重新核其检查、坐标与实际电路。每份需九个数据、八个检查辅助,合计36个数据、32个辅助、96次检查相互作用。
| 同一四逻辑比特、距离3任务 | La-cross小实例 | 四份旋转表面码 |
|---|---|---|
| 数据比特 | 34 | 36 |
| 检查辅助比特 | 30 | 32 |
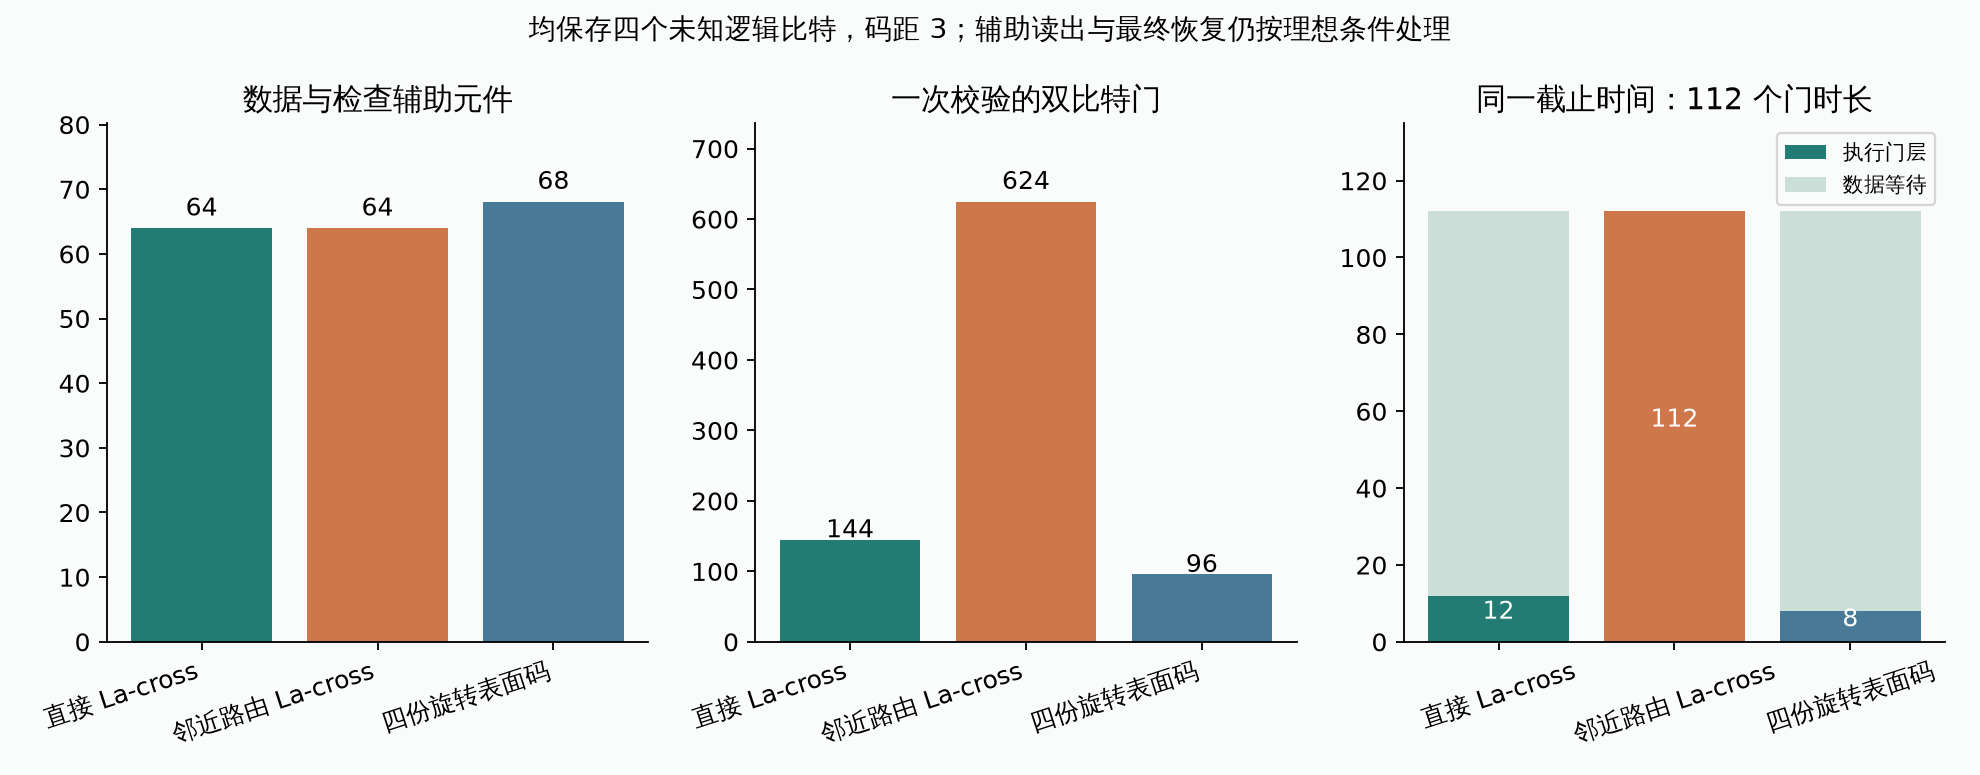
| 两者合计 | 64 | 68 |
| 一次检查过程的双比特门,原生直接连接 | 144 | 96 |
小实例在这个基线上少四个元件,却多48次检查门。不能仅挑更大的非旋转表面码作对照,就把“元件较少”写成普遍结论。两种绘图格距也不直接代表同一面积预算;这里匹配逻辑任务和元件计数,不宣称芯片面积已匹配。
论文标题中的high-rate也不等于这个La-cross族具有正的渐近码率:固定$k$时,$K=k^2$固定,而$N$增长,$K/N$趋于零。其有限规模收益与一般超图积使用良好经典码时的正渐近码率,是不同陈述。13
排得下的门,还要测对目标
构造一个保守且可核的检查电路:所有$X$辅助先准备为$|+\rangle$,所有$Z$辅助为$|0\rangle$;先完成全部$X$检查,再完成全部$Z$检查。$X$检查使用辅助控制、数据为靶的CNOT;$Z$检查相反;最后分别沿$X$、$Z$读辅助。
La-cross每族按种子三种偏移及两类数据位置分为六组互不争用端点的门,合计12个双比特门层。旋转表面码每族四组,合计八层;$X$、$Z$采用不同空间次序,防止把辅助错误链排到对应逻辑方向上。代码保存全部分组、门次序和坐标。
本库把每个最终辅助测量算符沿实际电路倒推,核它等于目标数据稳定子乘上初始已知的辅助算符。还核直接与路由电路对所有单比特Pauli生成元的理想映射相同。这一步能区分“资源不冲突”与“真的测到了目标检查”。最大度数给出的图着色条件本身不代替这种验证。
这不是论文的十层方案。论文并行交错两族的四个近邻门,再顺序完成四个远程步骤,另计准备与测量;其补充材料的错误链分析依赖开放边界和特定门序。本文十二层只计自选两族分开的双比特门;两种层数不能直接当同口径硬件速度比较。12
当直接连接改成邻近移动
对长为$\ell$的路径,本库将CNOT控制比特移动至靶旁边,执行门,再沿原路返回。中间格点已经被数据或辅助占据,使用SWAP移动它们的状态;每个SWAP按三个邻近CNOT分解。一次原始门因此变成
个邻近双比特门。完整实例增加160个SWAP,门数成为624。路由按同一原生分组次序进行,组内再分成路径互不相交的小组;构造得到112层。它是明确可执行的构造,没有证明路由最优,也没有穷举所有布局。
为匹配时间,设每个原生门或邻近CNOT持续一个自选单位$\tau$,三种方案均在$T=112\tau$交出数据。较快电路读出辅助后,数据继续等待;已读出的辅助不再承担等待存储噪声。准备、读出、复位和最终恢复仍按理想瞬时操作处理。
| 自选执行方案 | 双比特门 | 执行门层 | 之后数据等待步 | 全部闲置元件×时间步 |
|---|---|---|---|---|
| 直接La-cross | 144 | 12 | 100 | 3,880 |
| 邻近路由La-cross | 624 | 112 | 0 | 5,920 |
| 四份旋转表面码 | 96 | 8 | 104 | 4,096 |
最后一列同时计门执行中的闲置和补齐截止时间的数据等待。它不是门层数乘以数据数,也不是焦耳数。原生长程门与近邻门等时长是一项对照假设;论文自己的Rydberg估计中脉冲时长还随距离变化,不能把这里的$\tau$直接换成实际微秒。1
理想返回原位,错误不会自动返回原状
理想的正反SWAP恢复了中间状态的位置,但门间发生的错误可能在返回时换了宿主,或经后续CNOT传播。本库为每次双比特门列出15种非恒等双比特Pauli故障,为每个闲置元件时间步列出三种单比特Pauli故障,并真正逐门传播到终点。
检查结束的辅助记录全部保留。在共同截止时刻,再提供一次理想的数据综合征及Pauli恢复,作为共同的诊断条件。这额外一次检查的物理实现没有计成本,故本段并非完整的容错存储装置;它问的是,这些执行故障即使获得最终完美综合征,是否仍有恢复歧义。
直接La-cross、邻近路由、旋转表面码分别枚举13,800、27,120、13,728种单故障;这些数包含补齐截止时间的等待。对每个“辅助记录+最终综合征”,比较数据错误在稳定子乘积下的等价类,选择概率最大的类作恢复。最优性仅限于这个指定Pauli模型和恢复族。
路由中出现一对具体故障:一个留下$X_2X_3$,另一个留下$X_0$;辅助读出记录同为零,最终数据综合征也相同。两者之差正是
前面已经核过的逻辑操作。任何根据这份记录作出的同一个恢复,都不能同时修好两者。单个双比特门故障在物理位置上仍很局部,却不再等价于一个可区分的数据单错误。
这里取每个门以概率$p$均匀发生15种Pauli错误,每个闲置元件每步以概率$\beta p$发生三种单错误。先算独立噪声模型的首阶量
其中$F_e$是保存全部四个未知逻辑比特、含参考系统的纠缠保真度,不是只检查一个基底答案的正确率。在显式“最多发生一次故障”的排他模型中,给各位置分配相同的一阶权重、无故障概率取剩余权重,$F_e=1-Ap$则是完整的Pauli通道结果,所有分支均保留。
| 闲置比率$\beta$ | 直接La-cross的$A$ | 邻近路由的$A$ | 四份旋转表面码的$A$ |
|---|---|---|---|
| 0 | 0 | 1.666667 | 0 |
| 0.001 | 0 | 1.758333 | 0 |
| 0.01 | 0 | 2.000000 | 0 |
| 0.1 | 0 | 2.000000 | 0 |
路由的系数没有一直线性增长,因为恢复决策也会随故障先验改变;等待和门故障可能竞争同一份记录。在$\beta=0.01$时,忽略第一轮辅助记录会把路由系数从2增到4。记录有实际作用,却没有消除上述全部歧义。
**零首阶系数不等于零失效概率,也不足以比较两个直接电路谁更好。**二故障及更高阶尚未计算,重复的含噪检查、实际解码器和最终检查故障也未纳入。若独立模型各位置错误概率之和为$q$,与排他模型的总变差可由$q^2$粗略控制;代码保存这个宽松余项界。示例$p=10^{-6}$用于显示合法排他通道,不当实际器件预测或阈值。
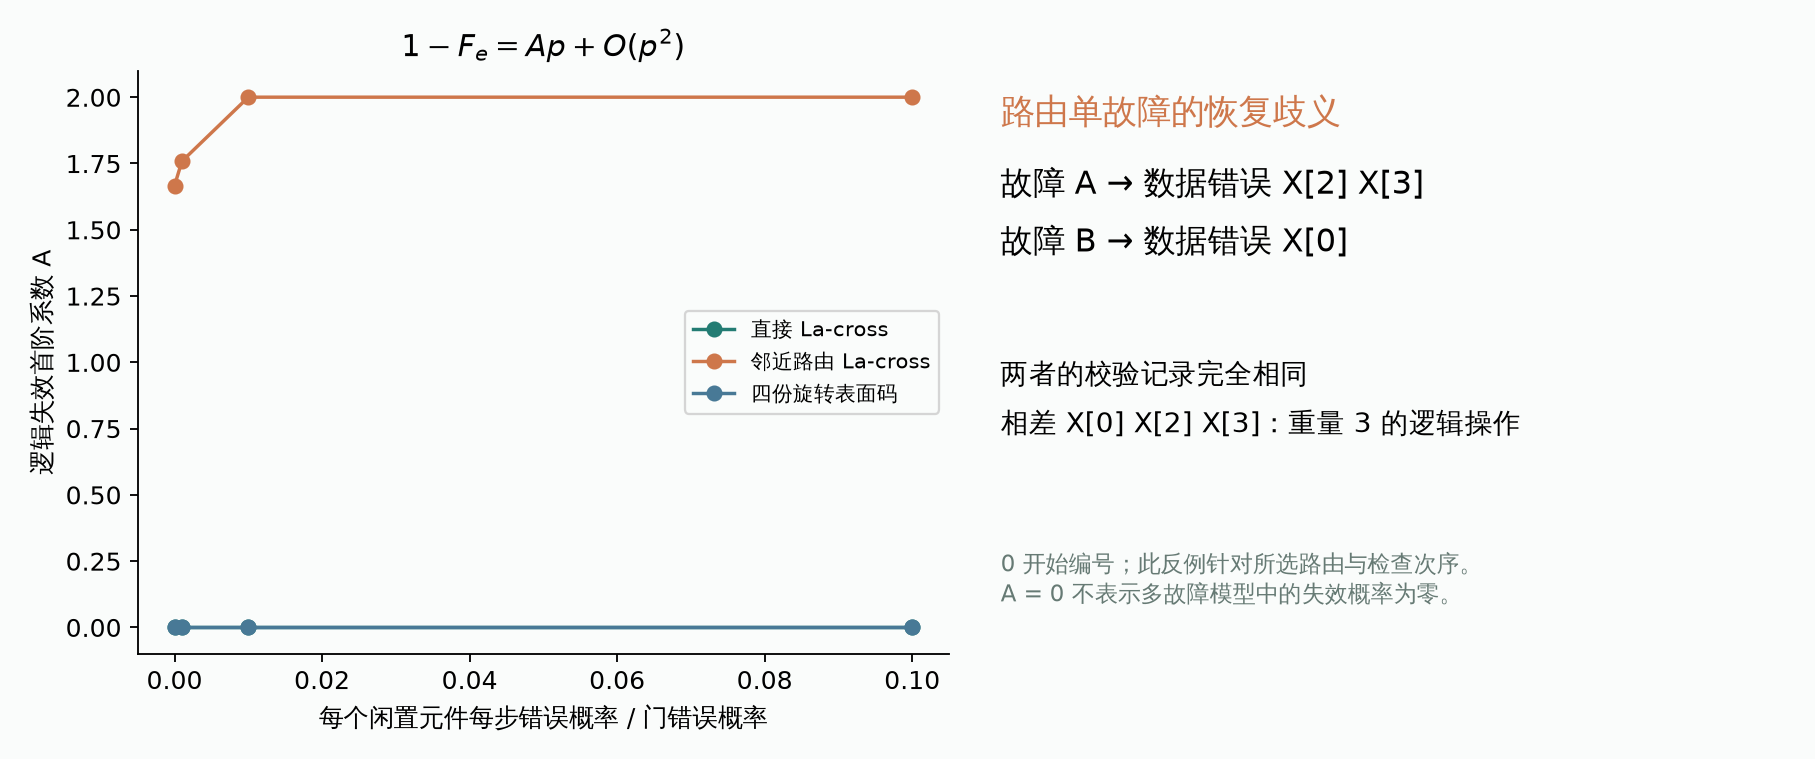
本段支持的结论是:这个具体路由增加了一个原生电路没有的单故障恢复歧义。增加旗标辅助、改变次序、验证中间状态或换路由,都可能改变结果;不能把它提升为“所有邻近实现必定失去保护”。
原论文的优势依赖哪些条件
Pecorari等人的工作是一项理论与电路数值研究,提出在中性原子寄存器中利用原生长程相互作用实现La-cross,并在指定模型下比较表面码。它没有实际制造本文小实例或完整存储器。1
正式方法中的两个噪声口径不同:硬件相关模型采用距离相关双比特门率$p_2(j)=c_jp$、单比特门率$p/10$、准备及测量率$2p$;硬件无关模型采用距离无关双比特门率$p$、单比特率$p$、准备及测量无错。二者都忽略闲置错误。模型同时改变多项条件,不能把性能差全部归因连接长度。
作者做$D$轮检查,用BP+OSD解码,记录多个逻辑比特中任一个失败的累计概率$p_L$,再报告
这是逐轮归一的联合失败指标,不自动等于单逻辑错误率、每秒率或未知态$F_e$。表面码对照采用相同轮数,也不自动匹配长程门及检测的实际秒数。1
本库取得Figshare固定v2存档,核MD5后读取全部六个处理后数据表、404行;按$N,K,D,p$精确匹配得到128组两噪声模型对照,没有重跑Stim或BP+OSD。45
例如$p=0.001$时,存档$[[52,4,4]]$逐轮值为0.001346与0.000365,硬件相关模型约为另一模型的3.69倍;$[[106,16,4]]$则为0.010515与0.001152,约9.13倍。前者四轮累计概率由舍入后的逐轮值反算,分别为0.005373与0.001459。它们说明条件敏感性,不分离各噪声项的独立因果效应,也不是本文电路的数据。
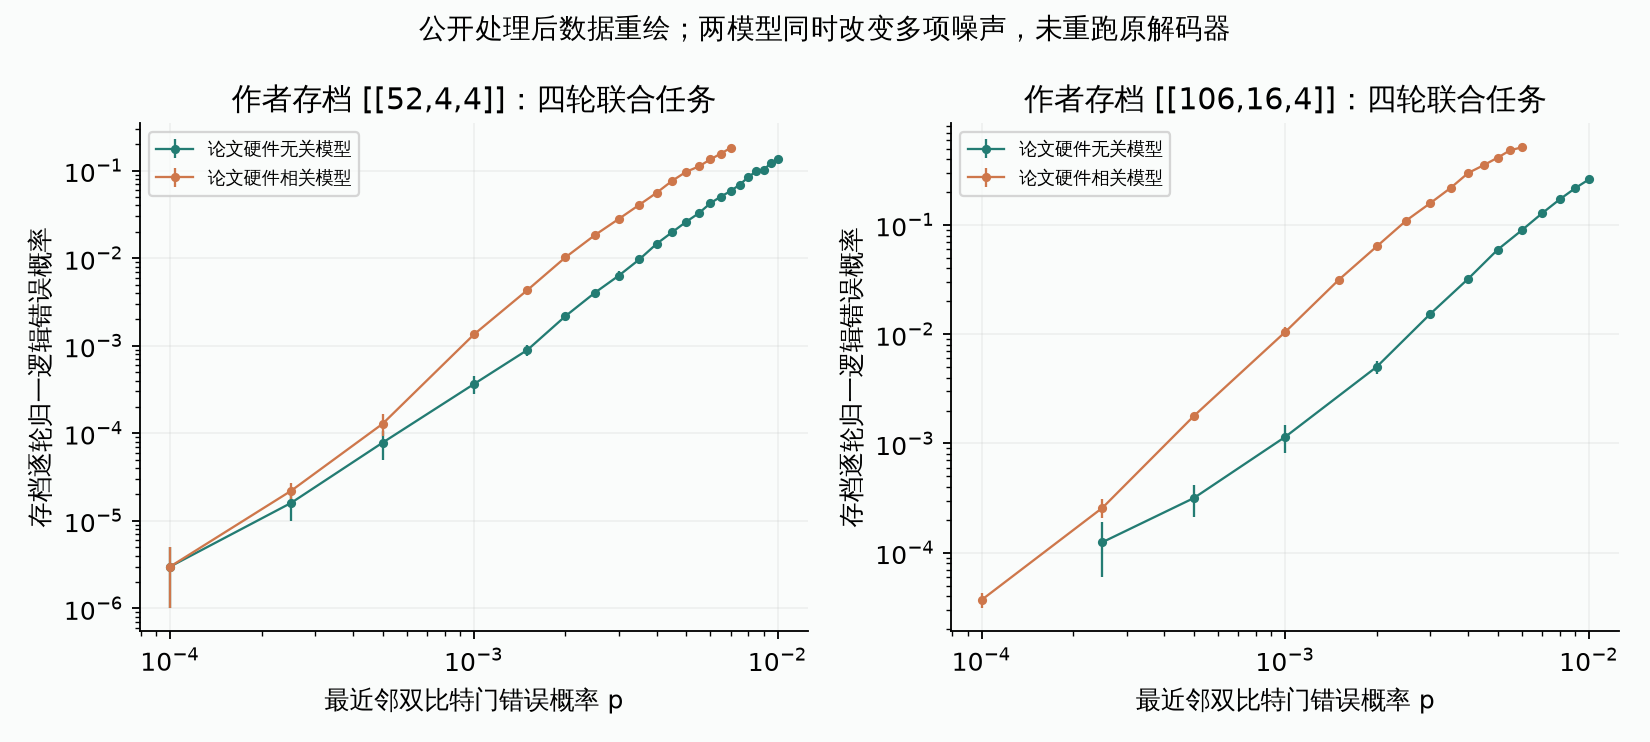
存档还存在一个需保留的边界:$k=3$硬件相关表将最小块标作$[[69,9,4]]$,对应硬件无关表标作$[[65,9,4]]$;69也不满足这里的开放边界$N=n^2+(n-3)^2$整数形式。本库没有擅自修成65,这一块不进入同$N$匹配。该局部标签问题不否定全部模拟,但妨碍这一块的精确对照。误差列被保留,未从它反推不存在的原始shots或自行补出置信定义。
哪些条件会改变保护代价
从抽象码到可用存储,需要分别回答:矩阵是否定义目标逻辑空间;布局是否支持那些连接;门序是否测对检查;噪声传播后是否仍可恢复;在要求的截止时间内用了多少资源。前一项成立不推出后一项。
- 固定码与检查次序,改善原生长程连接,可移除本例的大量SWAP;如果长程误差、串扰或时长随之恶化,收益要重新核。
- 固定路由门数,改变路径与次序,可能改变单故障歧义;门数相同不保证逻辑通道相同。
- 固定执行层数,增大闲置噪声或读出延迟,会改变同截止时间的等待负担;原论文忽略闲置的曲线不能直接外推。
- 增加辅助记录可能改善恢复,却占用元件、门、读出和复位资源;须在同任务预算下再比较。
本文确立了一个有限反例和一套可核账目,没有证明最佳空间嵌入、完整阈值或平台排名。仍未决的是,在多轮、多故障、相关噪声与有限读出条件下,哪种路由或额外辅助能以最低代价保住保护。T138接着研究实际逻辑操作,T140再依据可匹配的结果综合。
可回查的计算范围
库内代码为research/calculations/sparse_check_spatial_cost.py、sparse_check_public_data.py、sparse_check_spatial_cost_figures.py与sparse_check_spatial_cost_audit.py。图由本库生成,未复制论文图片。
可回查:矩阵、坐标与逐层门事件、条件比较、路由排他单故障完整通道及决策、公开表读取范围、404行存档值、科学核验。
核验包括独立二元消元、低重量逻辑搜索、实际测量算符倒推、每条路由门的邻近性、全部生成元的理想映射一致、CSV故障权重、显式故障的前向传播与公开包校验。Codex完成作者自审,不冒充独立审阅;一般定理证明、原作者仿真和器件实验未完整复现。