一次“成功干预”,先需要一个清楚的目标
若目标是100时间内从未进入B,进入B后再快速返回,也不能撤销已经发生的那次进入。若目标是减少100时间内在B累计停留多久,返回就有直接价值。
同样,一直在稳定态施加保护与只在转变路径上操作,持续时间、信息要求和失败条件都不同。不能只比较峰值强度,便说它们用了相同预算;也不能只比较变化后的平均状态,便说它们同样阻止了转变。
本文给一个能独立核验的有限模型,比较这些条件。它是本库的教学链,不拟合任何具体气候、健康或金融操作。原始随机控制研究提供的是条件路径理论,随后再检验其“最优”能否与这里的受限目标对应。
把三个动作放进同一物理过程
沿用T114的双通道图,改变其速率并加入B返回A,使系统可以反复起步和恢复。这里致动器改变真实跳跃率;不是通过选择样本再重加权,去估原本未改变的系统。
| 阶段 | 无控制的出口率 | 作用含义 |
|---|---|---|
| A:旧态 | 到C:0.02 | 平均等待50时间后起步 |
| C:可分流阶段 | 到A:0.1;到U:0.6;到L:0.3 | 平均停留1时间 |
| U:较危险通道 | 到A:1;到B:4 | 先达B概率0.8 |
| L:较安全通道 | 到A:7;到B:3 | 先达B概率0.3 |
| B:新态 | 到A:0.02 | 平均50时间后返回 |
从C出发,在返回A前先到B的概率是$0.6\times0.8+0.3\times0.3=0.57$。从A出发,100时间内至少到B一次的无控制概率约67.24%;B累计占有时间均值约24.53;时刻100恰好在B的概率约34.20%。三个数字描述不同结局。
三个指定致动器都采用幅度$0\le u\le2$:
- 减少起步:只在A作用,令A到C的率变为$0.02e^{-u}$。
- 改变通道:只在准备完成的C作用,C到U的率为$0.6e^{-u}$,到L为$0.9-0.6e^{-u}$,到A仍0.1。总退出率始终1,避免把分流与延长C停留混在一起。
- 促进返回:只在B作用,令B到A的率变为$0.02e^u$。
代价明确定义为:
这是本模型的资源记账单位,不是已测的物理能量,也不是原论文的路径相对熵。改变哪条率、幅度上限、成本如何增长,都属于比较条件;换一种致动器就需要重算。
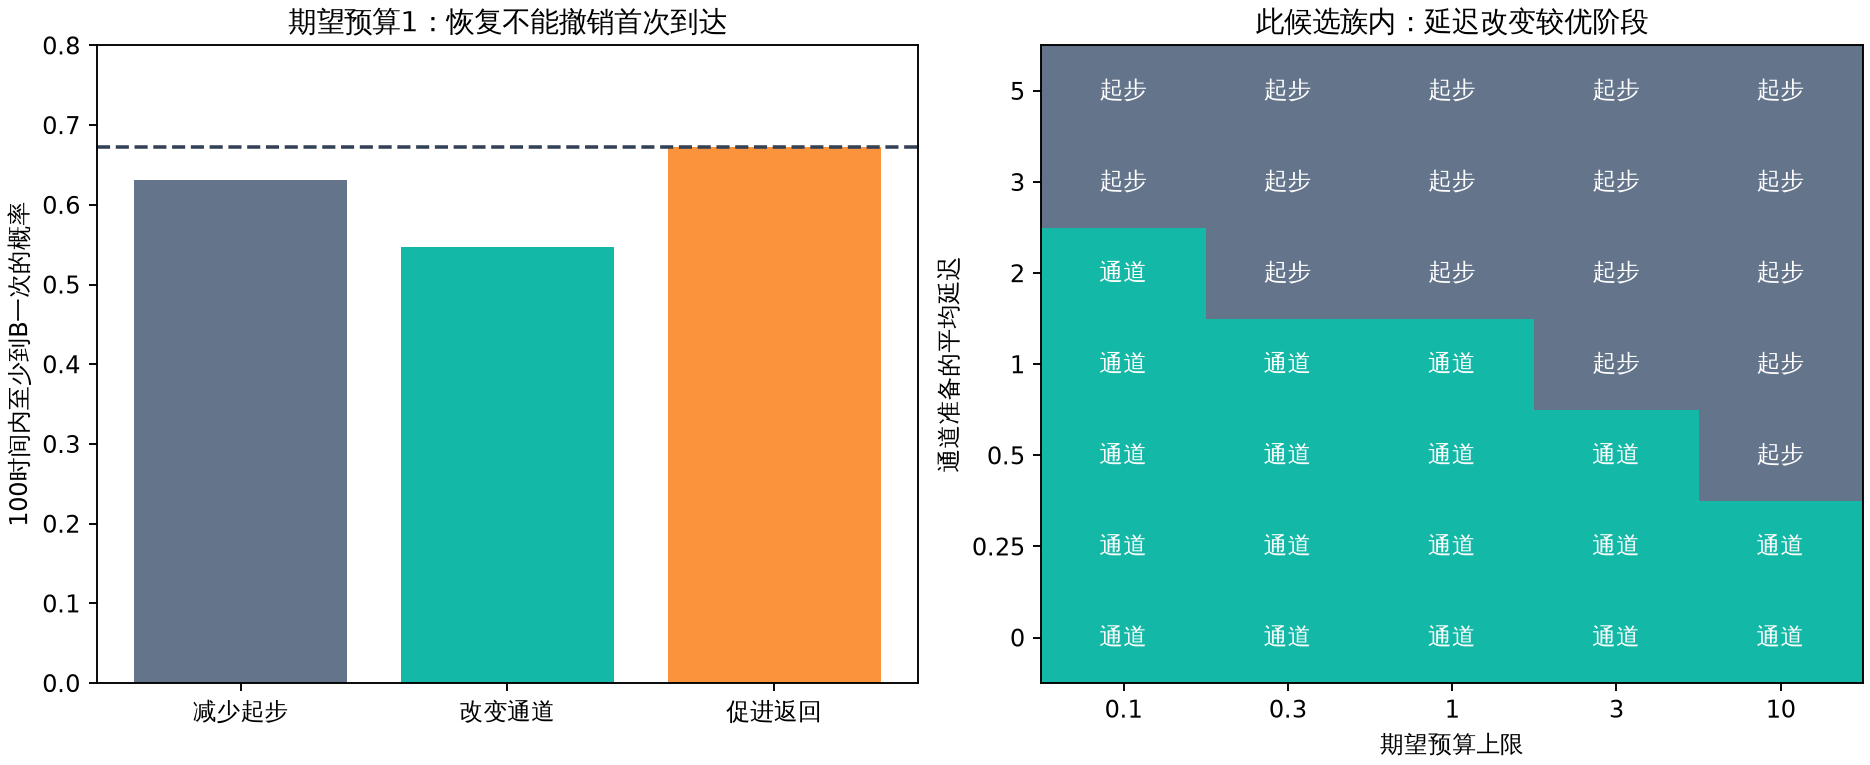
在期望预算下,及时分流可以很有效
先假定完整状态可见、操作立即开始。对每个致动器,求一个固定幅度,使$\mathbb E R\le1$;若先到幅度上限,则保留未用预算。概率、B占有与代价由连续时间链的矩阵指数求得,再以独立ODE核验。
| 动作 | 幅度$u$ | 100内首次到B概率 | B累计占有均值 | 期望资源 |
|---|---|---|---|---|
| 无控制 | 0 | 67.24% | 24.53 | 0 |
| 减少起步 | 0.1147 | 63.06% | 22.44 | 1 |
| 改变通道 | 0.7960 | 54.66% | 18.62 | 1 |
| 促进返回 | 0.2113 | 67.24% | 22.40 | 1 |
减少起步需要在漫长A等待中持续付费,预算允许的幅度较小。改变通道只在短暂C阶段付费,并把流量移到成功率较低的L;此条件下收益更大。促进返回缩短了B停留,却完全没有降低首次进入概率。
这组结果没有证明“路径上的干预普遍更好”。它依赖能准确发现C、及时改变分流、U/L的风险差别,以及所给的成本。
最强的简单反例是让U与L的出口率都变成到A:1、到B:4;此时它们风险、停留时间和后续去向都相同。本库重新算$u=0,0.5,1,2$,仅在两通道之间转移流量,首次到达概率完全不变,差低于$10^{-14}$。改变路径只有触及目标相关差异,才会改善目标。
延迟会把“适合操作的地方”变成“来不及操作的地方”
C平均只停留1时间。若准备需要固定$d$时间,能留到准备完成的比例为$e^{-d}$;$d=3$时只有约4.98%。大部分路径已经去了U、L或返回A。
实际计算采用16个连续准备步骤的Erlang延迟,平均为$d$、变异系数$1/4$;离开C就取消准备。准备阶段不计本篇定义的运行资源;若准备也收费,需要重算预算。其存活比例是:
$d=3$时约6.40%。这是明确的随机延迟模型,不能叫作精确固定延迟。准备步骤从4增至64,该比例约从10.66%降至5.33%,趋向$e^{-3}$;相应风险也向固定延迟结果靠近。本篇保留16步的定量条件,不将其小差异当作无误差极限。
仍用期望预算1,通道操作在$d=0,1,3$时,首次风险约为54.66%、61.37%、66.14%。$d=3$时已用到幅度上限2,期望资源却仅约0.369;多出的预算不能凭空延长可用阶段。减少起步的约63.06%在这一对照里更有效。
若此通道传感器正确识别C的概率为0.8,另有0.02的A访问误报,误报只浪费设备运行资源、不能在A改通道;$d=1$时重新匹配预算的首次风险约64.08%。这个模型只核此分流装置的识别失败和浪费,不把它当作三类传感器的全面优劣比较。时序优势可能由信息质量决定,而非作用阶段本身。
期望花费不超限,不保证每次都花得起
前表约束的是$\mathbb E R$。某条轨迹长时间留在作用阶段,仍可能花费超过1。若预算是每次只有一份实际资源,需要逐条施加$R\le1$,预算耗尽后停止操作。
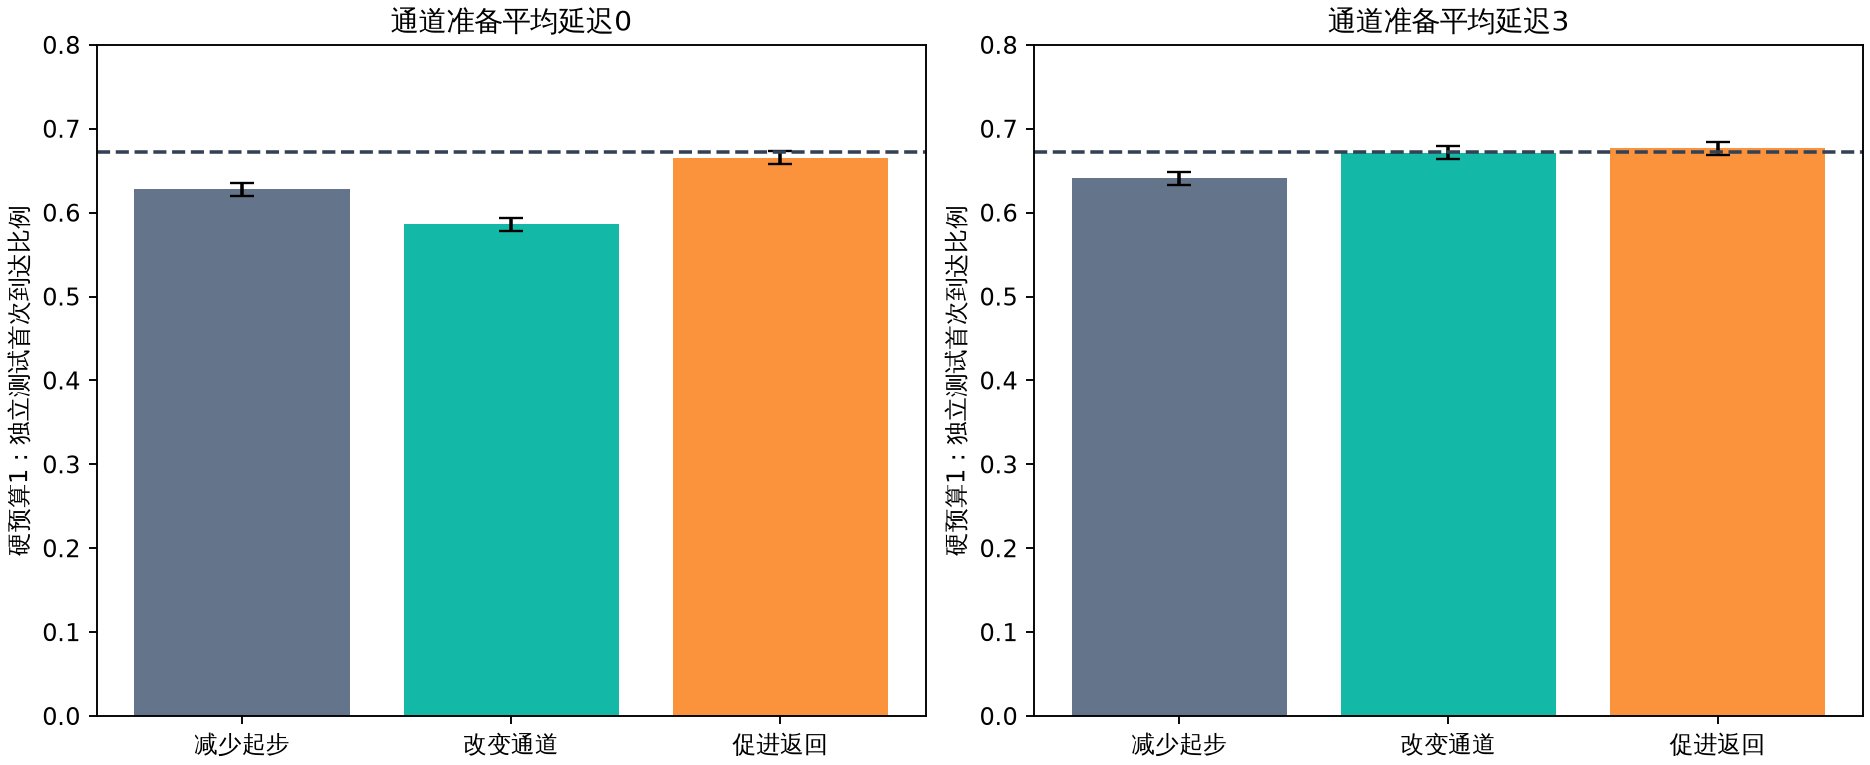
本库采用事件驱动模拟,显式处理物理跳跃、准备完成、资源耗尽和截止时间。预设12个固定幅度候选,先用2000条训练路径选幅度,再用另外15000条路径测试;每条测试实际花费均不超过1。不使用测试结局重新挑幅度,也不称找到全部反馈策略的全局最优。
| 首次进入目标;起始A | 减少起步 | 改变通道 | 返回动作候选 |
|---|---|---|---|
| 准备无延迟:测试首次比例 | 62.80% | 58.60% | 66.55% |
| 相对同一随机输入的无控制变化 | $-3.75\pm0.16$个百分点 | $-7.95\pm0.29$个百分点 | 0 |
| 通道准备平均延迟3:测试首次比例 | 64.12% | 67.16% | 67.68% |
| 相对同组无控制变化 | $-3.56\pm0.15$个百分点 | $-0.52\pm0.14$个百分点 | 0 |
“$\pm$”为配对差的一个标准误,不是95%区间。两组随机种子不同,比较策略效果用各自同输入的基准,不把62.80%与64.12%的波动解释成起步动作受通道延迟影响。起步幅度两组均选0.1,通道均选0.65;返回动作在首次目标下各幅度没有收益,训练选择了0。
无延迟时,改通道的首次比例比减少起步低4.20个百分点,配对SE约0.32个百分点;平均延迟3时,改通道反而高3.04个百分点,配对SE约0.20个百分点。这一次排序反转有明确抽样证据。
不能把期望预算表的54.66%直接移来作为硬预算结果:这里重新选择了幅度,且个体资源耗尽会改变后续动作。强度太高也可能把资源烧在C等待上,真正分流时已经停机。有限候选中$u=0.65$优于更强动作,就是这一权衡的一个具体表现。
另用“剩余资源”方程作独立数值核验:资源格点50、100、200,积分器为BDF,区别于模拟的精确耗尽计时。四组首次/占有统计与最细格点相差最多2.22个Monte Carlo标准误;格点仍带人工资源扩散,不号称连续资源精确解。无耗尽对照的四组各25000条模拟,也与矩阵结果相差不到1.67个标准误。
已经进入B以后,换一个目标就会换一个答案
如果初始就在B,首次进入事件已经发生,其概率为1。仍要求“这次从未进入B”,三种动作都无法改变历史。
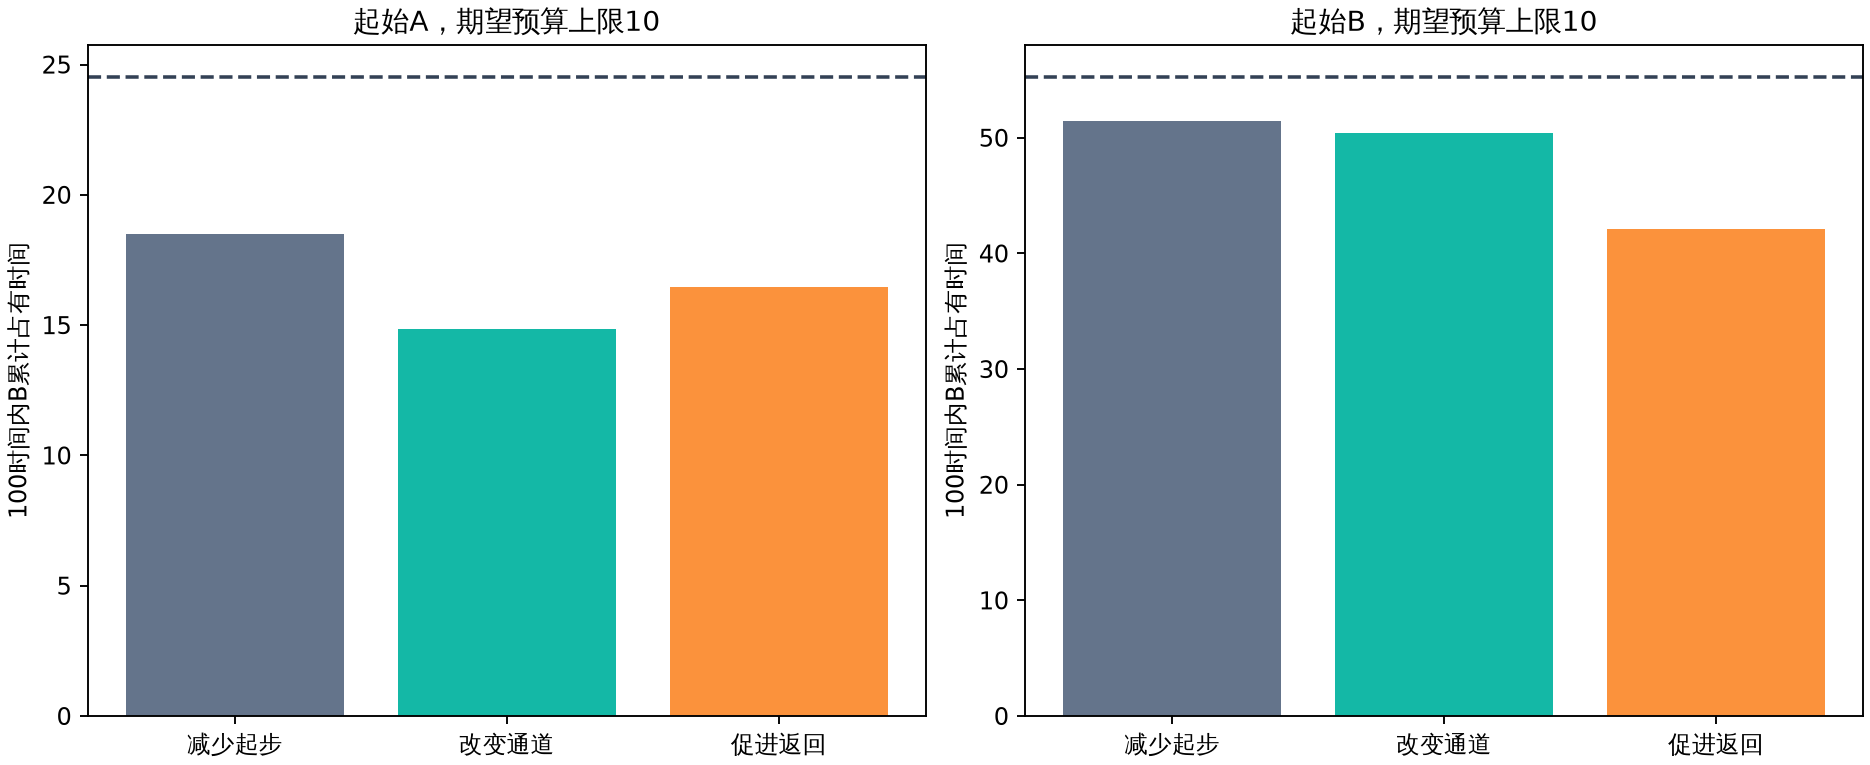
若目标换成缩短B累计占有,促进返回直接作用于初始停留;减少起步和改变通道要等系统先返回A,才能减少后来再次进入。期望预算上限10时:
| 起始状态 | 减少起步:B占有 | 改变通道:B占有 | 促进返回:B占有 |
|---|---|---|---|
| A | 18.51 | 14.84 | 16.46 |
| B | 51.46 | 50.41 | 42.13 |
本参数下,起始A仍是及时改通道较好;起始B则促进返回更有价值。通道动作因幅度上限,实际期望花费分别约6.61和3.83,低于上限10;表比较同一资源上限,不谎称实际耗费相同。
硬预算1的独立测试又更谨慎:起始B、以占有为目标时,三个候选族均值约54.84、53.62、53.07。返回比改通道低约0.55,但配对差的约95%区间为**$[-1.12,0.03]$**;当前样本不足以判定这两个候选族谁严格更优。期望预算10下的明确对比,不能替这个不同预算任务补上确定性。4
目标、初态与资源上限共同改变策略的边际价值。把“预防”或“恢复”单独当作一种总是更先进的理念,会把这层条件抹掉。
原论文中的最优控制,到底最优什么
Singh与Limmer的2024研究已发表于JCP;本库核发表元数据,实际读到的是2024年7月修订作者v3全文及内附附录,发表页面本次403。1
其有限终点条件是:在指定$T$时位于B。定义:
对$\mathrm dX=b\,\mathrm dt+\sqrt{2D}\,\mathrm dW$,理想条件过程的附加漂移为$2D\nabla\ln h$。在允许相应完整状态、方向和时间依赖控制时,它生成原路径法条件化到终点B后的系综;相关最优性用路径概率代价表述。
静态先达概率$q$回答的是先B还是先A。把$q$用于近似有限终点$h$,原文依赖双稳态的谱隙与时间尺度区间,不是对任意系统、任意$T$的恒等转换。2025非平衡研究也明确指出理想桥控制强烈依赖时间且可奇异,转变场与施力方向的关系仍有动力学条件。2
本链给出具体区别:$q(C)=0.57$;但0.1、1、100时间后恰在B的概率分别约0.0131、0.3105、0.3670。到过B再返回、仍未完成中间步骤,都使有限终点问题与先达问题不同。
对于从C开始、先B后A的条件路径,静态Doob变换将率改为$L^q_{ij}=L_{ij}q_j/q_i$。C到U/L变为约0.8421/0.1579,U/L到B分别为5/10,所有到A的出口被消除。这些路径保证到B,并保持原成功路径中的比例;它们不是本篇希望减少进入B的干预。
若改为条件化到先A,需要$1-q$的完整变换,也要改变U/L等位置的出口。本篇三个致动器做不到那些全部变化:分流装置不能在U/L关闭B出口,且C到A仍为0.1;即使无限强地把U流量全移到L,起步后成功概率也仍有0.27的下限。知道$q$不会自动消除不可控方向、饱和与准备延迟。
本库实际执行固定原代码的势能、力、井概率与控制力构造四个函数,并以独立$q$积分回调核100点,控制力公式差约$1.8\times10^{-11}$。3 只核这些函数和输入条件,没有运行原样条拟合、神经网络、分子轨迹或原速率。这项核验不将理想桥控制认证为本篇资源受限策略的最优解。
怎样把机制认识接到有边界的行动比较
前七篇给出的条件,在这里连成一条具体检查链:小扰动恢复不等于有限风险;等待时钟不等于路径窗口;噪声方向与记忆不能只用幅度概括;状态信息不足会影响分流;空间转变还区分成核与传播;加速采样的频率必须恢复原测度;预警误报和提前量决定短阶段能否操作。
因此,一次可检验的策略比较应同时写出目标事件、作用阶段、真实可改的率或力、代价与上限、信息与延迟,再用改变后的动力学评价结局。动作影响了哪里,要有对应的区分证据,不能只看恢复曲线变快或路径图更漂亮。
本篇得到的是有条件的答案:可及时识别并改变有风险差异的通道时,路径干预可能划算;可用阶段短于准备时间时,提前减少起步可能更有效;已经进入新态且目标包含停留损失时,促进返回才有直接价值。当前研究没有建立全策略最优,也没有把期望预算替成个体预算;硬预算1、起始B的两个较好候选,比较仍未定。
真实装置的代价标定、传感误差与延迟、空间控制及多维记忆状态,都需要另有证据。这些缺口限定结论,却不妨碍在明确模型中完成可靠的阶段比较。
来源与复算范围
<a id="source-s1"></a>[1] Aditya N. Singh、David T. Limmer(2024),Splitting probabilities as optimal controllers of rare reactive events,JCP 161, 054113发表入口。发表元数据已核;实际取得作者v3,核式18—25、路径动作/重加权与最优性、附录A的时间尺度/近似/惯性限制,发表PDF未取得。
<a id="source-s2"></a>[2] 同作者(2025),Reactive path ensembles within nonequilibrium steady states,PRResearch 7, 043222。发表PDF与T112所取原件哈希相同,本篇重核式5—12、奇异时间控制、作用方向/小力条件与概率流段;未运行其粒子或高分子模拟。
<a id="source-s3"></a>[3] 原作者代码,Splitting-Optimal,固定4187df4312262abc4ff83b8576e47bda0c8b7280。取得1D/敏感性notebook及README;读取势/指标/样条/控制函数相关代码,实际隔离执行四函数,只去掉可选JIT装饰器。没有取80MB轨迹、执行原完整notebook或称完整分子复现。
<a id="source-s4"></a>[4] Codex(2026,本库计算),T116模型输入、逐路径测试与独立资源方程核验,见以下结果与代码记录。这是本文自己的数值证据,不是外部研究或独立审阅。
本库代码research/calculations/constrained_transition_control.py及constrained_transition_control_audit.py;原件、独立资源方程核验和日志在evidence/2026-10-08-constrained-transition-control/,来源/自审在相应research/sources/JSON。输入、预算图和全部计数见results.json,逐路径实际花费与结局见hard-budget-records.npz。