同样会做一件事,下一次改变可能不同
两块材料都能在下端被拉开时,让上端张开相同距离。它们当前的成绩一样,内部弹簧却不一定一样:一块依靠某条传力路线,另一块依靠另一条。若下一项任务要求上端收缩,所需改动可以不同;若换到另一处读出,原来的优势又可能消失。
Falk等2023年的研究,把这种差别称为材料的adaptability。作者在设计优化中交替要求两种不兼容功能,寻找各自能完成目标、彼此又只需少量参数改动的状态。核心问题是训练能否选择更容易切换的结构,而非单个参数状态能否同时给同一输入两个相反输出。1
这项结果也留下一个需要继续检验的问题:更容易回到练过的任务,能否转化成更容易学习未练过的任务?本篇先回到原始数据,再用当前功能、资源和优化器状态受控的弹簧网络把两者分开。
原始研究中的“更容易”,具体指什么
原研究的变构网络有22个可动节点、固定边界和83条弹簧。几何与静长不变,刚度可以调整。相同源端形变,对应目标端伸长或收缩两种任务。作者优化的是最低能模态与目标运动的重合,并鼓励它与下一模态之间有能隙;不是直接最小化下文使用的静态读出误差。
作者对多个交替周期各做500次随机初始化。成功得到两种达标状态之后,再统计两状态之间有多少条弹簧的相对平均刚度变化超过0.1。正文报告,某些快速交替的成功对只需明显改变5条边,单独优化两目标得到的状态通常相差约50条。该比较以两边均达标为条件;交替更快时,成功产率也会下降。1
物理解释是复用相似的协调运动,只改变少数连接来转移运动方向。原文报告大网络低能模态重合度的证据;本库未取得其发表附件和完整训练输入,没有独立重画这一模态比较。公开代码中的几何函数已实际执行,相关成本函数已读;其模板有本机绝对路径,不能据取得notebook就声称复现了原变构训练。3
这里的“非平衡训练”指设计目标随时间切换。变构例仍由外部程序计算全局成本并调刚度,并非材料只靠自身局部信号自主优化,也没有证明同等整机能耗下更有效。
回读删边数据:少改边与低成功率同时存在
作者另研究周期边界下约200节点的无序弹性网络。施加不同形变,找出受应变最大的边并删掉,目标分别为有效泊松比大于0.75和小于−0.75。局部受力信息参与选边,但选择最大值与实施删边仍由模拟程序完成。最关键的约束是:删掉的边不能加回来。
本库固定作者公开仓库提交796dc40c3c237bd98e3d1ce89b285656916d1a4b,实际执行四个原分析函数,读取500条轨迹的体/剪模量数组,并读取238个已保存网络的刚度数组。按原分析定义
以第60和80步分别达到两项目标为成功,若81个保存状态中的任一体模量小于$10^{-20}$,按作者规则归入机械失效。这里沿用作者的有效模量指标,不将可能各向异性网络所有方向的泊松比等同于它。独立公式与分类核验得到:24
| 交替训练的结局 | 数量/500 | 比例 |
|---|---|---|
| 两个指定状态均达标 | 25 | 5.0% |
| 未触发体模量阈值,但未达两目标 | 61 | 12.2% |
| 触发作者体模量失效阈值 | 414 | 82.8% |
若只看未失效的86条,成功率是29.1%;若问随机启动一条训练能否成功,答案是5%。两个分母回答不同问题,不能互换。
25个成功状态对都恰好相差20条边;独立训练两目标的94个成功对,相差42—92条,中位数66。原正文将后者概括为约40—70;本库固定公开数据包含更长的尾部,故按实际数组报告范围。例子第5号的两个状态,$\nu$约0.794和−0.981,逐边核查确认后一个状态只是在前一个状态上又删了20条边。
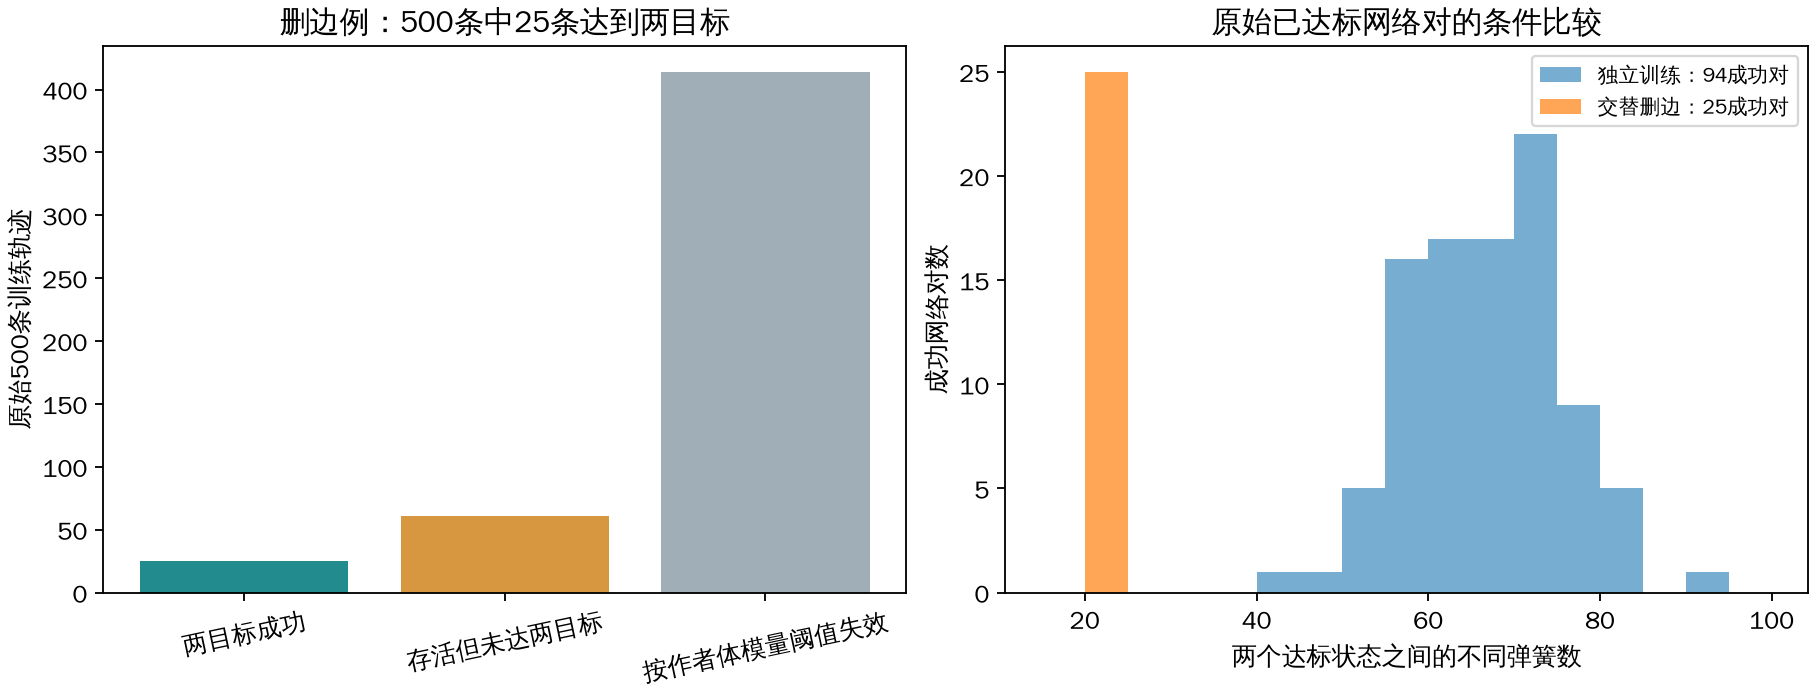
这支持“成功状态之间可以少改边”的条件收益。它没有建立任意新功能的适应优势,也没有让不可逆删边变成可无限往返的开关。继续删边终会耗掉结构,恢复原状态需另加修复机制。本库归约的是原保存数据,没有重新生成500条删边轨迹或独立重算其预应力网络的全部模量。
用相同当前功能比较两段训练历史
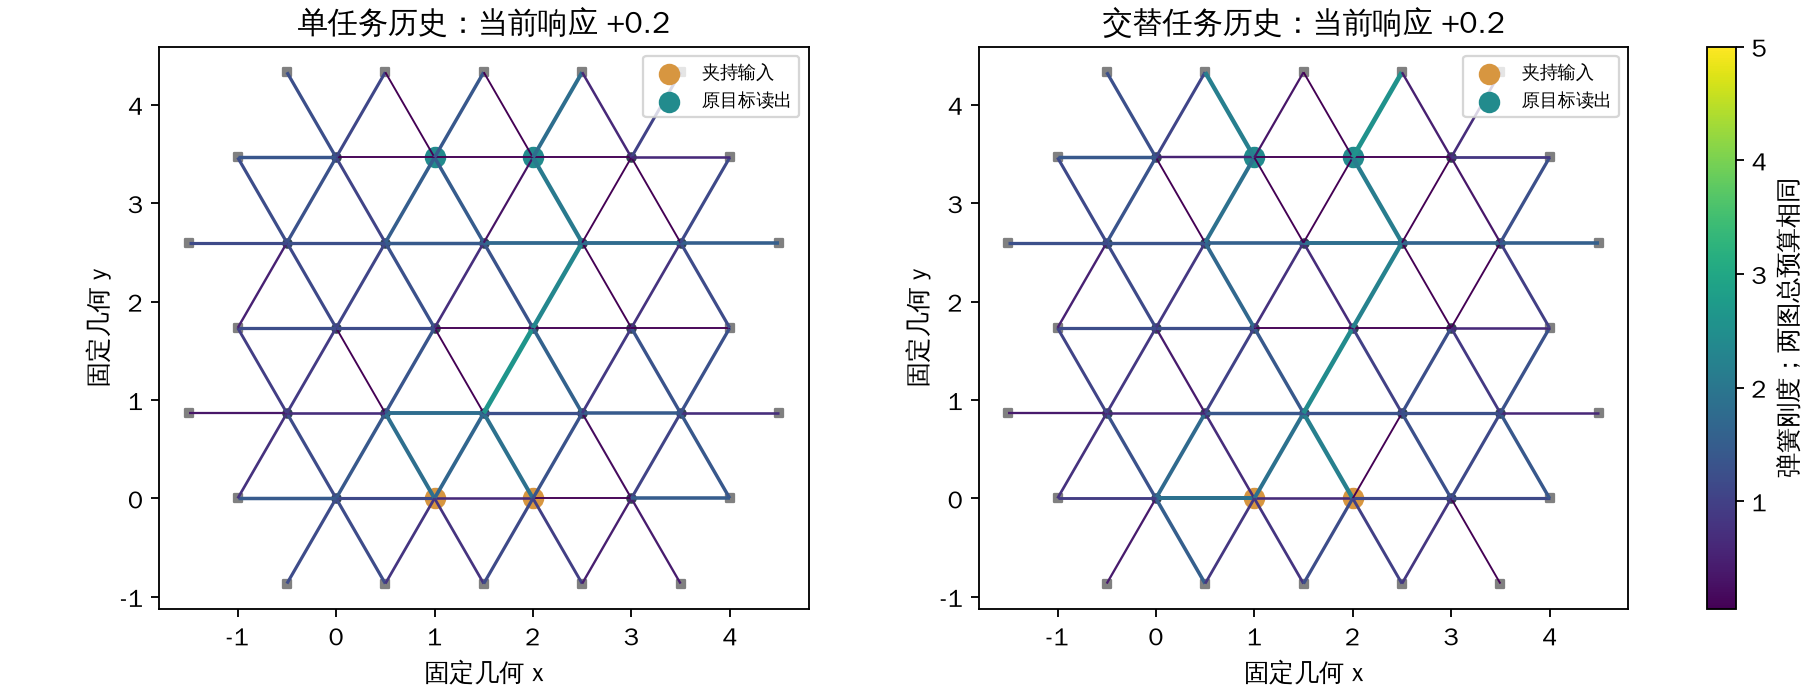
为了检验未见任务,本库在作者几何函数生成的22可动节点、20固定边界节点、83条边上,另建一个线性静态弹簧模型。每条边只抵抗沿自身方向的相对位移。令$Cq$为各边的小形变,能量为
下端两节点的横向位移固定为$+0.1$和$-0.1$,纵向位移固定为零;外围节点固定。其余40个自由度由力平衡求出。若将可动自由度与夹持自由度分开,刚度矩阵为$H=C^T\operatorname{diag}(k)C$,实际求解
原目标端两节点的横向位移差除以输入差0.2,记作读出增益$r(k)$。任务A要求$r=+0.2$,任务B要求$r=-0.2$,成本$L=(r-y)^2/2$。始终限制
两组不能靠整体变软或增加总刚度取得表面优势。小形变线性弹簧与无量纲模型单位是这里的假设,不代表有限形变、断裂或真实材料制造误差。
12个随机初态逐一配对,每对使用相同初始刚度、同一投影梯度规则,预训练都呈现4000次:一组始终练A,另一组依次练B、A、B、A,各500次,再练A2000次。两组最后都达到$L_A\le10^{-9}$。优化器每步重新设置步长并回溯,没有动量或外部优化器记忆留到下一阶段;历史差别保存在弹簧配置里。
这里匹配的是呈现次数、参数范围、总刚度和当前误差门槛。单任务达到目标后仍可继续呈现,但实际写入会变少,因此不能把它称为相同实际写入、墙钟时间或能量预算;完整记录另留了边更新次数。4
三种后续任务,得到三种不同的比较
预训练之后,每个状态最多再更新1000步,共用成功门槛$L\le10^{-12}$。后续任务分三类。
第一类是在原读出端切回已经练过的B。第二类在四对新节点的横、纵方向读出,共8个新端口;将一对预训练状态在该端口的输出中点设为共同目标,使两边初始误差严格相同。由于允许刚度集合凸、响应连续,连接两状态的参数线段上存在达标点,本库也实际求出了每一条见证。这个目标规则依赖预训练后的状态,是人为的匹配对照,不是独立自然任务分布。
第三类同样使用8个新端口,但标签来自预训练前就固定的另一组合法“教师”刚度。两种方法、所有初态共用这些标签,不根据训练结果挑目标。教师提供可实现性见证,却不保证两组新任务起始误差相同。
各新任务组有$12\times8=96$对比较;同一个网络上的8个端口相关,不能当成96个独立材料样本。后续训练允许旧A改变,本篇检验的是适应,未同时要求保留A。
| 后续任务 | 单任务历史:达标数、步数中位数 | 交替历史:达标数、步数中位数 |
|---|---|---|
| 已见B,12对 | 11/12;496 | 12/12;390.5 |
| 新端口、匹配起始误差,96对 | 91/96;80 | 88/96;87.5 |
| 新端口、固定外部教师,96对 | 86/96;150.5 | 88/96;105.5 |
步数中位数包含所有结果,1000步未达标的也按1000步保留。在两方法均成功的相同配对里:已见B为交替更快7对、同速1对、更慢3对;匹配误差的新端口为39、1、44;固定教师的新端口为51、1、31。未达标结果已在上表单列,未从比较中悄悄删除。
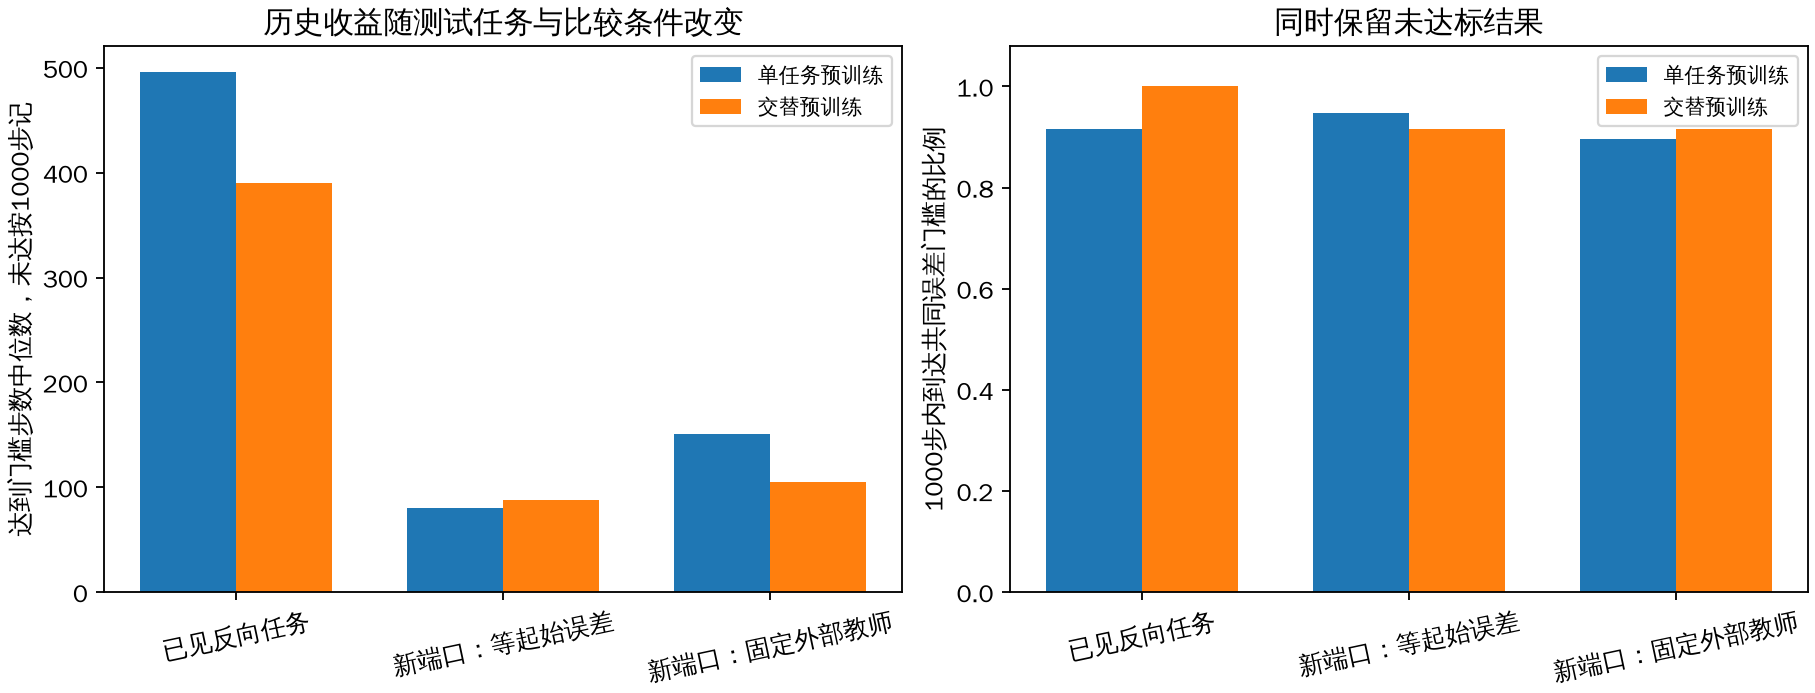
这个有限实验中,旧任务切换有一定优势;新端口的结论依赖目标选择和起始条件。固定教师那组较快,并不能单独说明广泛“学会了学习”;匹配初始误差后,另一组新任务没有显示一致优势。两种设计回答互补问题,不能挑其中一组替所有未来任务下结论。
步数少,是否也意味着改动少
仍然不一定。在两方法都学会B的同一11对中,刚度改变量$\|k_{\rm end}-k_{\rm start}\|_2$的中位数为5.362和5.499;交替历史有7对改变量反而更大。按每条边变化超过0.1计数,中位数为52和55;改用0.05门槛时为71和71,改用0.2时为36和38。
对匹配误差的新端口,两边均成功的84对中,改变量范数中位数为0.244和0.339;固定教师的83对则约0.592和0.584。后者两方法的差别很小,也没有给出统一的边数优势。
因此,达到同一误差所需步数、最终改变量范数、越过门槛的边数和实际写入事件是不同指标。门槛与参数单位必须明确;本例平均刚度始终为1,0.1可直接与相对平均刚度比较。参数范数也不是能耗,尚未计入计算梯度、力平衡求解和实际改变刚度的物理过程。
原文的“近解对”是一种有用的设计目标,本库当前这个受控优化过程并未直接最小化状态间距离。它不能保证在该指标上复现原低能模态优化的收益,也不构成对原特定模型结果的否定。
历史怎样改变下一次学习的局部条件
同样的当前输出,只规定参数空间中的一个约束,并没有固定全部刚度。不同达标状态可以有不同的传力路线,也可以有不同的新响应灵敏度$j=\partial r/\partial k$。
在所有边都处于参数范围内部时,若仅需维持总刚度,令$P$为总和为零的方向投影,微小梯度步给出
相同初始误差下,可用响应灵敏度不同,就会有不同的局部学习速度。到达上下界后,还必须投影到允许的方向锥;不能继续减弱已经最软的边。局部灵敏度再大,若朝的是禁止方向,也不能直接用上。
一个实际例子是第0对网络的新横向端口6—7。两边初始残差绝对值均为0.0005994。只考虑总预算时,单任务、交替历史的灵敏度范数分别约0.0769和0.0990,看起来后者较大;但两状态分别有14和13条边已到刚度下限。纳入边界后,投影下降方向的范数反而分别为$4.04\times10^{-5}$和$2.96\times10^{-5}$。
取诊断步长$\eta=10^{-3}$,可行方向的一阶预测给出成本减少约$1.6345\times10^{-12}$和$8.7411\times10^{-13}$,实际重新求力平衡后的改变量与之相符;完整训练分别用了132和256步。这个例子走通了“同误差—不同刚度位置—允许更新方向不同—下一步收益不同”的机制。它不证明初始斜率能预测整个训练路径;路径上的灵敏度、边界和步长还会变化。4
哪些结论已成立,哪些仍需更强检验
原始研究与可读保存数据支持:在特定已见目标之间,随时间切换的设计优化可以筛选出相距较近的成功状态;收益需要连同失败率、可逆性和所用改动指标报告。原文还包含聚合物折叠模拟,本篇没有复算,不能将弹簧对照推广为所有材料的共同定律。
本库独立力学审计重新组装每条弹簧的刚度矩阵,核了24个预训练状态、408个后续结果、全部预算和可实现性见证;180个独立差分与响应梯度最大差约$8.7\times10^{-11}$。它支持本文计算内部一致,不替代真实材料实验或独立研究者复现。发表附件与Zenodo存档本机未取得;原变构完整训练、原删边生成和预应力模量没有冒充已经执行。
要把特定切换提升为一类新任务的适应结论,下一步应预先规定新端口、加载方式和目标分布,在更多独立几何上检验;同时保留失败、匹配当前功能,区分同起始误差的几何收益与更好起点的收益。再改变参数范围、允许修复或删边、加入实际控制与写入成本,才能判断优势是否经得起材料约束变化。
训练历史确实可以改变下一次调整的条件。本篇能给出的有边界答案是:材料可能被练成更容易切换某些功能,但“更容易学什么、按什么代价、成功几次”必须同时说明。