一条宏观规律被称作「准」,通常只经过一种检验:让系统自己演化,看模型预测的曲线对不对得上。这篇要问的是另一件事——同一条规律,能不能用来指导干预。
这两件事看着像一件事,其实差别很大,而且差别有确切的来源:预测只会被问到系统自己走得到的那些态,干预却把系统放到你想放的任何地方,包括自由演化从不造访、因而模型从未在那里被检验过的方向。
下面在一个能完全解开的系统上,把这句话做成可以量的东西。
两篇方法论文提了什么问题
入口是两篇 2025 年的因果抽象论文。
Xia 与 Bareinboim(ICML 2025,下称 s1)处理「有损表示」:当高层变量丢掉了底层的一部分信息,抽象还能不能成立。他们给出抽象不变条件(AIC)——两个底层取值不能被并成同一个高层取值,除非它们的下游影响相同。不满足时的补救是部分投影(命题 1)与投影抽象(定义 6):给高层补一个新的外生变量 $X_H^u$,携带 $X_L$ 中被 $X_H$ 丢掉的那部分信息。他们自己指出,这种投影在诱导的 PCH 分布上并不唯一,$P(U')$ 是欠定的。
Li、Kaba 与 Ravanbakhsh(AISTATS 2025,下称 s2)问的是可识别性:定理 3.1 说可识别的粒度 $G=G^*/P(\sigma(\mathrm{nd}(I^*)))$,也就是说能分辨到多细,由有哪些干预可用决定;定理 3.2 给出一个块还能不能继续拆开的条件。
这两篇都是方法论文,用的是图像与合成数据。本文不复核它们的证明,只把它们指出的两个结构——「补一个外生变量」和「粒度由可用干预决定」——放到一个物理系统上做成可以算的量,看看要付多少代价。
自由演化上,一条宏观规律确实够用
先把「宏观模型很准」这件事坐实,不然后面无从对比。
系统取 $N=12$ 维耦合线性随机过程 $\mathrm{d}x=-Ax\,\mathrm{d}t+B\,\mathrm{d}W$。谱是设计好的:一个慢模 $\lambda_1=0.05$,十一个快模落在 1.161 到 1.975 之间。$A$ 取成非正规的($A=S\Lambda S^{-1}$,$S$ 是单位阵加一个小随机阵,$\mathrm{cond}(S)=4.39$),左右本征矢因此不同——这是本文问题存在的前提,$A$ 若对称则问题退化。
宏观变量取 $M=w\cdot x$,$w$ 是归一化的全 1 向量。宏观模型只有一条:$\mathrm{d}M/\mathrm{d}t=-0.05\,M$。
暂态(快模时标约 1)过后定标,六个随机初态在 $t=8,12,20,40$ 上的相对误差从 2.2e−4 到 8.3e−3,最大 0.827%。误差在时间上基本不变,说明衰减率本身是对的,差的只是一个常数因子。
噪声稳态下问同一件事:$M$ 的归一自相关在 $t=1,2,4,8,16,32$ 上与 $e^{-\lambda_1 t}$ 的比值是 0.9137、0.8944、0.8885、0.8880、0.8880、0.8880。比值很快稳定,率是精确的,那个 0.888 是慢模在 $\mathrm{var}(M)$ 里占的份额——另外 11.2% 坐在快模上。
就自由演化而言,这个单变量模型是一个称职的宏观模型。下面所有的对比都以它为对象。
同一句宏观指令,微观上有很多种做法
现在做干预:$x\to x+\delta$。宏观层面的说法是「把 $M$ 抬高 1」,也就是 $w\cdot\delta=1$。宏观模型对此只有一个预测:$\Delta M(t)=e^{-\lambda_1 t}$。
但 $w\cdot\delta=1$ 是一个方程、十二个未知数。取五种宏观标签完全相同的实现:
| 实现 | t=1 | t=4 | t=10 | t=25 |
|---|---|---|---|---|
| 均匀($\delta\propto w$,每个分量等量) | 0.314 | 0.102 | 0.098 | 0.098 |
| 集中在分量 0 | 0.939 | 0.987 | 0.992 | 0.992 |
| 集中在分量 5 | 0.527 | 0.502 | 0.502 | 0.502 |
| 两点反相+均匀补偿 | 0.342 | 0.221 | 0.222 | 0.222 |
| 沿慢模右本征矢 $\delta\propto r_1$ | 1.000 | 1.000 | 1.000 | 1.000 |
表里是各实现的 $\Delta M(t)$ 除以宏观预测。$t=10$ 处五个数落在 0.098 到 1.000 之间,相差 10.2 倍。
值得停一下的是:最符合直觉的那种做法——「要把总量抬高,就每个分量等量地抬」——恰恰是最差的一个,只兑现了宏观承诺的 9.8%。
分歧的来源可以写死。真实响应是
再加一个预算约束就得到闭式的界。设 $\|\delta\|\le\rho$,在 $w\cdot\delta=1$ 的约束下,柯西–施瓦茨给出 $\Delta M(t)$ 的可达区间
原因在下一节:唯一一致的那种实现,范数是 4.060,而预算只有 2.000。
什么时候宏观模型对干预也成立
从 $g=\alpha\hat w+g_\perp$ 直接读出充要条件:宏观模型对一切干预都一致,当且仅当 $g_\perp\equiv0$,也就是 $w^{\mathsf T}e^{-At}\propto w^{\mathsf T}$ 对一切 $t$ 成立——即 $w$ 是 $A$ 的左本征矢。这正是精确可归并(exact lumpability)。把 $w$ 换成左本征矢后实测 $|w^{\mathsf T}e^{-At}-e^{-\lambda t}w^{\mathsf T}|$ 的最大值是 3.492e−15。
本文的 $w$ 不是左本征矢,所以不可能对一切干预一致。但对特定的干预仍可以:$\delta$ 只激发慢模时,响应就是单指数。慢模右本征矢 $r_1$ 给出的实现在 60 个时间点上与宏观预测的最大绝对差是 2.554e−15,机器精度。而且这样的方向恰好只有一维——后面 F 段用奇异值分解验证了这一点。
那么,退一步,能不能靠「多加几个宏观变量」把模型补成对一切干预一致的?最小的闭扩张是 Krylov 子空间 $K(A^{\mathsf T},w)=\mathrm{span}\{w,A^{\mathsf T}w,A^{\mathsf T2}w,\dots\}$,它的维数就是所需的变量数。
这里踩过一个坑,值得写下来。直接对矩阵 $[w,A^{\mathsf T}w,\dots]$ 求数值秩,八个随机系统给出 9 到 10,看着像是「十二维系统只要九个变量就闭合了」。这是假的:幂迭代把后面的基向量一律压向主本征方向,矩阵条件数迅速爆掉,秩被低报。换成精确算法——$A^{\mathsf T}$ 的右本征矢是 $S^{-\mathsf T}$ 的列,于是 $w=S^{-\mathsf T}c$ 给出 $c=S^{\mathsf T}w$,本征值互异时维数等于 $c$ 的非零分量个数——八个系统的答案一律是 12,也就是 $N$。带重正交的 Arnoldi 也不提前中断,基正好 12 维。
所以:要让这个宏观模型对一切干预都精确一致,得把整个系统都带上,约化在干预意义下没有余地。
代价还可以量。唯一一致的那个实现 $\delta\propto r_1$ 的范数是 4.060,而均匀实现只要 1.000——这就是上一节里预算 2.000 时可达区间不含宏观预测的原因:一致的做法比随便的做法贵四倍。
加几个变量够:两种问法要的不是一个数
前面是「精确一致」,实际中真正想问的是 $\varepsilon$-一致。要把这个问题和「自由演化要几个变量」放在同一把尺子上量,需要一个统一写法。
宏观观测者记下 $k$ 个线性量 $y=V_k^{\mathsf T}x$(第一个恒为 $M$)。若未知量 $x$ 的系综写成 $x=Lz$、$z$ 各向同性,那么用 $y$ 去猜 $M(t)=g(t)\cdot x$ 的相对均方误差是
| $k$ | 自由演化·已弛豫 | 自由演化·稳态快照 | 干预·最优记录 | 干预·自然的 $(M,\dot M,\ddot M,\dots)$ |
|---|---|---|---|---|
| 1 | 1.06e−3 | 3.37e−1 | 8.05e−1 | 8.05e−1 |
| 2 | 1.47e−5 | 1.45e−2 | 5.85e−2 | 3.79e−1 |
| 3 | 4.39e−7 | 9.03e−4 | 4.28e−3 | 5.01e−2 |
| 4 | 2.47e−8 | 4.19e−5 | 2.22e−4 | 6.45e−3 |
| 5 | 1.11e−9 | 2.18e−6 | 1.02e−5 | 5.17e−4 |
| 12 | 3.08e−16 | 2.86e−16 | 2.97e−16 | 3.27e−16 |
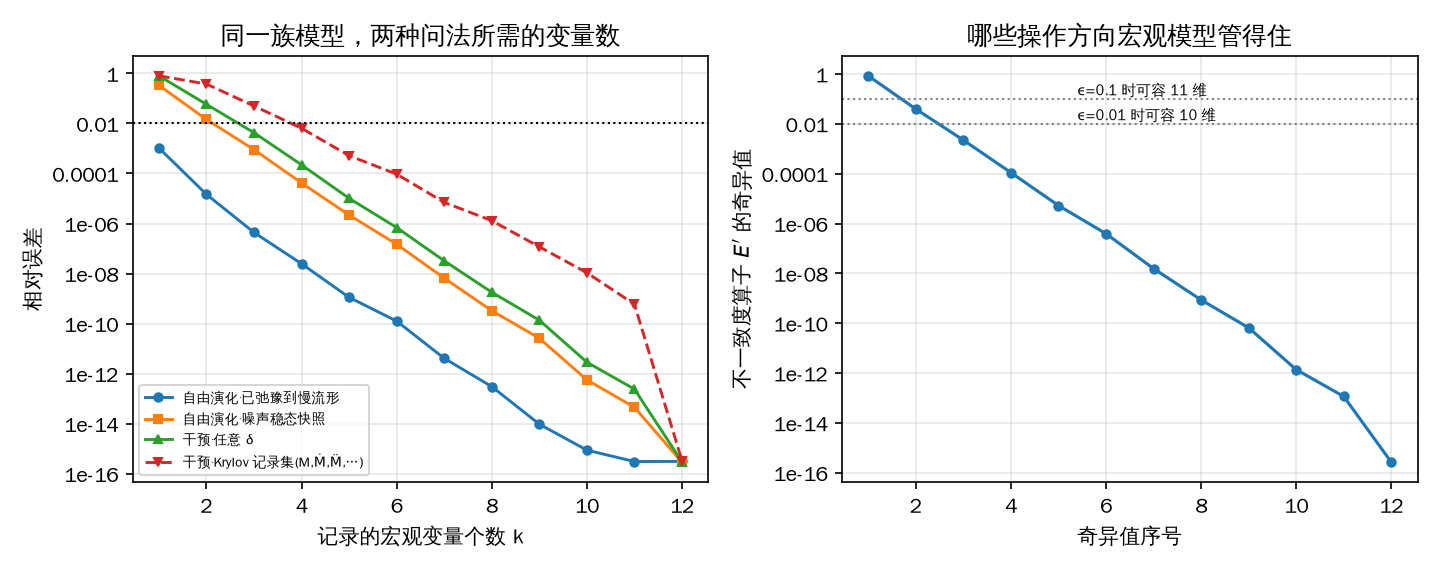
压到 1% 以下所需的变量数:自由演化(已弛豫)1 个,稳态快照 3 个,干预用最优记录集 3 个、用自然的导数序列 4 个;要对一切干预精确一致,12 个。
同一个单变量模型,问「已弛豫的自由演化」误差 1.06e−3,问「任意干预」误差 0.805,相差 763 倍。
差距的来源不是动力学,是被问到的是哪些态。自由演化只会问到系统自己走得到的态——弛豫之后那几乎是一维的,所以一个变量就够;干预却把系统推向任意方向,那些方向自由演化从不造访,模型也就从未在那里被检验过。三种问法的公式一模一样,区别只在权重矩阵 $L$。
顺带一个警示。「不够就再加一个变量、照样闭合」是很自然的想法,但 Galerkin 闭合 $\dot y=-(V_k^{\mathsf T}AV_k)y$ 在 $k=2$ 处给出实部为 −0.271 的本征值——约化模型自己发散了,而原系统全谱为正。所以上面一路只谈「记录集」,不谈闭合。
只准多记一个数,该记哪一个
s1 的补救是给高层补一个外生变量,携带被丢掉的信息。落到这里就是:除了宏观标签 $w\cdot\delta$,再记录一个标量 $u\cdot\delta$。问题是 $u$ 取什么,以及一个标量能买回多少。
| 记录的标量 | 全时段残差 | t≈1 | t=30 | 与最优方向夹角余弦 |
|---|---|---|---|---|
| 最优(响应曲线的第一奇异方向) | 0.0585 | 0.0969 | 0.0383 | 1.0000 |
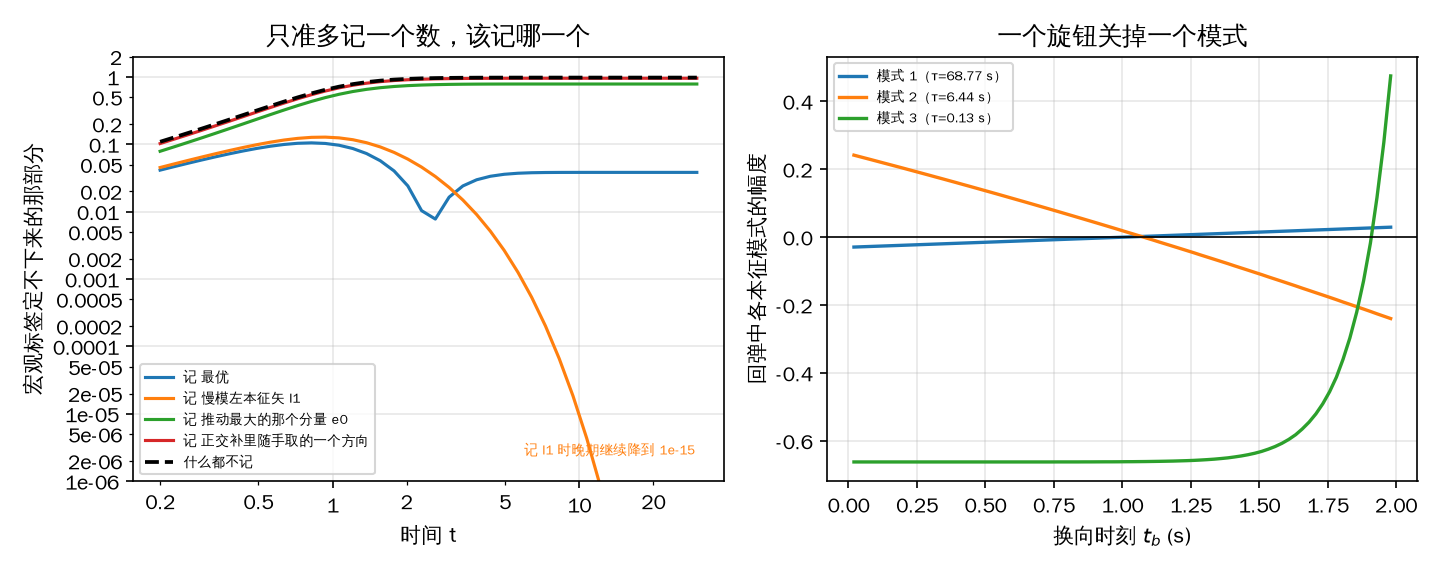
| 慢模左本征矢 $l_1$(激发了多少慢模) | 0.0663 | 0.1246 | 1.6e−15 | 0.9766 |
| 推动最大的那个分量 $e_0$ | 0.6407 | 0.5524 | 0.7846 | 0.5805 |
| 正交补里随手取的一个方向 | 0.7834 | 0.6879 | 0.9554 | 0.2276 |
| 什么都不记 | 0.8047 | — | — | — |
该记的既不是「推了多大」,也不是「推在哪儿」——记 $e_0$ 只把残差从 0.805 降到 0.641,几乎等于没记。该记的是激发了多少慢模,即 $l_1\cdot\delta$,它与最优方向的夹角余弦 0.9766。
$l_1$ 这条还有个漂亮的性质:$t=30$ 处残差 1.6e−15,机器精度。道理是晚期响应本来就只由慢模幅度决定,一个数就够;残差全部落在快模还没死的早期($t\approx1$ 处 0.125)。放到五种实现上看:$t=10$ 时只用宏观标签的最大绝对误差是 0.547,补记一个 $l_1\cdot\delta$ 之后降到 0;$t=1$ 时从 0.652 降到 0.104。
但要注意 $l_1$ 是微观动力学的左本征矢。s1 说投影不唯一、$P(U')$ 欠定——这里看到定它的是动力学,不是抽象映射本身。换句话说,「该记什么」这个问题的答案不在高层,得回到底层去取。
能做的干预越少,宏观模型越站得住
s2 定理 3.1 说可识别的粒度由可用干预决定。把它做成可算的:尺子取宏观模型自己的预测,
奇异值是 8.46e−1、3.93e−2、2.23e−3、1.10e−4、5.26e−6、…、2.63e−16。最小的那个是数值零,对应的奇异矢与 $r_1$ 的夹角余弦 1.000000——精确一致的操作方向恰好一维,就是 $r_1$,与上一节的结论对上。
$\varepsilon=0.1$ 时可容 11 维,$\varepsilon=0.01$ 时 10 维。这个数字看着很宽松,必须说清它宽松在哪:最大的那个奇异方向 $v_1$ 与 $w$ 的夹角余弦是 0.9018,也就是说那一个贵的方向基本上就是宏观方向本身。剩下 11 维里的单位向量最多只能做到 $|w\cdot\delta|=0.432$,要凑出 $w\cdot\delta=1$ 至少得 $\|\delta\|=2.31$。所以「11 维都还行」的真实含义是:那些方向本身没什么宏观效果,便宜是便宜在这里。
随机取操作集合的话,几乎一定落在坏的那边。400 次抽样下,3 维操作集合的最坏 $e$ 中位数 0.384,5% 分位 0.166,400 次里最好的一次也有 0.043。好的操作集合是测度零的,得照着 $r_1$ 专门去找。
结论是 s2 那句话的物理版本:「宏观模型对不对」不是模型单独的属性,得连着「你能做哪些干预」一起说。同一个模型,在一个精心选定的操作集合上误差不到一成,放开到全空间就完全靠不住。
回到实验台:小球、浴粒子与协议整形
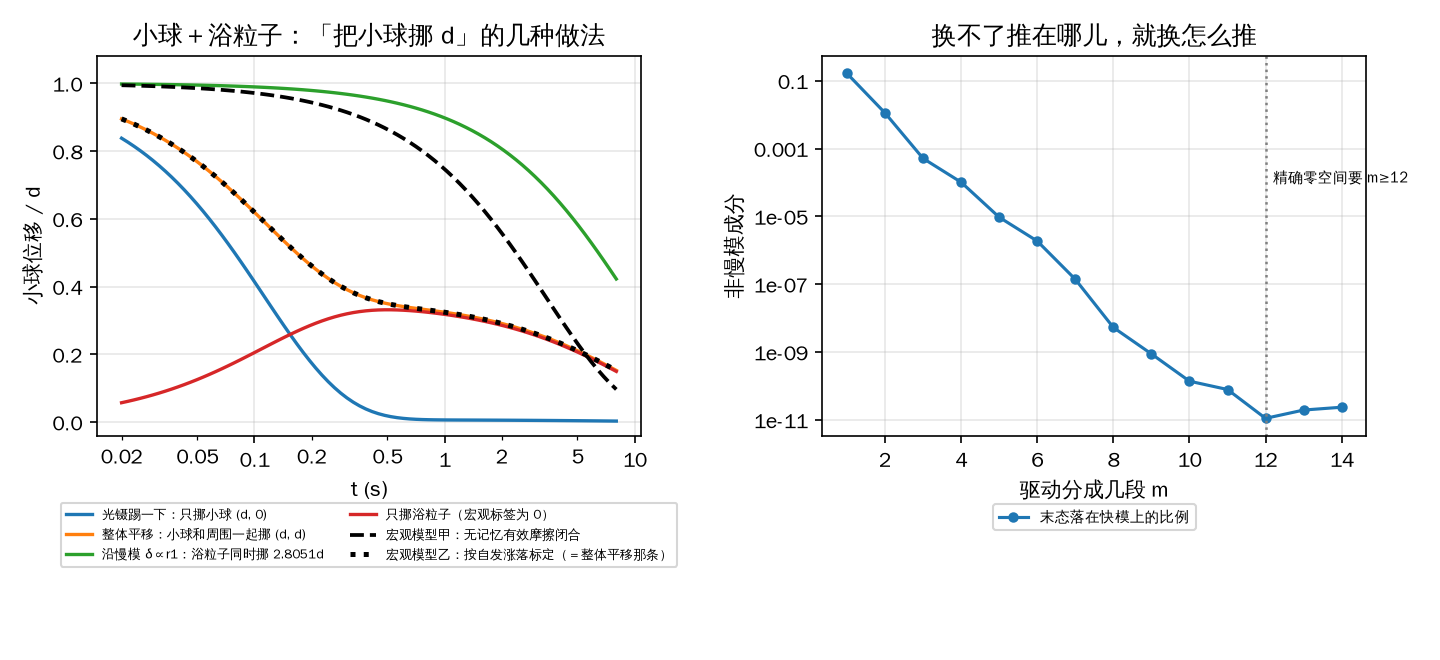
上面都是构造的系统,现在回接专题第 1 篇(T101)那个真实实验:光镊里的胶体小球,通过一根软弹簧耦合到一个「浴粒子」上。参数沿用 T101 从 Ginot 与 Bechinger(2025)拟合出来的那一套:$\kappa=1.95\times10^{-6}$ N/m,$\gamma=0.34\times10^{-6}$,$\kappa_b=1.06\times10^{-6}$,$\gamma_b=6.33\times10^{-6}$。两个本征时标是 9.28 s 与 0.1122 s;T101 研究过的那个无记忆有效摩擦闭合给 $\tau_{\rm eff}=(\gamma+\gamma_b)/\kappa=3.42$ s。
宏观变量就是小球位置。「把小球挪 $d$」至少有两种做法:
- 光镊踢一下:只有小球被挪,$(d,0)$。
- 整体平移:小球和它周围一起挪,$(d,d)$。
宏观标签完全相同。$t=1$ s 时,整体平移的小球位移是 0.324$d$,光镊踢只剩 0.0062$d$——差 52 倍。
差别的物理来源正是 T101 里那个初值关联项:整体平移时小球与浴粒子的相对坐标没变,浴不额外施力;光镊踢则当场把那根弹簧拉长了 $d$,小球在 0.11 s 内就被拽了回去。
再看第三种:只挪浴粒子 $(0,d)$。宏观标签是 0,任何宏观模型都说小球不动;实测 $t=1$ s 时小球走了 0.318$d$。标签为零的操作照样有宏观后果。
这个系统里三个候选宏观模型各配一种实现,谁也不通吃:
- 无记忆有效摩擦闭合($\tau_{\rm eff}=3.42$ s):四种实现里最接近的一种也偏 0.352,谁都不配。
- 按自发涨落标定的那条曲线(归一自相关,含记忆):配整体平移,最大偏差 0。
- 单指数慢模模型($\tau=9.28$ s):配的是「小球挪 $d$、浴粒子同时挪 2.805$d$」那一种。
中间那条有个可以解析写出来的巧合:平衡态下 $\Sigma=k_BT\,K^{-1}$,而 $K^{-1}e_1=(1,1)/\kappa$,所以 $\delta\propto\Sigma w$ 恰好就是整体平移。这件事下一节会变成一般命题。
反过来用:换不了推在哪儿,就换怎么推
到这里都是「宏观模型不够用」。但同一套分解也能反过来当设计工具,这正是 Vaidya 等人(PRR 2025)那组回弹实验的做法:匀速拖动给出单调回弹,中途改变速度就能给出非单调回弹,因为换向时刻是一个可调旋钮,调对了能把某一个本征模式选择性地关掉。
在 Ginot–Bechinger 拟合的双浴粒子模型(三个本征时标 68.77 s、6.44 s、0.1311 s)上把这件事做出来:匀速拖动 2 s 后三个模式的幅度是 0.0299、−0.2455、0.6621(不同号,所以回弹非单调)。一次换向扫过 $t_b$,三个模式各自在 1.007 s、1.077 s、1.909 s 处被压到相对幅度 1e−15 以下——但一次换向只能关掉一个。把驱动切成三段、各段速度自由(两个自由比值),两个快模才能同时压到 1.6e−13。一个旋钮关一个模式,这就是 s4 说的「本征模式越多、协议步骤就要越多」。
推广到 12 维系统,并且把致动器限制得很苛刻:只能推分量 0 这一个地方。一段推完,末态有 0.164 的成分落在快模上,宏观模型管不住。但把推动在时间上切成 $m$ 段之后,要求末态精确落在慢模上是一个 $(N-1)\times m$ 的齐次线性方程组——精确零空间存在当且仅当 $m\ge N=12$,实测 $m=12$ 时非慢模成分降到 1.1e−11。
时间上的自由度可以顶替空间上的自由度,而且个数一样多:$N$ 个记录变量,或者 $N$ 段驱动。
这里第二次踩到同一个坑:残差其实在 9 段就掉到 1e−9 以下了,但精确零空间要 $m\ge12$ 才存在。驱动向量彼此几乎共线,会让「其实不用那么多」在数值上看着成立——和前面 Krylov 维数那次是同一类错误。近简并会让「你不需要那么多维度」这句话在数值上显得为真,这是本文两次撞上的同一个陷阱。
给宏观模型加记忆:预测变准,干预一致性纹丝不动
专题第 1 篇的结论是:少数变量不够用时,补救办法是加记忆。那么加了记忆能不能顺带解决干预问题?
最好的「带记忆的宏观模型」就是 Onsager 回归:$M$ 的自发涨落按归一自相关 $C(t)=w^{\mathsf T}e^{-At}\Sigma w/(w^{\mathsf T}\Sigma w)$ 弛豫。这在线性系统上是精确的——广义 Langevin 方程里那个非齐次项 $\xi$ 取平衡统计时,条件平均正好给 $C(t)$。
描述自发弛豫这件事,记忆确实有用:无记忆单指数模型对 $C(t)$ 的最大相对误差是 12.6%,带记忆的按定义是 0。
但拿去做干预就不行了,而且不行得很干净:
| 实现 | 带记忆模型的最大偏差 | 无记忆模型的最大偏差 |
|---|---|---|
| 均匀($\delta\propto w$) | 0.671 | 0.766 |
| 集中在分量 0 | 0.081 | 0.058 |
| 集中在分量 5 | 0.368 | 0.455 |
| 两点反相+均匀补偿 | 0.596 | 0.691 |
| 沿慢模右本征矢 $\delta\propto r_1$ | 0.096 | 2.6e−15 |
| 像自发涨落那样 $\delta\propto\Sigma w$ | 2.2e−15 | 0.096 |
加记忆把自发弛豫的描述误差从 12.6% 压到 0,却没有压掉任何一点实现间的分歧。原因很简单:带记忆的宏观模型对 $\delta$ 的依赖仍旧只经过 $w\cdot\delta$ 这一个数,所以它对六种实现给出的是同一条曲线。
表里最后两行值得单独看。两个模型各自精确的实现是不同的:带记忆模型精确于 $\delta\propto\Sigma w$,无记忆慢模模型精确于 $\delta\propto r_1$。这两个方向的夹角只有 2.29°——差这么一点点,却是「精确到机器精度」和「差一成」的分别。上一节小球系统里 $\Sigma w\propto(1,1)$ 恰是整体平移,就是这条命题的一个实例。
于是「哪个宏观模型是对的」这个问题本身就不完整:不说清你打算怎么干预,它没有答案。
把偏差理解成 GLE 里那个非齐次项 $\xi(t)$,它最大能占到响应的 128%。记忆核是按平衡涨落标定的,标定时假定 $\xi$ 服从平衡统计;而干预恰恰是在挑 $\xi$。这就是 T101 里那个初值关联项——记忆模型能算对环境的滞后,算不对你把环境放在了哪个初值上。
不是线性假象:非线性与离散随机两个对照
以上全是线性系统,需要排除「这只是线性化的产物」。
三次非线性。 在 $\dot x=-Ax-cx^3$ 上重做。非线性会改掉宏观衰减律本身,所以不能再拿 $e^{-\lambda_1t}$ 当尺子;照建模者真实的做法来:跑一批自由演化轨道、扔掉暂态,把 $(M,\dot M)$ 拟合成一条单变量律 $\dot M=-aM-bM^3$,再拿它去预测。
| $c$ | 拟合出的 $a$ | 拟合出的 $b$ | 自由演化残差 | 实现间倍数 | 最坏实现偏差 | 与自由演化误差之比 |
|---|---|---|---|---|---|---|
| 0 | 0.0500 | −0.0002 | 1.4% | 10.2 | 0.902 | 64 |
| 0.01 | 0.0502 | 0.0993 | 1.7% | 6.9 | 0.854 | 51 |
| 0.05 | 0.0501 | 0.5004 | 2.1% | 4.0 | 0.743 | 36 |
| 0.2 | 0.0501 | 2.006 | 2.3% | 2.3 | 0.550 | 24 |
拟合出的线性系数一路等于 $\lambda_1=0.05$,三次系数与设定的 $c$ 成正比,说明拟合本身是对的。非线性开到最大时,宏观律在自由演化上只差 2.3%,同一宏观标签的不同实现却仍差 2.3 倍,最坏的一个偏 55%——是自由演化误差的 24 倍。
实现间的倍数随非线性变小,原因要说清楚:三次阻尼把所有轨道压向同一条包络($x\to1/\sqrt{2bt}$,与初值无关),不是因为宏观模型变得能指导干预了。绝对偏差与自由演化误差的比值始终在几十倍上。
还有一笔必须记下:$\delta\propto r_1$ 的偏差从 9.9e−4 涨到 3.6e−2。非线性下「一致的实现」是随振幅跑的,线性时那个一劳永逸的方向不再存在。这是本文结论在非线性方向上的一个实质削弱,不是补强。
离散随机链。 换一套完全不同的数学:6 个微观态分成两块,宏观变量是处在第一块的概率,块内快混合、块间慢跃迁。宏观模型是标准的两态链(含回流),速率取准平稳条件分布下的平均出块速率。第一块三个态的出块速率是 0.10、0.02、0.60,彼此相差 242%——严格可归并(Kemeny–Snell)要求它们相等,这里不等。
把块内速率整体放大来扫时标分离:
| 块内速率倍数 | 自由演化误差 | 实现间最大差 | 比值 |
|---|---|---|---|
| ×1 | 0.00840 | 0.05490 | 6.5 |
| ×3 | 0.00290 | 0.02050 | 7.1 |
| ×10 | 0.00090 | 0.00640 | 7.1 |
| ×30 | 0.00030 | 0.00210 | 7.0 |
时标分离越好,两态链在自由演化上越准;但「把系统置于第一块」的几种实现之间的差距并没有跟着一起消失,比值在 30 倍的扫描范围内稳定在 7 左右。这正是 s1 的 AIC:两个微观态能不能并成一个宏观态,看的是它们的下游影响,不是宏观标签。
线性连续那套结论在离散随机链上原样成立,可见它来自「宏观标签定不住微观态」这件事本身,而不是某种线性构造。
边界、反例与可检查的预期
这篇立论所在的系统是构造的。 主体是一个设计好谱的 12 维线性系统,单一随机种子;只有 Krylov 维数那一条扫了 8 个种子。慢快时标比约 23 倍、$\mathrm{cond}(S)=4.39$ 都是选出来的,换一组参数数值会变。本文声称的是这些量之间的结构关系(分解 $g=\alpha\hat w+g_\perp$、一致条件是 $w$ 为左本征矢、$\varepsilon$-一致维数等于小奇异值个数),不是那些具体数字的普适性。
小球+浴粒子那一节是模型,不是实验。 参数是 Ginot 与 Bechinger 从他们的实验拟合出来的,本文模拟的是那个模型。52 倍、0.318$d$ 这些数是待检验的模型预测,不是实验结果。
协议整形那一节同理,而且隔了一层。 Vaidya 等人的选择性模式压制是在他们自己的体系上实测的;本文把这个计数律在 Ginot–Bechinger 拟合的双浴粒子模型上验证了一遍,这只是与他们报告的结构相容,不是对他们数据的重现。
两篇入口方法论文没有被检验。 s1 的 AIC 与投影抽象、s2 的粒度定理在本文里是取景框,本文构造的是它们的物理实例,既没有复核证明,也没有验证或反驳它们。
非线性只查了一族。 用的是三次阻尼。中途试过保能量的非线性(Lorenz-96 型),发现它会产生非平凡吸引子($M$ 收敛到 3.468 而非 0),慢流形那套语言在那里就不适用了——这一类没有覆盖。更重要的是,非线性方向上的结果是削弱本文结论的:$\delta\propto r_1$ 的偏差随非线性涨到 3.6e−2,线性时那个一劳永逸的一致方向在非线性下不存在,只剩「对这个振幅而言的一致方向」。
预算那条依赖成本模型。 可达区间用的是 $\ell_2$ 范数当代价。换一种代价(比如按分量计费、或只有若干分量可动),可达集合的形状和「宏观预测在不在里面」的结论都会变。
「一致方向恰好一维」是通有情形。 前提是本征值互异。谱简并时这个维数会更高,本文没有覆盖。
$\varepsilon$-一致维数那个数偏宽松,正文已经说明:它量的是单位范数 $\delta$ 的绝对偏差,而宏观效果小的方向天然便宜。$v_1$ 与 $w$ 夹角余弦 0.9018 这个数就是提醒。
几条可以去检查的预期:
- 小球+浴粒子上做两种「挪 $d$」。 用 Ginot–Bechinger 那套参数,光镊只踢小球与整体平移(挪陷阱使小球和近邻一起走)在 $t=1$ s 的位移应差约 52 倍;两条完整曲线在
bead_bath_implementations.csv里。若实测两者在误差内相同,本文这一节的图像在该体系上就不成立。 - 宏观标签为零的操作。 只挪浴粒子而不动小球,宏观模型说小球不动,本文预期 $t=1$ s 时小球走 0.318$d$。
- 该记的那一个数。 若要给宏观描述补一个标量,记慢模左本征矢投影 $l_1\cdot\delta$,而不是推动幅度或推动位置:前者让晚期响应精确,残差只剩在快模寿命之内(本文 $t\approx1$ 处 0.125);后者几乎没用(0.641 对 0.805)。
- 时间整形的计数律。 单点致动器切成 $m$ 段,末态落在非慢模上的比例应随 $m$ 下降,而精确为零要等到 $m\ge N$。若某个系统里 $m<N$ 就精确为零,说明该系统的驱动能达空间真的低维,那是一个可以独立验证的强结论。
- 两个模型各配一种实现。 凡是 $A$ 与 $\Sigma$ 都已知的系统,按自发涨落标定的宏观模型精确描述的实现是 $\delta\propto\Sigma w$,而精确可归并意义下一致的是 $\delta\propto r_1$;两者一般不同(本文 2.29°,小球系统里分别是浴粒子挪 1.000$d$ 与 2.805$d$)。这是一条可以在任何已知线性响应的系统上直接验算的命题。
数据与代码
复算脚本 research/calculations/prediction_versus_intervention.py,输出在 research/assets/2026-09-20-prediction-versus-intervention/(results.json 与若干 CSV、3 张图)。随机种子全部固定。原始文献在 evidence/2026-09-20-prediction-versus-intervention/。