先说要交回什么
“延长两倍寿命”“减少物理元件”“提高条件保真度”各自都可能成立,但并不自动回答同一个使用问题。若一项结果从已经编码好的态开始,另一项从裸比特开始;若一项丢掉失败轨迹,另一项必须处理每次输入;若一项记录每轮错误,另一项记录每单位时间精度,直接排列数字就会把任务差异当成保护优势。
本篇选择一个可完整核算的任务:在$t=0$收到一个未知物理量子比特,它可以与外界参考系统纠缠;在共同截止时间$W$交回一个物理量子比特,目标是恒等通道。保护方案必须完成准备、编码、存储和解码,不能把中间逻辑态的质量直接当作最后交付质量。
只比较这个任务下能匹配的有限方案:共用三数据比特和一个四能级辅助的连续修复、分段耦合—复位,另列不持续修复的编码与裸比特基线。模型承接自主修复及受保护操作的机制,新增物理输入输出、有限准备和两项预算下的比较;不把不同硬件平台或前七篇的全部指标排成总榜。
用完整输出通道验收
令$\mathcal E$为实际物理输入到输出的通道,取参考比特与输入的Bell态$|\Phi\rangle$。采用纠缠保真度
它同时检查两种逻辑基底及相干,不允许只凭0、1读出正确便宣称未知量子态保住了。本库逐个计算完整$4\times4$输出Choi矩阵并检查完全正性与保迹,保存关键比较点的矩阵及全部候选的通道指标。3
在本任务的单比特保迹输出下,均匀纯态平均保真度为
这是平均量,不是最差输入的保证;本文也用六个实际输入态交叉核这个关系。若改为有丢弃结果的条件输出或增加失败旗标,不能不核维数与通道条件便沿用同一换算。3
这里每次输入都会产生输出,交付概率为1,错误全部留在输出态里。这个“没有弃样”不表示每次输出都正确,更不把$F_e$称为成功概率。未知输入一旦损坏,不能默认重新准备同一输入再试。
准备与解码也属于任务时间
两个额外数据比特和辅助最初独立处于最大混合态。未知输入到达后,额外数据以速率$\eta=40$复位;辅助的三个激发能级也以同一速率回到基态。准备持续$\tau_p$,其间未知输入仍受噪声作用。无修复编码不需要辅助,省掉对应准备和资源,不强迫基线消耗无用辅助。
三个数据比特始终有独立噪声
额外数据的激发概率在准备后为
辅助的总激发概率为$\tfrac34e^{-\eta\tau_p}$。更长准备减少残余错误,却也让未知输入裸露更久;“纯辅助已经备好”因此不是同一任务的免费起点。
编码使用CNOT$0\to1$及$0\to2$,把理想输入映到$|000\rangle,|111\rangle$。解码使用逆序两个CNOT,再作以1、2为控制、0为靶的Toffoli门,最后求迹掉其余数据与辅助。四种无错或单$X$错误类别都经这个明确电路恢复,无需借一个未计成本的末端综合征神谕。
模型把CNOT时长设为0.02、Toffoli设为0.04,编码解码总时长0.12。每段先演化相应时间的白噪声,再施加理想门及均匀非恒等Pauli门错;双比特门错率0.001,三比特门错率0.002。这是明确的离散门通道,不是门内连续脉冲的器件模拟。Toffoli视为给定三比特门,尚未编译到特定原生门集。
存储核心可用时间为
所有数值以自选时钟单位表示,不是实际设备的秒数或门性能估计。
同一辅助怎样连续修复,怎样分段修复
设$R_j$把对应的单翻转错误送回两个码字,且不分辨未知逻辑标签。例如
另两项分别处理另外两个数据位。辅助有$|0\rangle_A,|1\rangle_A,|2\rangle_A,|3\rangle_A$四个能级,条件耦合为
复位跳为
耦合把错误送回码空间,同时把错误类别移到辅助;复位再移走辅助记录。共享路径保留未知逻辑相干,原始理论给出这种条件修复代数。本文的四能级辅助是透明有限模型,不是原离子装置的全部能级与运动模式。1
连续方案在存储阶段同时开启耦合与复位。分段方案交替等待、耦合和有限复位,允许改变脉冲面积、复位持续时间及开始时刻;截止时不足一个周期的部分也实际演化。两者都保留跨段辅助状态,没有在每轮开始偷偷把辅助设回基态。
快复位不一定意味着快修复。辅助尚未接收错误时,过强复位可抑制相干转移;不同任务时长也可能需要不同参数。原始补充材料同样把有效修复之外的泄漏、强驱动修正及时间相关优化分开,不能把一个有效率当任意可增加的免费旋钮。2
本库假定上述条件耦合已经可用,再比较它的时序与有限复位。工程出这一多体相互作用的微观装置成本仍未给定,故结果不能外推为平台优劣或整机效率。
两项预算分别限制,不能换成一个总分
给两个主动方案相同的峰值上限$g\leq10,\gamma\leq40$,并分别限制
第二项包含辅助准备,不能把复位容量全留给存储、同时免费得到纯辅助。无辅助的编码基线没有这项支出。两个额外数据的准备也列出,两个复位通道的强度积分总计不超过16。
$B_g$和$B_r$是本模型明示的两个控制容量,按各自上限判断可行性,不相加、不换算成主观分数。它们也不是焦耳:耦合幅度、通道开通积分与实际散热之间还缺装置标定。
另记录辅助在存储阶段实际平均复位事件数
以及末辅助激发概率。复位通道一直开着,不表示每一刻都发生一次真实复位事件;控制容量、事件通量和能耗是不同账。
任务只处理一次未知输入,不宣称资源在截止时已经可供下一条消息无成本复用。重复服务还需要对残余辅助、其他数据和准备节奏另行验收,不能把单次$W$直接改称长期吞吐率。
裸基线为什么不能故意选差
裸比特在相同截止时间下的完整纠缠保真度可解析求得:
未知输入已由任务给定,不能为裸方案挑一个特别脆弱的纯态、再给编码方案挑稳定态。任何固定的单位编码基变换及其逆变换都不改变这里的$F_e$;Pauli回波只改变白噪声跳算符的符号,也不改变其耗散通道。本库核完整裸通道及这些相关基线变化。
此外优化“编码但不持续修复”的准备时长,给它省掉未使用的辅助;不能把主动修复的额外成本硬塞给这个基线。更一般的适应测量、其他编码、非Markov噪声或任意控制不在这组裸基线的最优性声明内。
后续结果须同时检查:同一任务质量是否改善、是否满足两项控制上限、为此增加哪些自由度,以及哪些条件变化会改变结论。
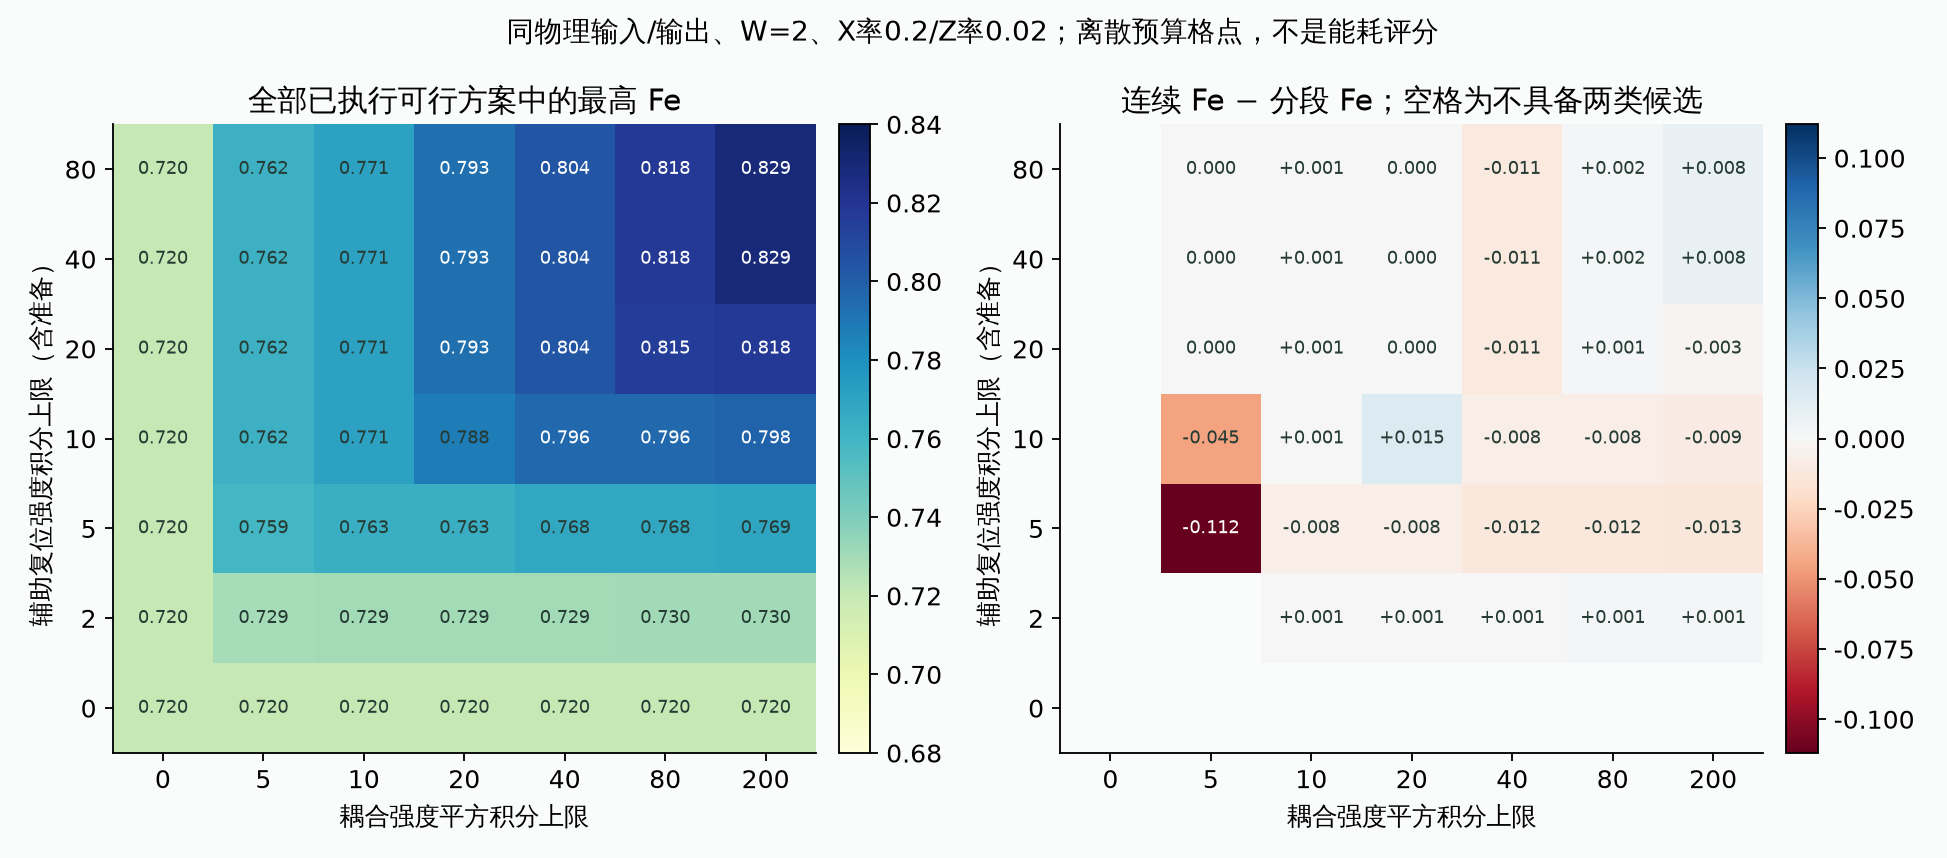
同预算下的差异,有时小于一个粗网格造成的偏差
本库先执行22,272个离散候选,再对五个关键预算点同时细化连续与分段方案。连续方案优化耦合及复位速率,分段方案还优化脉冲面积、复位曝光、等待和初始时刻;准备时长在0.02、0.05、0.1、0.2中选择。最终共执行38,191个候选,形成784个双预算组合的可行包络。
100次局部细化中85次报告收敛;另15次保留实际执行的可行候选,不把未收敛称为找到最优。以下“最好”均指已执行且满足相应上限的候选,不是任意控制策略的全局保证。
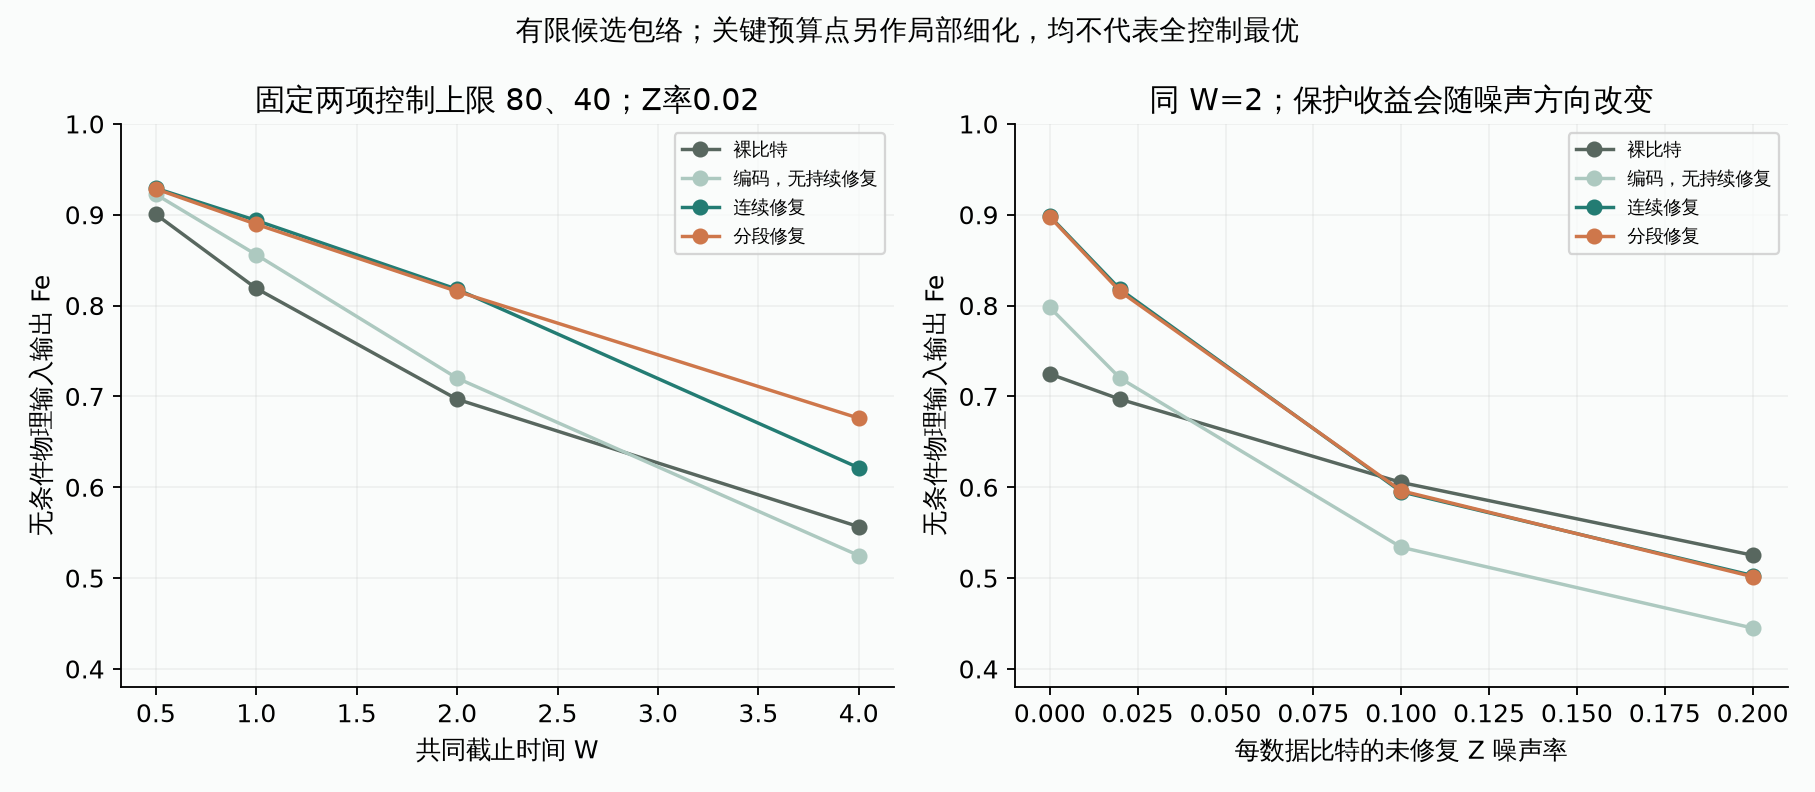
取$\kappa_Z=0.02$,输出质量如下:
| 截止$W$ | $B_g$上限 | $B_r$上限 | 裸比特$F_e$ | 编码无持续修复 | 连续修复 | 分段修复 |
|---|---|---|---|---|---|---|
| 0.5 | 20 | 20 | 0.900362 | 0.922288 | 0.928423 | 0.928043 |
| 2 | 20 | 20 | 0.696807 | 0.720017 | 0.792440 | 0.792610 |
| 2 | 80 | 40 | 0.696807 | 0.720017 | 0.817825 | 0.815544 |
同资源上限不要求每个方案用光额度。第二行的连续候选使用$B_g=20,B_r=14.616639$,分段候选使用约20和15.546699。两者质量只差约0.00017,而资源使用也略不同,适合解释条件,不能据此宣布一种控制方式普遍较好。
这一点还经受了数值搜索的检验:粗网格在第二行给出连续0.770899、分段0.779842,细化后的差距明显缩小。遗漏预算边界附近的连续参数,会把搜索不足误读成方案劣势。数值优化方法和未收敛情况因此也是比较的证据范围。
第三行的连续候选取准备0.1、$g=6.704015,\gamma=12.870210$;其耦合容量达到80,辅助复位容量使用26.908974,并未用到40。更高的允许复位速率不必全用,有限相干转移与复位需要配合。
达到共同质量,需要哪些额外资源
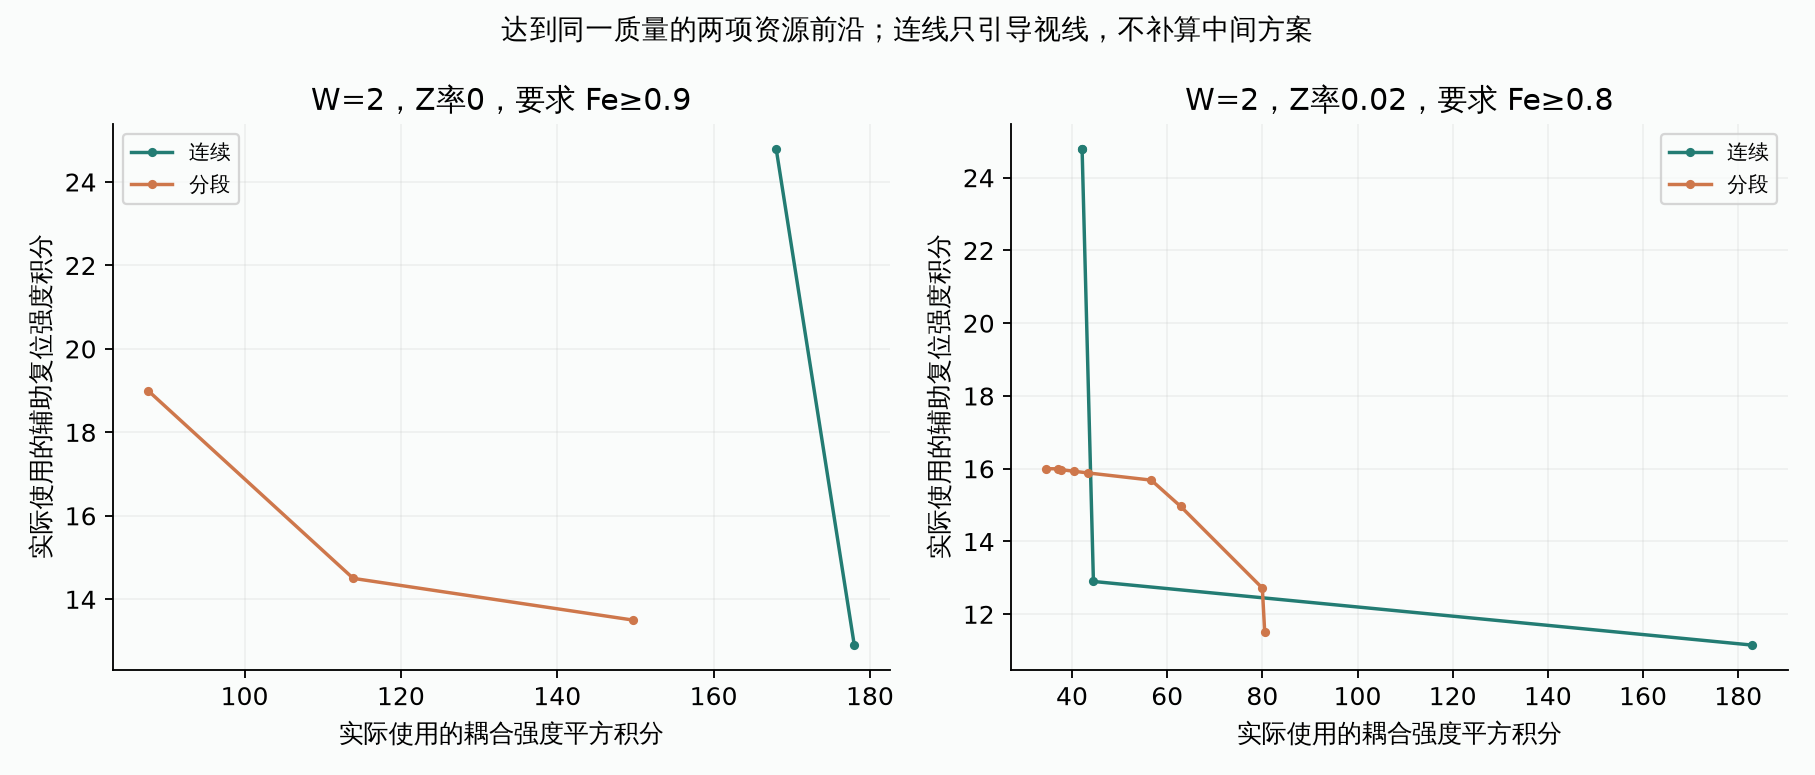
另一种问法是先指定质量门槛,再寻找满足它的资源组合。下面固定$W=2$,每行给一条实际执行的可行路径:
| 相位噪声$\kappa_Z$ | 要求 | 方案 | 实际$F_e$ | 耦合积分 | 辅助复位积分 |
|---|---|---|---|---|---|
| 0 | $\geq0.9$ | 连续 | 0.903728 | 168.000000 | 24.8 |
| 0 | $\geq0.9$ | 分段 | 0.901778 | 87.646018 | 19.0 |
| 0.02 | $\geq0.8$ | 连续 | 0.800345 | 42.000000 | 24.8 |
| 0.02 | $\geq0.8$ | 分段 | 0.800255 | 34.567755 | 16.0 |
每条路径还使用三个数据比特、一个四能级辅助及四CNOT、一Toffoli;裸方案只需一个数据比特。表内不是所有资源最优解,而是达到门槛的可核实例。完整输出保留114个质量门槛下的两项资源前沿点:减少耦合与减少复位未必沿同一方向,不能挑一条路径就把其他折中抹掉。
在$\kappa_Z=0$、$W=2$时,裸比特$F_e$为0.724664,所扫编码无修复也未达到0.9;两个修复族中存在达到门槛的候选。在这组峰值和准备条件的全部已执行候选中,没有$W=2$、$F_e\geq0.95$的方案。后一句是搜索范围内的缺口,不是所有编码或控制都不可能的定理。
当$\kappa_Z=0.02$时,所扫候选可以跨过0.8,却未跨过0.85。改变门槛,问题会从“哪个数更高”变成“已有资源能否交付所需任务”。质量门槛也应由使用目标给定,不能只选择有利于某个方案的一条。
未修复的错误可以让收益方向改变
同一个重复码修复$X$错误,却不修复$Z$错误。三个数据位都可能积累逻辑相位扰动,更多数据不只带来冗余,也带来新的噪声入口。一次双翻转还可能被多数恢复送入错误逻辑类;回到码空间不能代替完整量子质量。
固定$W=2,B_g\leq80,B_r\leq40$,把每数据位的$\kappa_Z$从0.02提高到0.2,细化后的结果为:
| 方案 | 完整$F_e$ | 仅0、1基态的读出正确率 |
|---|---|---|
| 连续修复 | 0.502771 | 0.910341 |
| 分段修复 | 0.501483 | 0.908005 |
| 裸比特 | 0.525139 | 0.724664 |
编码方案明显更好地保存了这个经典基底,却保留了更少的完整未知量子信息。对题设的未知量子存储任务,裸方案在所扫候选中更合适;若任务改为只存一个已知经典基底,评价又会改变。这是任务与噪声条件共同决定的结果,不是编码一般无效。
控制容量、实际事件和下一次使用要分开
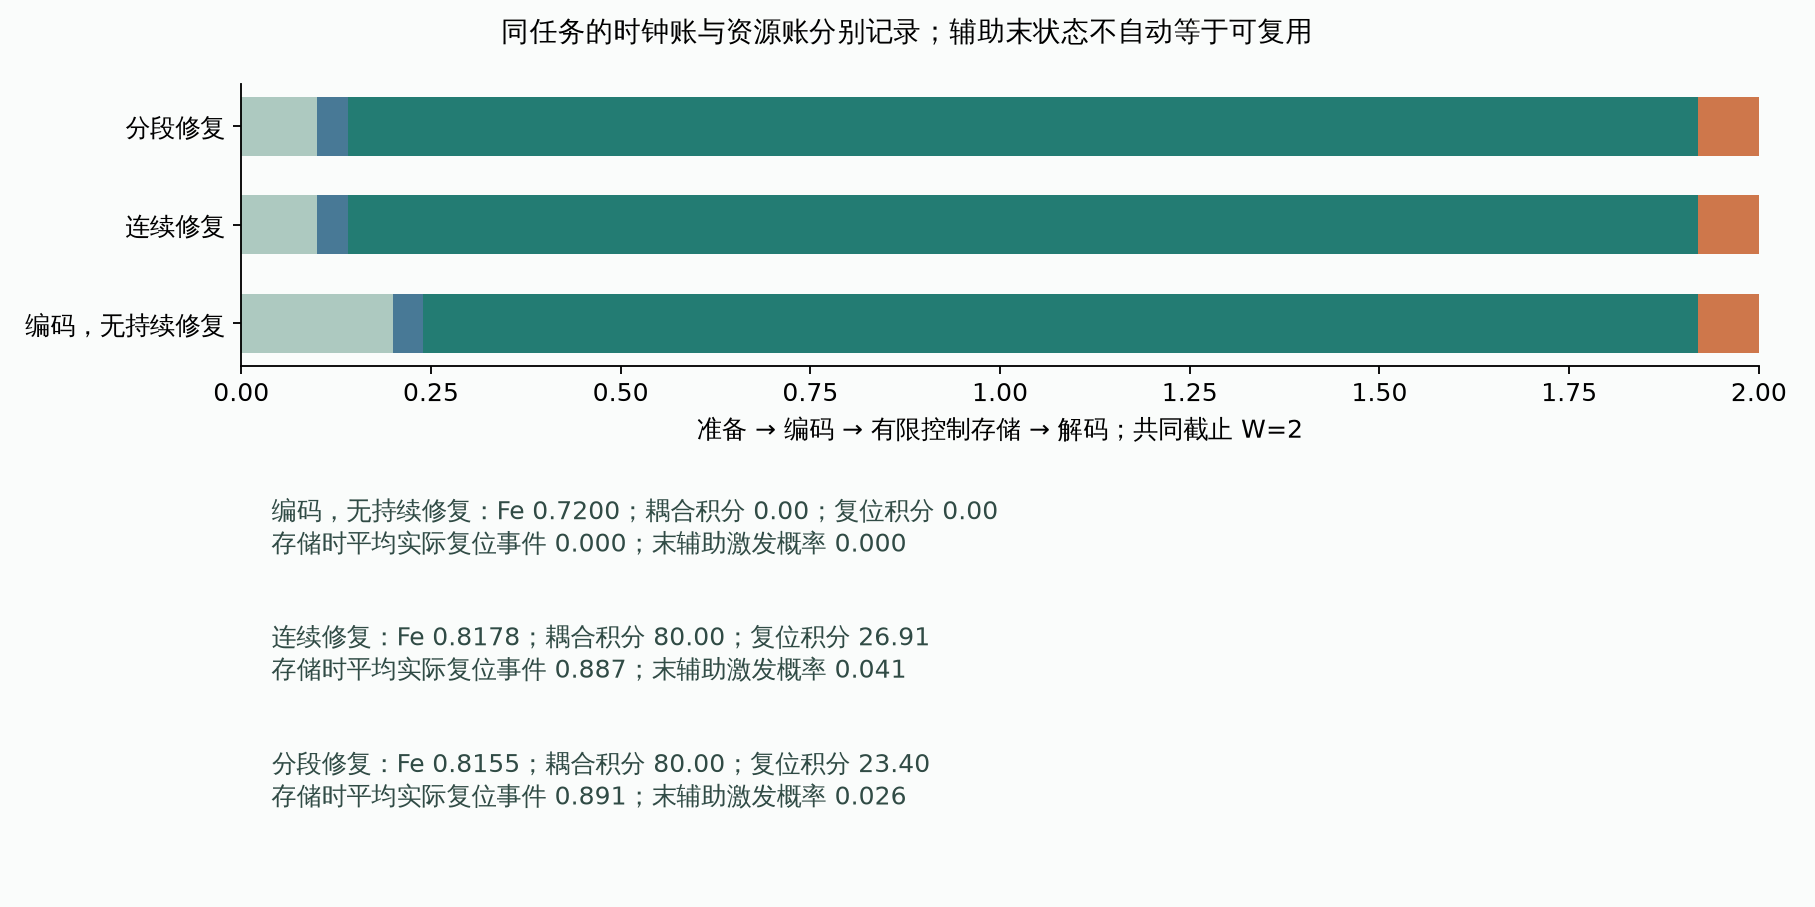
在$W=2,\kappa_Z=0.02,B_g\leq80,B_r\leq40$的连续候选中,辅助复位容量使用26.908974,存储期间实际平均复位事件却约为0.886888,末辅助激发概率约为0.041439。它们数值不同,是因为前者计算通道开放强度,后两者还依赖辅助实际占据。
对应分段候选的三项数为23.401411、0.890757、0.025606。较少通道开放积分不自动意味着较少实际复位事件;末态更接近基态也不自动完成所有其他工作自由度的清理。
两个方案都在0.1准备、0.04编码、1.78存储和0.08解码之后交回输入。准备阶段还有额外数据与辅助的实际复位事件,已另列在结果中。本文没有把存储阶段的事件数冒充整段热耗散,更没有补成整机焦耳数。
前七篇的结果,怎样接入这种比较
本模型只为能匹配的有限存储方案提供一个实例。其他保护机制需要先补齐各自的对应关系:
| 入口 | 比较前要对齐的条件 |
|---|---|
| T133 被动热保护 | 热浴、温度、能量及错误路径、编码与终恢复定义;不能给有能隙方案自动更低的错误率,却把这个变化从资源账删去。 |
| T134 自主修复 | 共享恢复是否保留逻辑相干,耦合、复位、额外噪声及辅助末态;有效修复率须回到实际生成过程。 |
| T135 玻色编码 | 平均与允许激发数、损失、稳定驱动、两种逻辑错误及外层任务;只降低一种错误不能代替完整未知态比较。 |
| T136 错误侧信息 | 同一底层错误与位置告警质量、检测扰动和耗时;条件接受样本与每次输入的结果分开。 |
| T137 空间实现 | 逻辑任务数、连接与调度、门层及闲置噪声;稀疏矩阵元件数不直接等于执行成本。 |
| T138 逻辑操作 | 相同输入、逻辑作用与实际输出,辅助、传播和物理恢复;追加理想检查后的上界不冒充当前交付。 |
| T139 纠错传感 | 同一参数定义、局部先验、完整记录、读出及总实验时间;计量FI和存储保真度分别回答问题。 |
“没有持续修复的编码”也不能直接改称热自纠错。本文噪声是给定速率的Markov通道,没有替它加入低温能量抑制。被动热保护、玻色驱动、长程硬件和传感资源尚无可信的共同标定时,保留不可比范围比换标题排列寿命更有用。
较稳的比较动作是:固定可回答的输入输出任务,构造完整通道,列出允许资源,再改变最可能使结论反转的条件。本篇实际找到的有限收益与无收益都依赖这些条件,不提供跨任务或跨平台的总体裁决。
复算、自审与仍未解决的部分
复算顺序为生成有限候选、关键预算细化、科学核验,最后运行绘图。结果目录保存输入范围、38,191个实际候选、784个预算组合、256项质量门槛查询及114个资源前沿点;细化记录保留未收敛情况。
155项作者核验包括完整32维物理主方程与不变算符子空间、混合态资源的有限准备与事件积分、所有门Pauli分支、独立密矩阵ODE、实际输出Choi与六输入平均保真、裸基线、逐项预算及前沿。简化仅利用已逐项核为封闭的算符子空间,没有删掉错误能级或辅助分支。
来源原件、版本和读取范围分别记录;原离子微观模拟未复现,Nielsen采用固定作者v2而非宣称与正式版逐字相同。以上是Codex作者自审所用证据,不是独立评审。
仍未解决的部分包括:真实原生门与条件多体耦合的装置成本、控制引入的其他噪声、不同编码和适应控制的更优方案、最差输入质量,以及重复服务中的清理和长期吞吐。两项控制容量未被标定为总能耗。这些边界限制外推,也留下下一轮可以具体补证的任务。